

AnimateDiff · 基于 Stable Diffusion 的即插即用动画运动模块 · 中文部署与使用全指南
项目仓库: https://github.com/guoyww/AnimateDiff
开源协议:Apache 2.0(仓库 LICENSE.txt) ·
开发语言:Python(PyTorch / Diffusers / Gradio) · 论文:ICLR 2024
Spotlight,arXiv:2307.04725 ·
环境:main 分支面向 Stable Diffusion
V1.5,sdxl 分支面向 SDXL beta · WebUI:Gradio(默认
localhost:7860) · 模型权重:Hugging Face 仓库
guoyww/animatediff(运动模块 / 适配器 / SparseCtrl)与
guoyww/animatediff_t2i_backups(社区基础大模型备份) ·
输入:文本提示词,可选社区大模型、LoRA、MotionLoRA 相机运动与 SparseCtrl
稀疏条件图 · 输出:samples/ 目录下 GIF 动画网格,Gradio
界面内输出 MP4
1 项目简介
AnimateDiff 是论文 AnimateDiff: Animate Your Personalized Text-to-Image Diffusion Models without Specific Tuning 的官方开源实现,论文被 ICLR 2024 收录并获得 Spotlight 评价。官方一句话定位:一个即插即用(plug-and-play)的运动模块,可以把多数社区文生图(Text-to-Image)模型扩展为动画生成器,不需要对图像模型做额外训练。
项目的核心思路是把"空间外观"与"时间运动"解耦:冻结预训练文生图模型的图像层,在 UNet 中插入可学习的时间注意力(Temporal Transformer)运动模块,从视频数据中学习可迁移的运动先验;推理时把运动模块挂载到任意社区 SD 大模型上,即可在保留该模型画风的同时生成一段连贯动画。配套的 MotionLoRA 用于在运动模块上高效适配变焦、平移、俯仰、旋转等特定相机运动;SparseCtrl 则提供少量 RGB 图像或涂鸦(scribble)作为稀疏条件,进一步控制动画内容。
非官方声明:本文依据官方仓库
main分支 README、requirements.txt、configs/下推理与提示词配置、app.py、scripts/animate.py、animatediff/utils/util.py,以及sdxl分支 README 整理部署步骤;项目为学术研究代码,官方未承诺打包好的在线服务与商业 SLA,效果、稳定性与硬件表现以仓库最新版本为准。README Disclaimer 明确:本项目面向学术使用(released for academic use),官方不对用户生成内容承担责任;官方唯一站点为https://github.com/guoyww/AnimateDiff与https://animatediff.github.io/,其余网站均与官方无关。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | AnimateDiff |
| 仓库地址 | github.com/guoyww/AnimateDiff |
| 项目定位 | 即插即用的 Stable Diffusion 运动模块,将文生图模型扩展为文生动画 / 图生动画生成器 |
| 开源协议 | Apache 2.0(仓库 LICENSE.txt) |
| 论文 / 出处 | ICLR 2024 Spotlight,arXiv:2307.04725;配套 SparseCtrl 论文 arXiv:2311.16933 |
| 开发语言 / 框架 | Python、PyTorch 2.3.1、Diffusers 0.11.1、Transformers 4.25.1、xFormers 0.0.27、Gradio 3.36.1 |
| 基础扩散模型 | main 分支:Stable Diffusion V1.5(默认
runwayml/stable-diffusion-v1-5);sdxl
分支:Stable Diffusion XL 1.0 beta 运动模块 |
| 输入 | 文本提示词 + 负面提示词;可选社区大模型、LoRA、MotionLoRA、SparseCtrl RGB / scribble 条件图 |
| 输出 | CLI:samples/<配置名>-<时间戳>/sample/*.gif
与汇总
sample.gif;WebUI:samples/Gradio-<时间戳>/sample/<序号>.mp4
与 logs.json |
| 部署方式 | 源码 pip install -r requirements.txt;官方 Gradio 界面
python -u app.py;CLI 配置驱动推理;Diffusers
官方管线(第三方集成入口,见第 7.5 节) |
| WebUI 端口 | Gradio 默认 7860(app.py 调用
demo.launch(share=True),README 注明默认运行在
localhost:7860) |
| 模型权重渠道 | Hugging Face:guoyww/animatediff、guoyww/animatediff_t2i_backups;SDXL
运动模块另提供 Google Drive / CivitAI 渠道 |
| 系统入口 | WebUI:python -u app.py;CLI:python -m scripts.animate --config <yaml> |
| 代码基础 | 仓库 Acknowledgements 注明代码基于 Tune-a-Video 构建 |
1.2 适用场景
- 在本地或自有服务器上把现有 Stable Diffusion 1.5 社区大模型(写实、动漫、胶片、卡通等画风)扩展为短动画生成器,复现 ICLR 2024 论文的运动先验方法。
- 通过 MotionLoRA 为动画指定相机运动:推近(ZoomIn)、拉远(ZoomOut)、左移(PanLeft)、右移(PanRight)、上仰(TiltUp)、下俯(TiltDown)、顺时针旋转(RollingClockwise)、逆时针旋转(RollingAnticlockwise)。
- 通过 SparseCtrl 用少量 RGB 关键帧或涂鸦草图控制动画画面内容,做关键帧引导与草图到动画的研究实验。
- 作为 Stable Diffusion WebUI 扩展或 ComfyUI 节点接入既有绘图工作流(官方 Related Resources 列出社区维护集成,见第 4 章与第 7.5 节)。
- 复现 v1 / v2 / v3 三代运动模块与 SDXL beta 运动模块的推理对比,研究运动先验在不同分辨率、不同基础模型上的表现。
- 在自研扩散模型流水线中参考其时间注意力模块(
Vanilla运动模块、膨胀 GroupNorm、零初始化投影层)与三阶段训练方案做二次开发。
1.3 能力边界(官方口径)
- 基础模型兼容范围:
main分支代码与模型面向 Stable Diffusion V1.5;Stable Diffusion XL 需切换到sdxl分支并使用mm_sdxl_v10_beta.ckptbeta 运动模块,两套环境、配置与权重不可混用。 - 画面闪烁:官方 v3 Limitations 第 1 条明确指出画面存在可感知的小幅闪烁(Small flickering is noticeable),属于当前模型的已知现象。
- 通用文生视频质量:为保持与社区模型兼容,项目没有为通用 T2V(Text-to-Video)做专门优化,在该设定下视觉质量有限(官方 Limitations 第 2 条)。
- 风格对齐:官方 Limitations 第 3 条建议,在做图像动画 / 插值(image animation / interpolation)类使用时,优先使用由同一社区模型生成的图像,以保证画风一致。
- SDXL 分辨率与采样:
sdxl分支 README 提示 SDXL 在低分辨率图像上质量通常较差,应使用推荐高分辨率;画质强烈依赖采样器与采样步数(官方示例使用 EulerDiscrete 采样器 100 步);各类个性化 SDXL 模型的超参数经过专门调校,需要在官方推荐值上略作调整。 - 学术使用定位:README Disclaimer 注明项目面向学术使用,官方不对用户生成内容负责;商用授权、模型版权与对外服务合规需由部署方自行核对。
- 官方 README 未在
main分支公布硬性显存下限、CPU 模式命令行开关与 Windows / macOS 安装细则;本文涉及硬件余量均以官方已公布口径为准,未公布的字段标注"以官方仓库最新说明为准"。
2 功能特性
2.1 解耦的运动先验模块
- 冻结图像层、插入时间注意力:运动模块挂载在预训练 SD UNet 的时间维上,图像空间层保持冻结,画风由所挂载的社区大模型决定,运动由运动模块提供。
- 三阶段训练流水线(README Technical
Explanation,对应图 2):
- 缓解负面影响(Alleviate Negative
Effects):训练域适配器(Domain Adapter,如
v3_sd15_adapter.ckpt)拟合训练数据中的水印等视觉缺陷,同时帮助运动与空间外观解耦;推理时可移除适配器,也可通过 LoRA 缩放系数调节其影响。 - 学习运动先验(Learn Motion
Priors):训练运动模块(Motion Module,如
v3_sd15_mm.ckpt),从视频数据中学习真实世界运动模式。 - (可选)适配新模式(Adapt to New Patterns):训练
MotionLoRA(如
v2_lora_ZoomIn.ckpt),以较小参数量让运动模块适配相机变焦、滚动等特定运动模式。
- 缓解负面影响(Alleviate Negative
Effects):训练域适配器(Domain Adapter,如
2.2 多代运动模块与模型生态
- v3(2023.12):使用 Domain Adapter LoRA 做图像模型微调,推理灵活性更高;同时实现 RGB 图像 / 涂鸦两类 SparseCtrl 编码器,可接受任意数量条件图控制动画内容。
- v2(2023.09):运动模块
mm_sd_v15_v2.ckpt在更大分辨率与批大小上训练,官方称放大训练显著改善运动质量与多样性;支持八种基础相机运动的 MotionLoRA,单个 MotionLoRA 仅约 77 MB 量级存储。 - v1(2023.07):项目首个版本,提供
mm_sd_v14.ckpt、mm_sd_v15.ckpt。 - SDXL-Beta(2023.11):在 SDXL 上发布 beta 运动模块,可在有无个性化模型条件下生成高分辨率视频(如 1024×1024、16 帧,多种宽高比)。
2.3 MotionLoRA 相机运动控制
v2 提供八种基础相机运动
MotionLoRA:ZoomIn、ZoomOut、PanLeft、PanRight、TiltUp、TiltDown、RollingClockwise、RollingAnticlockwise,在
YAML 配置中通过 motion_module_lora_configs 指定权重路径与
alpha 系数挂载,适合固定镜头运动需求的动画片段。
2.4 SparseCtrl 稀疏条件控制
- RGB
图像条件:
v3_sd15_sparsectrl_rgb.ckpt,以少量 RGB 关键帧引导动画画面。 - 涂鸦条件:
v3_sd15_sparsectrl_scribble.ckpt,以草图 / 涂鸦线条引导画面内容。 - 条件图数量不超过动画帧数(
controlnet_images数量受L限制,见scripts/animate.py断言),可通过controlnet_image_indexs指定条件图索引。
2.5 采样与界面能力
- 内置 DDIM、Euler、PNDM 三种调度器(
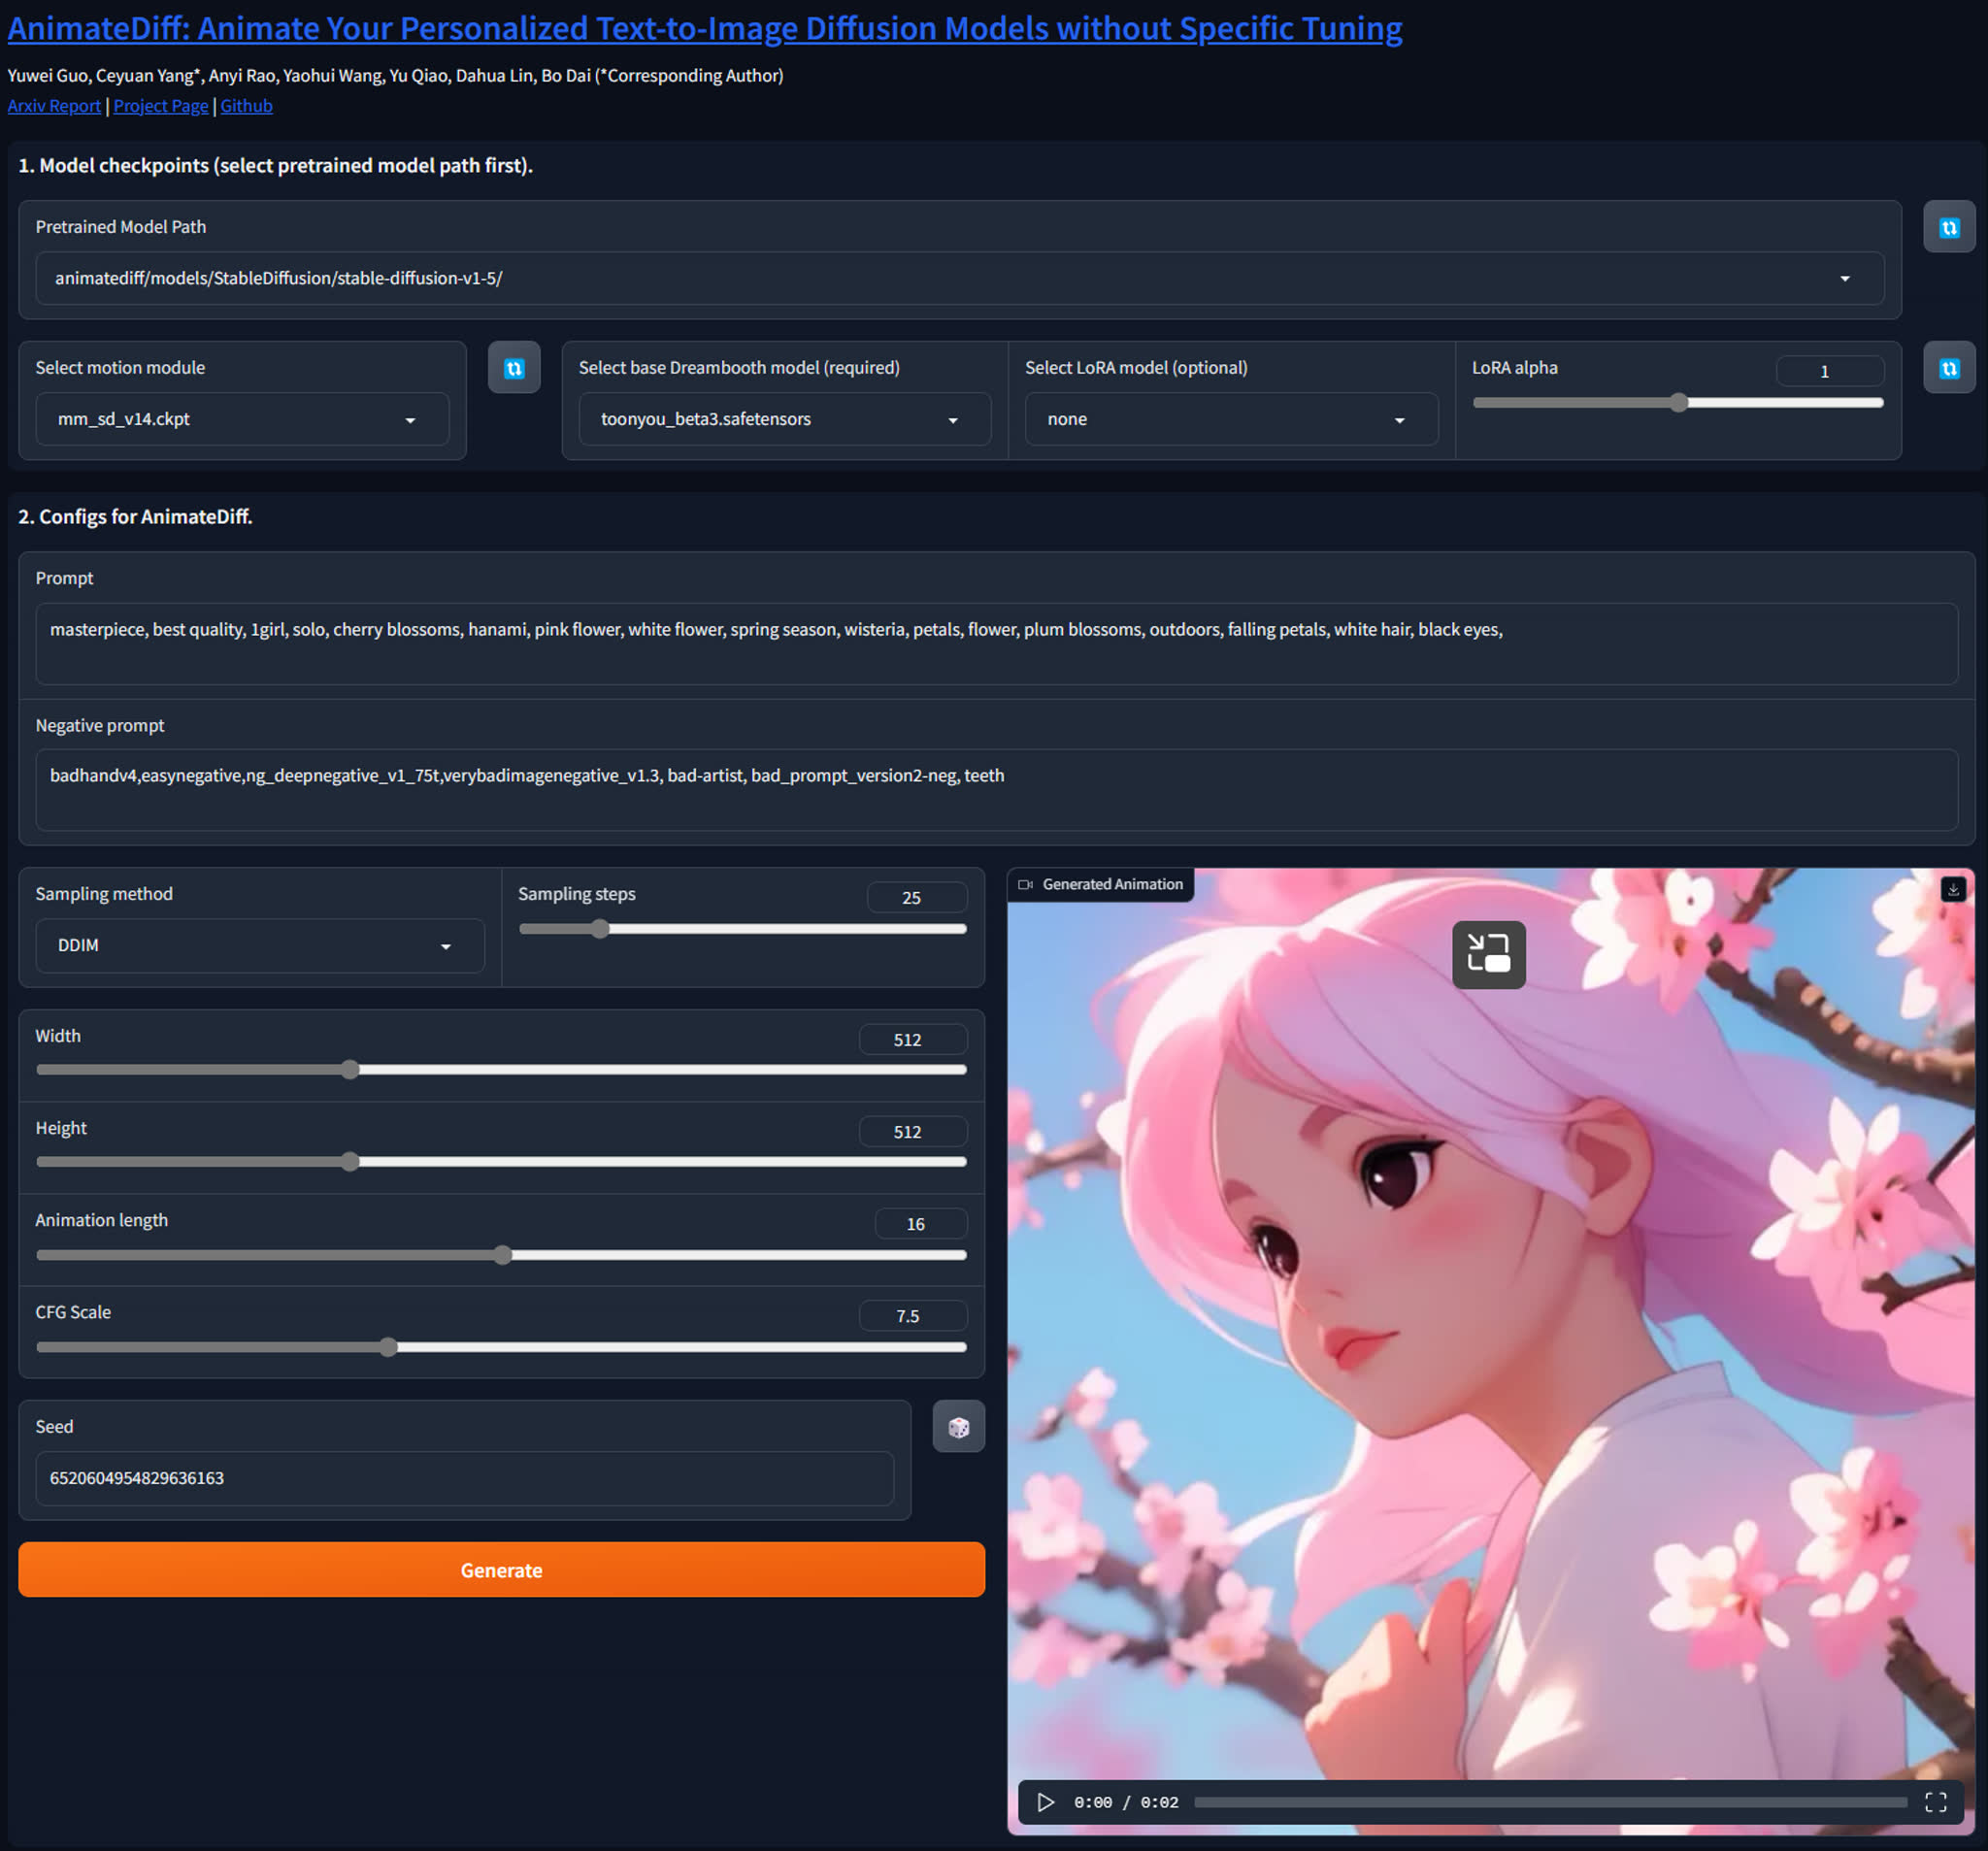
app.py中scheduler_dict),可在 WebUI 下拉切换。 - Gradio 界面提供基础模型、运动模块、社区大模型、LoRA 模型、LoRA alpha、提示词、负面提示词、采样方法、采样步数、宽、高、动画长度、CFG Scale、随机种子等完整控件(详见第 8.4 节)。
- CLI 由 OmegaConf YAML
驱动,一份配置可串联多组模型与多组提示词批量采样,结果自动保存到
samples/并回写config.yaml记录本次实际参数。 - 模型检查点在脚本中自动下载(
auto_download),首次运行无需手动逐个准备权重;本地已有同名文件时直接复用。
2.6 官方 Diffusers 支持
README 注明 AnimateDiff 也由 Diffusers 官方支持,可参考 Hugging Face Diffusers 文档中的 AnimateDiff Pipeline 教程在 Diffusers 生态内调用;本文 CLI 与 WebUI 说明对应本仓库代码路径。
3 官方界面预览
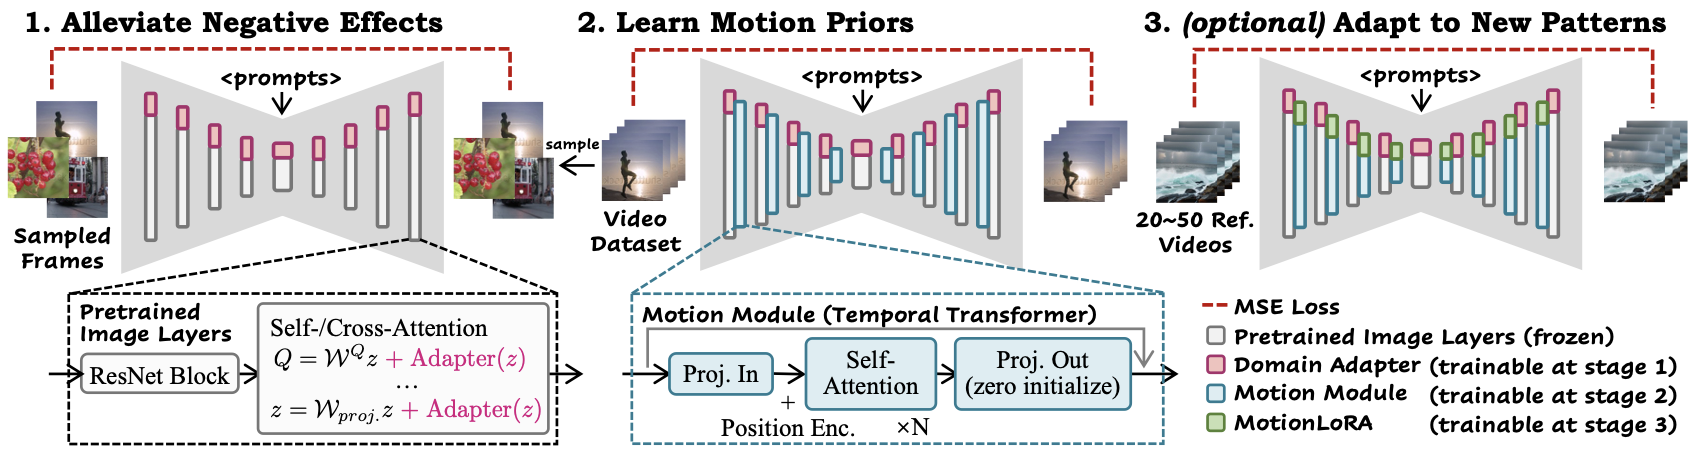
图 2 为 README"Technical Explanation"折叠区给出的三阶段训练流水线示意图:阶段一域适配器(粉色)拟合训练数据缺陷并帮助解耦;阶段二运动模块(蓝色,Temporal Transformer)从视频数据学习运动先验;阶段三 MotionLoRA(绿色)适配特定相机运动。图中同时标注了 MSE 损失、冻结图像层、可训练层与零初始化投影层等结构信息。
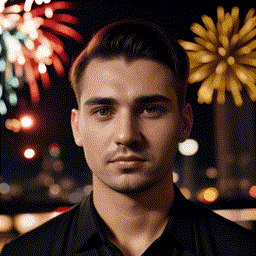
图 3 为 README v3 Demos 中 RGB 条件动画的代表性帧:以夜景人物与烟花关键帧为条件,生成画面与运动保持条件引导。
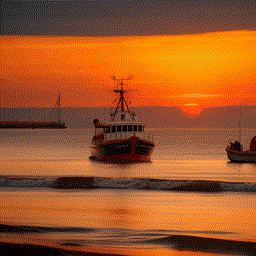
图 4 为另一组 RGB 条件动画帧:日落天空、海面渔船与飞鸟在条件引导下形成连贯海景动画。
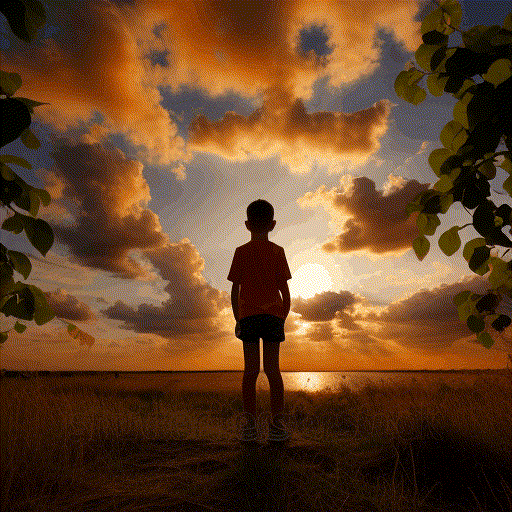
图 5 为 SparseCtrl 涂鸦条件演示:输入人物剪影涂鸦,模型生成黄昏天空下人物立于原野的动画片段。
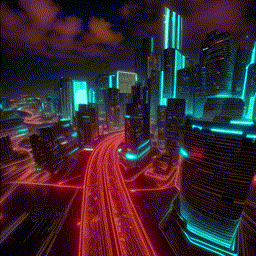
图 6 为另一组涂鸦条件演示:由城市线条草图引导生成霓虹光带贯穿的未来街道动画。
说明:README 内嵌的演示素材均为 GIF 动图;按本指南发布规程,动图已抽取代表性静态帧转为 PNG 后上传展示,实际动画效果以本地运行
python -u app.py或 CLI 生成结果为准。
4 官方跳转链接汇总
下表列出项目相关官方入口与社区集成入口,均可直接点击访问;其中仓库、论文、项目主页、Hugging Face 模型与官方 Demo 为官方来源,社区扩展与 Colab 为第三方维护资源。
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/guoyww/AnimateDiff | 源码、README、推理脚本、Gradio 应用与配置文件 |
| 项目主页 | animatediff.github.io | 官方论文演示站 |
| 主论文 PDF | arxiv.org/abs/2307.04725 | ICLR 2024 Spotlight 论文 |
| SparseCtrl 论文 | arxiv.org/abs/2311.16933 | 稀疏条件控制文生视频论文 |
| SparseCtrl 项目页 | guoyww.github.io/projects/SparseCtrl/ | SparseCtrl 官方演示页 |
| 在线 Demo(HF Space) | huggingface.co/spaces/guoyww/AnimateDiff | 官方在线体验 |
| 在线 Demo(OpenXLab) | openxlab.org.cn/apps/detail/Masbfca/AnimateDiff | README 提供的国内在线体验入口 |
| 模型权重(运动模块 / 适配器 / SparseCtrl) | huggingface.co/guoyww/animatediff | v1/v2/v3/SDXL 运动模块、MotionLoRA、SparseCtrl 编码器 |
| 模型权重(社区大模型备份) | huggingface.co/guoyww/animatediff_t2i_backups | WebUI 下拉中内置的社区基础大模型备份 |
| SDXL 运动模块 Google Drive | Google Drive 分享链接 | mm_sdxl_v10_beta.ckpt 备用渠道 |
| SDXL 运动模块 CivitAI | civitai.com/models/108836/animatediff-motion-modules | 社区模型站分发渠道 |
| Diffusers 官方管线文档 | huggingface.co/docs/diffusers/api/pipelines/animatediff | Diffusers 生态内调用 AnimateDiff 的官方教程 |
| Issues 反馈 | github.com/guoyww/AnimateDiff/issues | Bug 反馈与问题讨论 |
| SDXL 分支 | github.com/guoyww/AnimateDiff/tree/sdxl | SDXL beta 运动模块推理代码与配置 |
| SD WebUI 扩展(社区维护) | github.com/continue-revolution/sd-webui-animatediff | Stable Diffusion WebUI 接入 AnimateDiff 扩展 |
| ComfyUI 节点(社区维护) | github.com/Kosinkadink/ComfyUI-AnimateDiff-Evolved | ComfyUI 工作流节点 |
| Colab Notebook(社区维护) | camenduru/AnimateDiff-colab | 社区 Colab 快速演示 |
| 许可证 | LICENSE.txt | Apache License 2.0 |
5 前置要求与服务器配置
5.1 软件前提
main 分支(SD 1.5,本指南默认路径):
- Git:用于克隆仓库与切换分支。
- Python 3 运行环境:
requirements.txt未在文件内锁定 Python 小版本,建议使用与 PyTorch 2.3.1 兼容的 Python 3.x 版本;具体小版本以仓库最新requirements.txt与 PyTorch 官方兼容矩阵为准。 - PyTorch 与视觉库:
requirements.txt锁定torch==2.3.1、torchvision==0.18.1;安装时需匹配本机 CUDA / CPU 版本的 PyTorch wheel,CUDA 具体版本以 PyTorch 2.3.1 官方发布矩阵为准。 - 扩散模型生态:
diffusers==0.11.1、transformers==4.25.1、safetensors、einops。 - 时间与视频处理:
imageio==2.27.0、imageio-ffmpeg==0.4.9、decord==0.6.0(视频帧解码)。 - 注意力优化:
xformers==0.0.27,用于显存高效注意力;不可用时可通过--without-xformers关闭(见第 10.3 节)。 - 界面与配置:
gradio==3.36.1、omegaconf==2.3.0。 - 实验跟踪(可选):
wandb,训练阶段记录实验用;纯推理不强制登录账号。 - ffmpeg:视频帧编码依赖
imageio-ffmpeg;若系统另装 ffmpeg,需保证可执行文件在PATH中。
sdxl 分支(SDXL beta):
- 切换
sdxl分支后,按该分支 README 使用conda env create -f environment.yaml创建名为animatediff_xl的 Conda 环境;该分支未在 main 仓库根目录提供独立requirements.txt,依赖清单以environment.yaml为准。 - 基础模型:Stable Diffusion XL 1.0
基础模型(
stabilityai/stable-diffusion-xl-base-1.0)通过git lfs克隆到models/StableDiffusion/。
5.2 硬件建议(官方口径与说明)
| 项目 | 说明 |
|---|---|
| GPU | 官方代码默认 .cuda() 部署,推荐 NVIDIA 显卡并安装与
PyTorch 匹配的 CUDA 驱动;app.py 内
device = "cuda" if torch.cuda.is_available() else "cpu"
做了设备判断,但 CLI 脚本默认把 pipeline 放到 CUDA,纯 CPU
可用性与速度以实际运行日志为准 |
| 显存(SD 1.5) | README 未公布 main 分支硬性显存下限;按所选分辨率、帧数、社区大模型规模与是否开启 xFormers 不同而变化,先按第 7 章完成环境后用示例配置实测 |
| 显存(SDXL) | sdxl 分支 README 官方口径:推荐分辨率下生成 16
帧视频通常需要 约 13 GB
显存;采样器与采样步数需按个性化 SDXL 模型微调 |
| 内存 / 存储 | 需容纳基础大模型、运动模块、适配器、MotionLoRA、SparseCtrl 权重与生成中间结果;各权重大小见第 8.5 节 |
| 操作系统 | 官方主要在 Linux 环境测试;Windows / macOS 原生运行未在 README 给出专门安装步骤,以仓库最新说明为准 |
| 磁盘 | 运动模块、社区大模型与 SDXL 基础模型体积较大,建议预留数十 GB 可用空间并放在读写正常的本地磁盘 |
说明:除 SDXL "约 13 GB 显存"外,官方未逐模型公布显存占用、内存下限与采样帧率清单;本节未补充臆造数值。显存不足时按第 10.2 节降低分辨率、帧数与批处理规模,或切换更小的基础模型。
5.3 端口分配
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
| 7860 | Gradio WebUI | Gradio 默认本机 / 局域网 | 浏览器访问本地动画生成界面 |
远程服务器运行 WebUI 时,建议通过 SSH 隧道或带鉴权的反向代理访问 7860 端口,不要把界面不加鉴权地直接暴露到不可信公网。
app.py使用demo.launch(share=True),Gradio 会尝试生成公网临时分享链接;不需要公网分享时可在源码中调整launch参数后再启动。
5.4 目录与模型权重规划
| 目录 | 用途 |
|---|---|
models/StableDiffusion/ |
基础扩散模型目录(SDXL 分支放置 SDXL 1.0 文件夹;WebUI 刷新按钮可扫描该目录子目录) |
models/Motion_Module/ |
运动模块、域适配器与 SparseCtrl 编码器权重 |
models/DreamBooth_LoRA/ |
社区基础大模型备份与自定义 LoRA(.safetensors) |
models/MotionLoRA/ |
相机运动 MotionLoRA 权重(CLI YAML 引用路径) |
models/SparseCtrl/ |
SparseCtrl RGB / scribble 编码器权重(CLI YAML 引用路径) |
samples/ |
CLI 与 WebUI 生成结果、配置快照与运行日志 |
6 方式一:官方 Gradio 一键启动(main 分支本地推荐路径)
容器化现状(如实说明):AnimateDiff 仓库未随附官方 Dockerfile 与
docker-compose.yml,本章不编造 Compose 文件。官方 README 提供的本地最简路径是克隆仓库、安装requirements.txt后直接启动app.py;社区已有的容器化镜像与 SD WebUI / ComfyUI 集成均为第三方维护,不属于官方产物(见第 7.5 节)。
6.1 克隆仓库与安装依赖
git clone https://github.com/guoyww/AnimateDiff.git
cd AnimateDiff

# 建议先创建并激活独立虚拟环境(venv 或 conda,二选一)
pip install -r requirements.txt
requirements.txt
锁定的主要依赖(以仓库最新文件为准):
torch==2.3.1
torchvision==0.18.1
diffusers==0.11.1
transformers==4.25.1
xformers==0.0.27
imageio==2.27.0
imageio-ffmpeg==0.4.9
decord==0.6.0
omegaconf==2.3.0
gradio==3.36.1
safetensors
einops
wandb
6.2 启动 Gradio 演示
python -u app.pyREADME 注明:演示默认运行在 localhost:7860。浏览器打开
http://127.0.0.1:7860(远程服务器按第 5.3
节做端口映射或隧道访问)。
首次启动时 AnimateController 会按默认参数组装
pipeline:基础模型 runwayml/stable-diffusion-v1-5、运动模块
v3_sd15_mm.ckpt、社区大模型
realisticVisionV60B1_v51VAE.safetensors;本地不存在的权重由
auto_download 自动从 Hugging Face
仓库下载,首次运行耗时较长,属于正常现象(README
Note:所有脚本都会自动处理检查点下载,首次执行可能更慢)。
6.3 WebUI 常用操作
- Model Checkpoints 区域:选择 Pretrained Model
Path(默认 SD 1.5)、运动模块、基础 DreamBooth 大模型;可选 LoRA 模型与
LoRA alpha;点击刷新按钮重新扫描
models/目录下本地模型。 - Configs 区域:填写 Prompt 与 Negative
prompt;选择采样方法(DDIM / Euler /
PNDM);调整采样步数、宽、高、动画长度、CFG Scale;种子填
-1表示随机种子,也可点击骰子按钮取随机值。 - 点击 Generate,右侧
Generated Animation区域输出 MP4;结果保存在samples/Gradio-<时间戳>/sample/,本次参数追加写入同目录logs.json。 - 切换运动模块、基础模型或 LoRA 下拉项时,界面会按
app.py的回调重建 pipeline;v2 运动模块自动套用inference-v2.yaml,v3 套用inference-v3.yaml,其他套用inference-v1.yaml。
6.4 远程访问注意事项
- 7860 端口为 Gradio 默认端口;若被占用,可在源码
demo.launch(...)处指定server_port,或以环境变量 / 反向代理方式映射,不要在公网直接暴露未加认证的生成界面。 app.py默认share=True会生成 Gradio 临时公网链接;该链接由 Gradio 服务端托管,有效期与稳定性不由本项目控制,需要固定访问方式时应自行部署反向代理。- 生成结果只保存在本机
samples/目录,公网链接本身不存储用户素材。
7 方式二:源码环境手动安装与 CLI 推理
7.1 main 分支环境安装(官方 README Quick Start)
git clone https://github.com/guoyww/AnimateDiff.git
cd AnimateDiff

# 创建独立虚拟环境后安装依赖
pip install -r requirements.txt
依赖安装完成后,先用内置示例配置跑通一次推理,确认权重自动下载、pipeline 组装与视频写出链路正常。
7.2 模型权重说明与自动下载机制
animatediff/utils/util.py 的 auto_download
函数按权重类型选择 Hugging Face 仓库:
| 权重类型 | Hugging Face 仓库 | 本地目录约定 |
|---|---|---|
| 运动模块、适配器、MotionLoRA、SparseCtrl | guoyww/animatediff |
models/Motion_Module/、models/MotionLoRA/、models/SparseCtrl/
等 |
| 社区基础大模型与备份 LoRA | guoyww/animatediff_t2i_backups |
models/DreamBooth_LoRA/ |
脚本通过
snapshot_download(..., allow_patterns=[filename])
按文件名拉取单个权重;本地已存在同名文件时跳过下载。MOTION_MODULES、ADAPTERS、BACKUP_DREAMBOOTH_MODELS
三个清单在 util.py
中枚举了受支持的文件名,不在清单内的文件名会触发断言错误。
网络无法访问 Hugging Face 时,可按第 4 章给出的 Google Drive / CivitAI 备用渠道手动下载对应文件,放到第 5.4 节约定目录后再启动脚本。
7.3 CLI 推理命令(官方 README)
7.3.1 使用社区大模型生成动画
python -m scripts.animate --config configs/prompts/1_animate/1_1_animate_RealisticVision.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_2_animate_FilmVelvia.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_3_animate_ToonYou.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_4_animate_MajicMix.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_5_animate_RcnzCartoon.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_6_animate_Lyriel.yaml
python -m scripts.animate --config configs/prompts/1_animate/1_7_animate_Tusun.yaml
7.3.2 MotionLoRA 相机运动控制
python -m scripts.animate --config configs/prompts/2_motionlora/2_motionlora_RealisticVision.yaml7.3.3 SparseCtrl RGB 与涂鸦控制
# 图生动画(i2v)示例
python -m scripts.animate --config configs/prompts/3_sparsectrl/3_1_sparsectrl_i2v.yaml

# RGB 关键帧条件
python -m scripts.animate --config configs/prompts/3_sparsectrl/3_2_sparsectrl_rgb_RealisticVision.yaml

# 涂鸦草图条件
python -m scripts.animate --config configs/prompts/3_sparsectrl/3_3_sparsectrl_sketch_RealisticVision.yaml
生成样本保存到 samples/ 目录:每个配置生成
samples/<配置名>-<时间戳>/sample/<序号>-<提示词截断>.gif,全部样本汇总为
samples/<配置名>-<时间戳>/sample.gif,同时保存本次实际参数快照
config.yaml。
7.3.4 CLI 常用覆盖参数
# 显式指定基础模型、推理配置、帧数与分辨率
python -m scripts.animate \
  --pretrained-model-path runwayml/stable-diffusion-v1-5 \
  --inference-config configs/inference/inference-v3.yaml \
  --config configs/prompts/1_animate/1_1_animate_RealisticVision.yaml \
  --L 16 --W 512 --H 512

# 本机无 xFormers 可用时关闭高效注意力
python -m scripts.animate \
  --config configs/prompts/1_animate/1_1_animate_RealisticVision.yaml \
  --without-xformers
参数默认值与取值范围见第 8.1 节。
7.4 SDXL
分支环境与推理(官方 sdxl 分支 README)
README 顶部说明:
main分支面向 Stable Diffusion V1.5;SDXL 相关代码在sdxl分支(README 正文表述为sdxl-beta,仓库分支实际名为sdxl,以git branch -a与仓库页面为准)。
7.4.1 切换分支与环境
git clone https://github.com/guoyww/AnimateDiff.git
cd AnimateDiff
git checkout sdxl

conda env create -f environment.yaml
conda activate animatediff_xl
7.4.2 下载基础模型与运动模块
git lfs install
git clone https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0 models/StableDiffusion/

bash download_bashscripts/0-MotionModule.sh
也可从 Google Drive / Hugging Face / CivitAI 手动下载
mm_sdxl_v10_beta.ckpt 放入
models/Motion_Module/。
7.4.3 下载个性化 SDXL(可选)
bash download_bashscripts/1-DynaVision.sh
bash download_bashscripts/2-DreamShaper.sh
bash download_bashscripts/3-DeepBlue.sh
7.4.4 生成视频
# 原始 SDXL 基础模型
python -m scripts.animate --exp_config configs/prompts/1-original_sdxl.yaml --H 1024 --W 1024 --L 16 --xformers

# 个性化 SDXL(需先完成 7.4.3 下载对应 LoRA)
python -m scripts.animate --config configs/prompts/2-DynaVision.yaml --H 1024 --W 1024 --L 16 --xformers
python -m scripts.animate --config configs/prompts/3-DreamShaper.yaml --H 1024 --W 1024 --L 16 --xformers
python -m scripts.animate --config configs/prompts/4-DeepBlue.yaml --H 1024 --W 1024 --L 16 --xformers官方推荐分辨率(sdxl 分支
README):
| 分辨率 | 宽高比 |
|---|---|
| 768×1344 | 9:16 |
| 832×1216 | 2:3 |
| 1024×1024 | 1:1 |
| 1216×832 | 3:2 |
| 1344×768 | 16:9 |
官方提示:推荐分辨率下 16 帧推理通常需要约 13 GB 显存;SDXL 在低分辨率上质量较差,应使用上表高分辨率;官方示例使用 EulerDiscrete 采样器 100 步;不同个性化 SDXL 模型对采样步数、CFG Scale 等超参数有各自调校,需在推荐值基础上略作调整。
7.4.5 自定义 SDXL 检查点 / LoRA 配置格式
按 sdxl 分支 README 给出的格式新建 YAML:
motion_module_path: "models/Motion_Module/mm_sdxl_v10_beta.ckpt"

# 支持三类 T2I 模型:
# 1. Checkpoint:包含 UNet、Text_Encoders、VAE 的 safetensors 模型
# 2. LoRA:仅包含 LoRA 模块的 safetensors 模型
# 3. 将 Checkpoint 转换为与 SDXL 1.0 基础模型同结构的文件夹

ckpt_path: "YOUR_CKPT_PATH"
lora_path: "YOUR_LORA_PATH"
base_model_path: "YOUR_BASE_MODEL_PATH"

steps: 50
guidance_scale: 8.5
seed: -1
具体字段语义以 sdxl 分支配置文件与源码为准。
7.5 第三方集成与 Diffusers 管线(非本仓库维护)
- Stable Diffusion WebUI 扩展:sd-webui-animatediff,由社区维护,用于在 A1111 类 WebUI 中挂载运动模块生成动画;安装、依赖与模型管理以该扩展仓库说明为准。
- ComfyUI 节点:ComfyUI-AnimateDiff-Evolved,由社区维护,提供节点化工作流支持。
- Diffusers 官方管线:Hugging Face Diffusers 已原生支持 AnimateDiff,参考官方文档教程在 Python 流水线中直接调用,权重与接口以 Diffusers 版本为准。
- Colab 演示:camenduru/AnimateDiff-colab,社区维护的在线快速实验环境。
以上第三方项目与本仓库不存在官方打包关系,版本兼容性、模型许可与安全风险由对应维护者与部署方自行核对。
7.6 训练(官方文档
__assets__/docs/animatediff.md)
数据集:训练前下载 WebVid10M 的视频文件与
.csv
标注;示例训练脚本要求所有视频保存在单个文件夹中,如需多目录可修改
animatediff/data/dataset.py。
配置:修改 configs/training/
下配置中的数据路径:
train_data:
  csv_path: [替换为 .csv 标注文件路径]
  video_folder: [替换为视频文件夹路径]
  sample_size: 256
学习率、训练轮次、验证设置等其他训练参数同样位于该 YAML 中。
训练命令:
# 微调 UNet 图像层
torchrun --nnodes=1 --nproc_per_node=1 train.py --config configs/training/v1/image_finetune.yaml

# 训练运动模块
torchrun --nnodes=1 --nproc_per_node=1 train.py --config configs/training/v1/training.yaml
训练属于研究向二次开发,推理部署无需执行本节命令。
8 配置项说明
8.1
scripts/animate.py CLI 参数(来自源码
argparse)
| 参数 | 默认值 | 说明 |
|---|---|---|
--pretrained-model-path |
runwayml/stable-diffusion-v1-5 |
基础 SD 模型路径(Hugging Face 仓库名或本地文件夹),加载 tokenizer、text_encoder、vae、unet |
--inference-config |
configs/inference/inference-v1.yaml |
推理配置文件路径;YAML 内可逐项覆盖 |
--config |
必填 | 提示词 / 模型组合 YAML 路径,脚本要求显式传入 |
--L |
16 |
动画帧数(video_length) |
--W |
512 |
输出宽度(像素) |
--H |
512 |
输出高度(像素) |
--without-xformers |
关闭开关(默认开启 xFormers) | 检测到 xFormers 可用时调用
enable_xformers_memory_efficient_attention();传入该参数则不启用 |
8.2 提示词 YAML
配置字段(来自 configs/prompts/ 示例)
一份 YAML 为列表,每个元素对应一组模型与提示词;主要字段如下:
| 字段 | 示例 / 默认 | 说明 |
|---|---|---|
dreambooth_path |
models/DreamBooth_LoRA/realisticVisionV60B1_v51VAE.safetensors |
社区基础大模型路径;加载后转换并覆盖 UNet、VAE、CLIP text encoder |
lora_model_path |
"" |
可选额外 LoRA 模型路径(.safetensors) |
lora_alpha |
0.8(util.py 默认) |
LoRA 融合强度;WebUI 下拉可选
0.、0.2、0.4、0.6、0.8、1.0 |
inference_config |
configs/inference/inference-v3.yaml |
推理配置(运动模块结构与噪声调度器参数);v2 配置对应
inference-v2.yaml |
motion_module |
models/Motion_Module/v3_sd15_mm.ckpt |
运动模块权重路径 |
motion_module_lora_configs |
列表 {path, alpha} |
MotionLoRA 配置,可挂载多个相机运动 LoRA |
adapter_lora_path |
models/Motion_Module/v3_sd15_adapter.ckpt |
v3 域适配器 LoRA 路径 |
adapter_lora_scale |
1.0 |
域适配器 LoRA 缩放系数 |
controlnet_config |
configs/inference/sparsectrl/latent_condition.yaml |
SparseCtrl 结构配置 |
controlnet_path |
models/SparseCtrl/v3_sd15_sparsectrl_rgb.ckpt |
SparseCtrl 编码器权重路径(RGB 或 scribble) |
controlnet_images |
本地图片路径列表 | 稀疏条件图路径列表,数量不超过 L |
controlnet_image_indexs |
[0] |
条件图索引列表 |
seed |
整数或整数列表;-1 / 未指定表示随机种子 |
每组提示词可对应固定种子;列表长度与提示词数量匹配 |
steps |
25(示例配置) |
采样步数(num_inference_steps) |
guidance_scale |
8(v3 / v1 示例);7.5(MotionLoRA
示例);8.5(RGB SparseCtrl 示例) |
提示词引导系数(CFG) |
prompt |
提示词字符串列表 | 正向提示词,支持多条批量采样 |
n_prompt |
负面提示词字符串列表 | 负面提示词;长度为 1 时自动复制到所有提示词 |
W / H / L |
未配置时继承 CLI 默认 512 / 512 / 16 |
单组配置内可单独覆盖分辨率与帧数 |
8.3
推理配置 inference-v1.yaml / v2.yaml / v3.yaml
关键字段
unet_additional_kwargs:
| 字段 | v3 / v2 取值 | 说明 |
|---|---|---|
use_inflated_groupnorm |
true(v1 为 false) |
是否使用膨胀 GroupNorm |
use_motion_module |
true |
是否挂载运动模块 |
motion_module_resolutions |
[1, 2, 4, 8] |
运动模块作用的特征分辨率层级 |
motion_module_mid_block |
v3:false;v2:true |
运动模块是否作用于 UNet 中间块 |
motion_module_type |
"Vanilla" |
运动模块类型 |
num_attention_heads |
8 |
时间注意力头数 |
num_transformer_block |
1 |
时间 Transformer 块数量 |
attention_block_types |
["Temporal_Self", "Temporal_Self"] |
注意力块类型(时间自注意力) |
temporal_position_encoding |
true |
是否启用时间位置编码 |
temporal_attention_dim_div |
1 |
时间注意力维度缩放除数 |
zero_initialize |
true |
投影层零初始化 |
noise_scheduler_kwargs:
| 字段 | 取值 | 说明 |
|---|---|---|
beta_start |
0.00085 |
噪声调度起始 beta |
beta_end |
0.012 |
噪声调度结束 beta |
beta_schedule |
"linear" |
beta 调度类型 |
steps_offset |
1 |
步数偏移(Euler / PNDM 调度器在 app.py
中会移除该参数) |
clip_sample |
false |
是否裁剪采样样本(Euler / PNDM 调度器在 app.py
中会移除该参数) |
8.4 Gradio
界面控件默认值(来自 app.py)
| 控件 | 默认值 | 取值范围 / 说明 |
|---|---|---|
| Pretrained Model Path | runwayml/stable-diffusion-v1-5 |
下拉列表,预置基础模型并扫描 models/StableDiffusion/
子目录 |
| Select motion module | v3_sd15_mm.ckpt |
选项来自 MOTION_MODULES 清单 |
| Select base Dreambooth model | realisticVisionV60B1_v51VAE.safetensors |
必填;选项来自 BACKUP_DREAMBOOTH_MODELS 与本地
models/DreamBooth_LoRA/*.safetensors |
| Select LoRA model | none |
可选;none 表示不挂载 LoRA |
| LoRA alpha | 0.6 |
可选
0.、0.2、0.4、0.6、0.8、1.0 |
| Sampling method | DDIM |
可选 DDIM、Euler、PNDM |
| Sampling steps | 25 |
滑块 10–100,步长 1 |
| Width | 512 |
滑块 256–1024,步长 64 |
| Height | 512 |
滑块 256–1024,步长 64 |
| Animation length | 16 |
滑块 8–24,步长 1 |
| CFG Scale | 8.0 |
滑块 0–20 |
| Seed | 8893659352891878017(默认示例种子);填 -1
为随机种子 |
文本框,骰子按钮生成随机整数 |
8.5 模型权重清单(README Model Versions)
AnimateDiff v3(2023.12,main 分支默认):
| 文件名 | 类型 | 大小 | 说明 |
|---|---|---|---|
v3_sd15_adapter.ckpt |
Domain Adapter | 97.4 MB | 域适配器 LoRA |
v3_sd15_mm.ckpt |
Motion Module | 1.56 GB | v3 运动模块 |
v3_sd15_sparsectrl_scribble.ckpt |
SparseCtrl Encoder | 1.86 GB | 涂鸦条件编码器 |
v3_sd15_sparsectrl_rgb.ckpt |
SparseCtrl Encoder | 1.85 GB | RGB 图像条件编码器 |
AnimateDiff v2(2023.09):
| 文件名 | 类型 | 参数 / 存储 |
|---|---|---|
mm_sd_v15_v2.ckpt |
Motion Module | 453 M 参数 / 1.7 GB |
v2_lora_ZoomIn.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_ZoomOut.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_PanLeft.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_PanRight.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_TiltUp.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_TiltDown.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_RollingClockwise.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
v2_lora_RollingAnticlockwise.ckpt |
MotionLoRA | 19 M 参数 / 约 74 MB |
AnimateDiff v1(2023.07):
| 文件名 | 参数 | 存储 |
|---|---|---|
mm_sd_v14.ckpt |
417 M | 1.6 GB |
mm_sd_v15.ckpt |
417 M | 1.6 GB |
SDXL-Beta(sdxl 分支):
| 文件名 | 类型 | 参数 / 存储 |
|---|---|---|
mm_sdxl_v10_beta.ckpt |
Motion Module | 238 M 参数 / 0.9 GB |
社区基础大模型(
realisticVisionV60B1_v51VAE.safetensors、majicmixRealistic_v4.safetensors、toonyou_beta3.safetensors等)由guoyww/animatediff_t2i_backups备份分发,各模型画风与许可以 CivitAI 对应模型页说明为准。
9 常用运维命令
# 进入仓库目录
cd AnimateDiff

# 激活虚拟环境(按实际环境管理器替换:conda / venv)
conda activate animatediff
# 或
source venv/bin/activate

# 退出环境
conda deactivate

# 重新安装项目依赖(修改 requirements.txt 后)
pip install -r requirements.txt

# 启动官方 Gradio 界面
python -u app.py

# CLI 推理(示例)
python -m scripts.animate --config configs/prompts/1_animate/1_1_animate_RealisticVision.yaml

# 查看 CLI 参数帮助
python -m scripts.animate -h

# 查看已生成结果目录
ls samples/

# 查看最近一次 WebUI 运行参数日志
cat samples/Gradio-*/logs.json

# 查看占用 7860 端口的进程(Linux)
ss -lntp | grep 7860
# 或
lsof -i :7860

# 查看 Python / 推理进程
ps -ef | grep -E "app.py|scripts.animate" | grep -v grep更新代码:git pull 后重新
pip install -r requirements.txt,按仓库 Releases 与 README
说明核对是否需要更新运动模块、适配器与 SparseCtrl 权重;切换
sdxl 分支前确认已切换回对应环境。
备份:保留 models/
目录下全部权重、samples/ 内自有生成结果与自定义提示词
YAML;下载的第三方模型权重不要提交到公开仓库。WebUI 每次运行在
samples/Gradio-<时间戳>/
下独立目录归档,备份时按时间戳目录整体复制即可。
停止与重启:在终端按 Ctrl + C 终止
Gradio 或 CLI 进程;需要后台常驻时可使用 tmux /
nohup / 系统服务托管,并把日志重定向到文件以便排查。
10 常见故障排查
10.1 模型下载失败 / 连接 Hugging Face 超时
现象:首次启动或 CLI
运行卡在下载阶段,出现连接超时、snapshot_download
报错或权重文件大小为 0。
处理:
- 检查本机网络能否访问 Hugging Face;按第 4 章 Google Drive / CivitAI 渠道手动下载对应权重,放到第 5.4 节约定目录后重启脚本。
- 确认文件名在
MOTION_MODULES、ADAPTERS或BACKUP_DREAMBOOTH_MODELS清单内;auto_download对清单外文件名会直接断言失败。 - 已下载到一半的损坏文件删除后重新下载,避免断点残留导致加载阶段报
unexpected EOF。
10.2 CUDA out of memory(显存不足)
现象:加载 pipeline 或采样阶段报
CUDA out of memory。
处理:
- 降低
--W、--H(WebUI 滑块下调宽高)与--L帧数,优先保证 512×512、16 帧以内跑通。 - 确认 xFormers 已安装并启用(默认开启);不要在无必要时加
--without-xformers。 - 减小采样步数与并行提示词数量;一份 YAML 中先保留单条提示词测试。
- 清理其他占用显存的进程后重试:
nvidia-smi
# 关闭无关显存占用进程后重启推理- 必要时设置 PyTorch 显存分配切分参数:
export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128
python -m scripts.animate --config <yaml>
SDXL 分支官方口径为约 13 GB 显存(推荐分辨率、16 帧);显存不足时改用 main 分支 SD 1.5 模型,或降低分辨率后再尝试。
10.3 xFormers 不可用或版本不匹配
现象:导入 xformers
报版本不兼容、is_xformers_available() 返回
False,或注意力优化相关报错。
处理:
- 按
requirements.txt安装xformers==0.0.27,并与 PyTorch 2.3.1、CUDA 版本匹配。 - CLI 可加
--without-xformers关闭高效注意力以先跑通流程;WebUI 路径在app.py中已判断is_xformers_available(),不可用时自动跳过启用。
10.4 依赖版本冲突(diffusers / transformers / torch)
现象:ImportError、AttributeError(如
pipeline 类不存在、scheduler 参数不识别)。
处理:本仓库锁定
diffusers==0.11.1、transformers==4.25.1、torch==2.3.1、torchvision==0.18.1;建议在独立虚拟环境中严格安装
requirements.txt,不要与其他扩散模型项目共用同一环境。升级或降级依赖后出现接口不匹配时,按仓库最新
README 核对推荐版本。
10.5 视频 / GIF 写出失败(imageio / ffmpeg)
现象:采样完成但保存 GIF / MP4 时报
imageio、ffmpeg 相关错误,或输出目录为空。
处理:
- 确认
imageio==2.27.0与imageio-ffmpeg==0.4.9已正确安装;系统ffmpeg可执行文件在PATH中。 - 检查
samples/目录与当前用户权限,确保进程对输出目录有写权限。 - 中间帧解码涉及
decord==0.6.0;该库在部分平台二进制 wheel 缺失时,按报错提示更换 Python 小版本或源码安装,以仓库最新 Issues 与说明为准。
10.6 风格与基础模型不一致
现象:生成动画画风与所选社区大模型不符,或图像动画 / 插值结果风格漂移。
排查(对应官方 Limitations 第 3 条):
- 确认
dreambooth_path指向的社区模型已完整下载并成功加载;WebUI 切换基础模型后 pipeline 会重建,等待日志打印done.再生成。 - 做图像动画 / 插值时,使用由同一社区模型生成的参考图像;混用不同画风基础模型与参考图会加剧风格错位。
- 检查
lora_alpha与adapter_lora_scale是否过高导致画面被拉偏,先回到默认值再逐项调整。
10.7 画面闪烁与运动僵硬
排查:
- 小幅闪烁属于官方已公布的已知限制(v3 Limitations 第 1
条),可尝试更换运动模块版本(v2 / v3)、调整帧数
L与种子。 - 相机运动僵硬时挂载对应 MotionLoRA(ZoomIn / PanLeft 等),并核对
motion_module_lora_configs路径与alpha正确。 - 提示词中明确主体运动与镜头运动描述;负面提示词补充低质量、畸形、抖动等描述。
- 运动质量与基础模型、采样步数、CFG 强相关,参照第 8.4 节参数范围逐步调优。
10.8 SDXL 分支质量差或显存不足
现象:sdxl
分支生成画面糊、人物变形,或直接 OOM。
处理(对应 sdxl 分支 README
提示):
- 使用第 7.4.4 节官方推荐高分辨率,不要强行压低到 512 级别。
- 采样器切换为 EulerDiscrete,采样步数提高到官方示例的 100 步量级;按个性化 SDXL 模型页建议微调 CFG Scale。
- 确认显存满足约 13 GB 口径;不足时回退 main 分支 SD 1.5 路径。
- 个性化 LoRA 必须先执行
download_bashscripts/对应脚本下载,未下载直接引用会导致权重缺失报错。
10.9 目录权限与路径报错
现象:FileNotFoundError、Permission denied
指向 models/ 或 samples/;YAML
中相对路径解析失败。
处理:
- 确认从仓库根目录启动命令(
python -m scripts.animate、python -u app.py),使相对路径models/、samples/与配置内相对路径正确解析。 - 检查
models/Motion_Module/、models/DreamBooth_LoRA/、samples/等目录存在且可写;不存在时由脚本自动创建前先确认父目录权限正常。 - SparseCtrl 条件图路径以 YAML 配置中
controlnet_images为准,图片需实际存在且数量不超过帧数L。
10.10 端口被占用
现象:Gradio 启动报
Address already in use 或 7860 被其他程序占用。
处理:
ss -lntp | grep 7860
# 找到占用进程后终止,或在 app.py 的 demo.launch 中改指定 server_port
11 风险与合规说明
11.1 许可证范围
- 本项目代码按 Apache License 2.0 发布(仓库
LICENSE.txt),允许使用、修改、分发与商用,但需保留版权声明与许可证副本;具体条款以LICENSE.txt原文为准。 - 代码构建自 Tune-a-Video 等上游项目,并集成 Diffusers、Transformers、xFormers、imageio、decord、omegaconf、gradio、einops、safetensors 等第三方库;集成分发时需同时核对各依赖库许可证。
- 运动模块、MotionLoRA、SparseCtrl 等模型权重的使用条款以 Hugging Face 模型卡与 README 说明为准;Apache 2.0 覆盖代码文本,不自动等同于对全部权重与第三方模型授予相同权利。
11.2 第三方模型版权
- 基础模型默认使用
runwayml/stable-diffusion-v1-5,SDXL 分支使用stabilityai/stable-diffusion-xl-base-1.0,其模型许可与使用限制以对应 Hugging Face 模型卡为准。 - 社区基础大模型(Realistic
Vision、FilmVelvia、ToonYou、MajicMix、RcnzCartoon、Lyriel、TUSUN
等)来自 CivitAI 等模型站,
guoyww/animatediff_t2i_backups仅为备份分发;商用前必须到对应模型页核对模型许可证、角色 / 风格版权与禁止用途。 - MotionLoRA 与 SparseCtrl 权重由官方仓库发布,其适用范围与模型卡说明保持一致;二次分发权重时需连同许可信息一并提供。
11.3 生成内容合规
- README Disclaimer 明确:本项目面向学术使用(released for academic use),官方不对用户生成内容(user-generated content)承担责任。
- 不得利用本项目生成侵权、诽谤、色情、暴力、恐怖、虚假新闻、冒充他人身份或用于诈骗、深度伪造欺骗的画面与动画;不得侵犯他人肖像权、名誉权、著作权与商标权。
- 对外发布 AI 生成的人物、角色或品牌相关动画时,应按当地法规标注 AI 合成属性,并取得素材、角色、肖像与声音的必要授权。
- 项目内置提示词与示例社区模型仅用于演示,不代表官方立场;商业产品化前应自行完成版权审查、内容审核机制与风险评估。
11.4 数据隐私与服务边界
- 本地源码推理与 WebUI
默认在本机运行,提示词、条件图与生成结果保存在本地
samples/目录;把素材上传到 HF Space、OpenXLab、Colab 等在线 Demo 时,需遵守对应平台的数据政策,不要上传敏感个人信息与未授权素材。 app.py默认share=True生成的 Gradio 临时公网链接仅为实验便利;对外提供服务时应自行搭建带认证的访问入口、控制上传内容并留存日志。- 官方唯一站点为
https://github.com/guoyww/AnimateDiff与https://animatediff.github.io/;README Disclaimer 声明其他网站均与官方无关联,请勿轻信第三方包装、付费镜像与"官方服务"宣传。
11.5 免责声明
本指南依据官方公开文档整理,命令、参数、端口、依赖版本与模型渠道均来自仓库
README、requirements.txt、configs/
推理与提示词配置、app.py、scripts/animate.py、animatediff/utils/util.py
以及 sdxl 分支
README;官方后续版本可能调整依赖版本、模型渠道、界面参数与硬件要求,部署时以仓库最新说明为准。作者与本文不对因使用、修改或运行本项目产生的直接或间接损失承担责任,法律不得排除或限制的责任除外。