

Xinference:Xorbits 开源的本地模型部署与推理平台,内置模型库一键拉起大模型、Embedding、多模态与语音模型|部署与使用全指南
项目仓库: https://github.com/xorbitsai/inference
开源协议:Apache License 2.0 · 运行语言:Python(控制台为打包进包内的
Next.js 静态导出,运行时无需 Node.js) · 交付形态:pip 包、官方 Docker
镜像、Docker Compose 编排、Kubernetes Helm Chart ·
默认端口:9997 · 官方文档:https://inference.readthedocs.io/
非官方声明:本文是基于官方 README、官方文档站(inference.readthedocs.io)与仓库源码整理的部署使用指南,不代表项目官方立场。Xinference、Xorbits、vLLM、SGLang、llama.cpp、MLX、Transformers 等名称归各自权利人所有;本文提及的模型权重、Hugging Face / ModelScope 模型及其第三方扩展均遵循其自身许可协议与服务条款,使用者须自行确认合规边界。项目按现状(AS-IS)提供,本文不构成对生成内容、商用授权或平台账号安全的任何担保。
1 项目简介
Xinference(全称 Xorbits Inference,仓库名
inference,组织 xorbitsai)是 Xorbits
团队开源的模型服务平台,官方 README 将其定位为 “a powerful and versatile
library designed to serve language, speech recognition, and multimodal
models”:用一条命令在本机或自有服务器上部署并提供大语言模型、语音识别、语音合成、Embedding、Rerank、文生图、图生图、文生视频与多模态模型的推理服务。平台内置一个持续维护的模型注册表(Built-in
Models),覆盖大量主流开源模型;使用者也可以通过配置把本地路径或模型站上的自定义模型注册进来。
平台本身只承担模型调度、进程管理、接口暴露与资源编排职责,不附带任何模型权重;首次拉起模型时按配置从模型站下载参数并缓存到本地,之后重复启动直接复用缓存。除单机本地模式外,Xinference 还提供 Supervisor + Worker 的分布式集群形态,把模型推理分布到多台设备或多台机器上运行。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | Xinference(Xorbits Inference;Python 包名
xinference,本地服务命令
xinference-local) |
| 仓库地址 | github.com/xorbitsai/inference |
| 项目定位 | 本地 / 自托管的模型部署与推理服务平台,统一拉起 LLM、Embedding、Rerank、图像、视频、音频、多模态与世界模型 |
| 开源协议 | Apache License 2.0(见仓库 LICENSE,官方文档与 PyPI
徽章同口径) |
| 运行语言 | Python;Web 控制台为 Next.js 静态导出并由后端直接托管,运行时不要求 Node.js |
| 内置模型类型 | LLM、Embedding、Rerank、图像生成、视频生成、音频(ASR/TTS/语音克隆等)、多模态、世界模型(World Model),注册表详见官方 Built-in Models |
| 推理引擎 | vllm、sglang、llama.cpp(团队维护的
xllamacpp
绑定)、transformers、MLX,另有 TRT-LLM
后端(版本与平台限制见 1.3 节) |
| 交付形态 | pip install xinference、一键安装脚本、Docker 镜像
xprobe/xinference、Docker Compose、Kubernetes Helm
Chart |
| 默认端口 | 9997;本地访问控制台
http://127.0.0.1:9997,接口文档
http://127.0.0.1:9997/docs,健康检查
http://127.0.0.1:9997/status |
| 本地数据目录 | 默认
<HOME>/.xinference(日志、模型注册表、启动历史、认证库等),可用
XINFERENCE_HOME 覆盖 |
| 模型缓存 | Hugging Face 缓存 ~/.cache/huggingface,ModelScope 缓存
~/.cache/modelscope;Docker 部署需显式挂载才能复用 |
| 官方文档 | 文档站首页 · 安装指南 · 使用指南 |
1.2 适用场景
- 在个人工作站或自有服务器上搭建一套统一的本地模型服务:用同一个控制台、同一套接口管理多个大模型、Embedding、Rerank 与多模态模型,随时切换、随时释放显存。
- 把本机模型以 OpenAI 兼容接口暴露给现有应用:已经基于 OpenAI
SDK、LangChain、LlamaIndex、Dify、FastGPT、RAGFlow、MaxKB、Chatbox
等构建的应用,只需把
base_url指向 Xinference 的/v1路径即可接入,无需改造业务代码。 - 按硬件条件选择推理引擎:Linux + NVIDIA 优先 vLLM / SGLang 换取吞吐;资源有限或 GGUF 量化模型走 llama.cpp;Apple Silicon 优先 MLX;其余模型用 Transformers 兜底。
- 搭建团队内部模型网关:通过 Supervisor + Worker 把多张显卡、多台机器纳入同一集群,按副本(Replica)水平扩展并由平台自动负载均衡;配合认证系统与 IP 白名单对外提供受控访问。
- 离线 / 内网环境部署:官方 Docker Compose 提供离线(air-gapped)profile,附带私有 PyPI 镜像源,在模型启动时装入按模型隔离的虚拟环境依赖。
- 批量实验与脚本化调用:通过 CLI、RESTful API 或 Python Client 完成模型注册、拉起、查询、终止与内存测算,接入自己的自动化流水线。
1.3 能力边界(官方口径)
- 官方 README 的定位是模型服务与调度层:模型能力、画质、生成速度、显存占用由所选模型权重、推理引擎、显卡与量化方式共同决定,平台本身不承诺特定回答质量或出图效果。
- 引擎受平台与硬件约束(官方 Installation 与 Backends
文档口径):vLLM、SGLang 面向 Linux + CUDA 环境;MLX 面向 Apple
Silicon;llama.cpp 走
xllamacpp绑定,支持 CPU 与对应 GPU 加速;Transformers 支持绝大多数 PyTorch 格式模型,是覆盖面最广的兜底引擎。LMDeploy 后端已因集成不再维护而移除;InternVL 等模型请选择 vLLM 或 Transformers。 - 自 v2.0 起模型虚拟环境(Model Virtual Environments)默认开启:拉起模型时平台为该模型与引擎创建独立虚拟环境并自动安装声明的依赖,首次启动需要访问 PyPI(或私有镜像源);离线主机必须使用 Compose 离线 profile 或预先准备离线 wheel 源。关闭该能力后需要在 Worker 环境内手动安装对应引擎依赖。
- 内置模型注册表覆盖的模型清单随版本持续更新,本文不逐一罗列;可用模型、格式、量化与引擎组合以控制台注册表、
xinference registrations命令与官方 Built-in Models 页面为准。 - 官方文档同时提供面向团队与生产环境的 Xinference Enterprise 商业版与托管 Xinference Cloud / Model API;本文仅覆盖社区开源版(Self-hosting Community Edition)的部署与使用,企业版功能、SLA 与授权以 xinference.co 官方说明为准。
- 平台不附带模型权重;Hugging Face 上的 gated(需授权)模型必须先在模型卡页面接受条款并配置访问 Token 才能下载(见 10.1 节)。
2 功能特性
以下条目整理自官方 README Key Features、Using Xinference、Backends 与 Model Launching 文档;具体参数名称、默认值与菜单位置以安装版本为准。
2.1 覆盖多类模型的内置模型库
- LLM(对话 /
补全大模型):注册表收录大量主流开源对话与代码模型,支持聊天(chat)与文本补全(generate)两类能力;模型格式覆盖
pytorch、gptq、awq、bnb、fp4、fp8、gguf等,量化档位随模型而定。 - Embedding 模型:文本向量化,服务于 RAG 知识库与语义检索;Rerank 模型:对候选文档做重排序,与 Embedding 配合构成检索链路。
- 图像模型:文生图、图生图、图像编辑与 OCR 类模型;视频模型:文生视频与图生视频;音频模型:语音识别(ASR)、语音合成(TTS)、语音克隆与音乐生成等。
- 多模态模型:支持图文输入的视觉语言模型;世界模型(World Model):面向生成式世界模拟的模型类别。
- 注册表可在控制台 “Launch Model”
对话框中按类型浏览;
xinference registrations -t LLM等命令可列出某一类型可拉起的模型;模型目录支持在线更新与收藏(Favorites)。
2.2 多推理引擎与自动选型
- 官方文档列出的引擎:
vllm、sglang、llama.cpp、transformers、MLX;v4.1.0 起新增TRT-LLM后端(Linux + NVIDIA CUDA,依赖tensorrt-llm==1.2.1,支持架构与约束见 Backends 文档)。 - 拉起 LLM 时必须显式指定
model_engine(自 v0.11.0 起为必填参数);xinference engine命令可查询某模型在哪些引擎下可运行、对应格式 / 量化 / 尺寸组合。 - 官方引擎选型建议(Using Xinference 文档):Linux 上优先 vLLM 或 SGLang 换取性能;资源有限优先 llama.cpp(量化选项更多);其余情况用 Transformers;Windows 推荐 WSL 后按 Linux 口径选择,否则优先 llama.cpp、不支持的模型再用 Transformers;Mac 上模型支持 MLX 时优先 MLX,其余走 llama.cpp 或 Transformers。
- vLLM 自动选用条件(Backends 文档):模型格式为
pytorch/gptq/awq/fp4/fp8/bnb,量化档位符合要求,系统为 Linux 且至少有一块 CUDA 设备,且模型家族在 vLLM 支持清单内;不满足条件时回落到其他引擎。
2.3 OpenAI 兼容与 Anthropic 兼容接口
- 官方文档明确提供 OpenAI 兼容 RESTful API,已支持的 OpenAI
接口包括:Chat
Completions(
/v1/chat/completions)、Completions(/v1/completions)、Embeddings(/v1/embeddings)、Responses(无状态,供 Codex CLI 等使用,/v1/responses)。 - 支持 Function Calling(工具调用),README 特性表将其列为相对同类平台的差异能力之一。
- 除 OpenAI 兼容路径外,平台还提供 Anthropic
兼容接口,基础路径为
http://127.0.0.1:9997/anthropic,可在 Claude Code 等 Anthropic 客户端中直接接入。 - 用官方 OpenAI SDK 接入的最小示例(官方文档口径,
api_key在本地模式下不实际校验):
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:9997/v1", api_key="not used actually")

response = client.chat.completions.create(
    model="qwen2.5-instruct",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "What is the largest animal?"}
    ]
)
print(response)
2.4 控制台、CLI、REST 与 Python SDK 多入口
- Web 控制台:浏览器打开
http://127.0.0.1:9997,完成模型浏览、部署、副本管理、启动历史、收藏、自定义模型注册与系统设置;接口文档在/docs。 - CLI 命令行:
xinference主命令,子命令包括cached、cal-model-mem、chat、engine、generate、launch、list、login、register、registrations、remove-cache、stop-cluster、terminate、unregister、vllm-models;全局选项含-v/--version、--log-level、-H/--host、-p/--port。 - RESTful API:
POST /v1/models拉起模型、GET /v1/models查看运行中模型、DELETE /v1/models/{model_uid}终止模型、GET /v1/model_registrations/{模型类型}查询注册表;完整端点以/docs在线页面为准。 - Python
Client:
RESTfulClient("http://127.0.0.1:9997")提供launch_model、get_model、list_models、list_model_registrations、terminate_model、register_model、unregister_model等方法;模型句柄按类型区分:ChatModelHandle(chat/generate)、EmbeddingModelHandle(create_embedding)、GenerateModelHandle(generate)、ImageModelHandle(text_to_image)、VideoModelHandle(text_to_video)、AudioModelHandle(speech/transcriptions/translations)、RerankModelHandle(rerank)等。 - 除 HTTP 外,平台内部基于 Xoscar 提供 RPC 通信,供集群 Supervisor 与 Worker 之间调度使用。
2.5 分布式集群与副本水平扩展
- 集群形态:一台机器运行
xinference-supervisor,其余机器运行xinference-worker并回连 Supervisor;CLI 与 API 通过 Supervisor 端点统一访问。 - 副本(Replica):部署时设置副本数,多个相同模型实例自动分布到多张显卡
/ 多台 Worker,平台在副本间负载均衡,使用者视角仍是一个模型;支持单 GPU
多副本(
XINFERENCE_ALLOW_MULTI_REPLICA_PER_GPU,默认开启)与混合 GPU 分配(副本数与 GPU 数不相等时智能分配)。 - 支持按副本逐个绑定 Worker
与显卡索引(
replica_config);运行中的模型可在线增加 / 移除副本;GPU 分配默认采用 Idle First(空闲优先)策略,可用XINFERENCE_LAUNCH_STRATEGY调整。 - 官方文档还覆盖 P/D 分离(Prefill / Decode 异构部署)、共享 KV 缓存、连续批处理、推测解码、零停机升级等生产化能力,相关约束与参数以对应专题文档为准。
2.6 自动批处理与资源调度
- 多个并发请求会被自动批处理(Auto
batch),提升整体吞吐;
XINFERENCE_BATCH_SIZE(默认32)与XINFERENCE_BATCH_INTERVAL(默认0.003秒)控制批处理行为。 - 单 Worker 上并发拉起模型的数量受
XINFERENCE_MAX_CONCURRENT_LAUNCHES(默认5)限制,超出排队,避免 fork 风暴、磁盘 IO 饱和与显存争用导致心跳超时。 - 提供
cal-model-mem命令离线测算模型权重、KV Cache、循环状态、前缀缓存、开销与激活内存总量,用于部署前容量规划(见 9.6 节)。
2.7 第三方生态集成
README 列出的官方集成包括:LangChain、LlamaIndex、Dify、FastGPT、RAGFlow、MaxKB、Chatbox;Xagent 作为 Agent 平台与 Xinference 集成,支持动态规划、工具调用与自主多步推理。
2.8 自定义模型接入
- 自 v0.14.0 起,若模型家族属于内置支持范围,可直接通过
--model-path指向本地模型文件拉起,无需先注册。 - 超出内置家族的模型可通过控制台 “Register Model” 对话框或
xinference register命令注册:提交模型名称、上下文长度、语言、能力、模型规格(格式、尺寸、量化、模型站 / 本地 URI、修订号)、对话模板、停止词等字段;Web UI 注册 LLM 时可自动解析模型配置并预填关键字段。 - 注册配置中的
virtualenv字段可为该自定义模型声明额外依赖包、私有索引源与可信主机;unregister用于移除注册项。
3 官方界面预览
3.1 控制台主界面
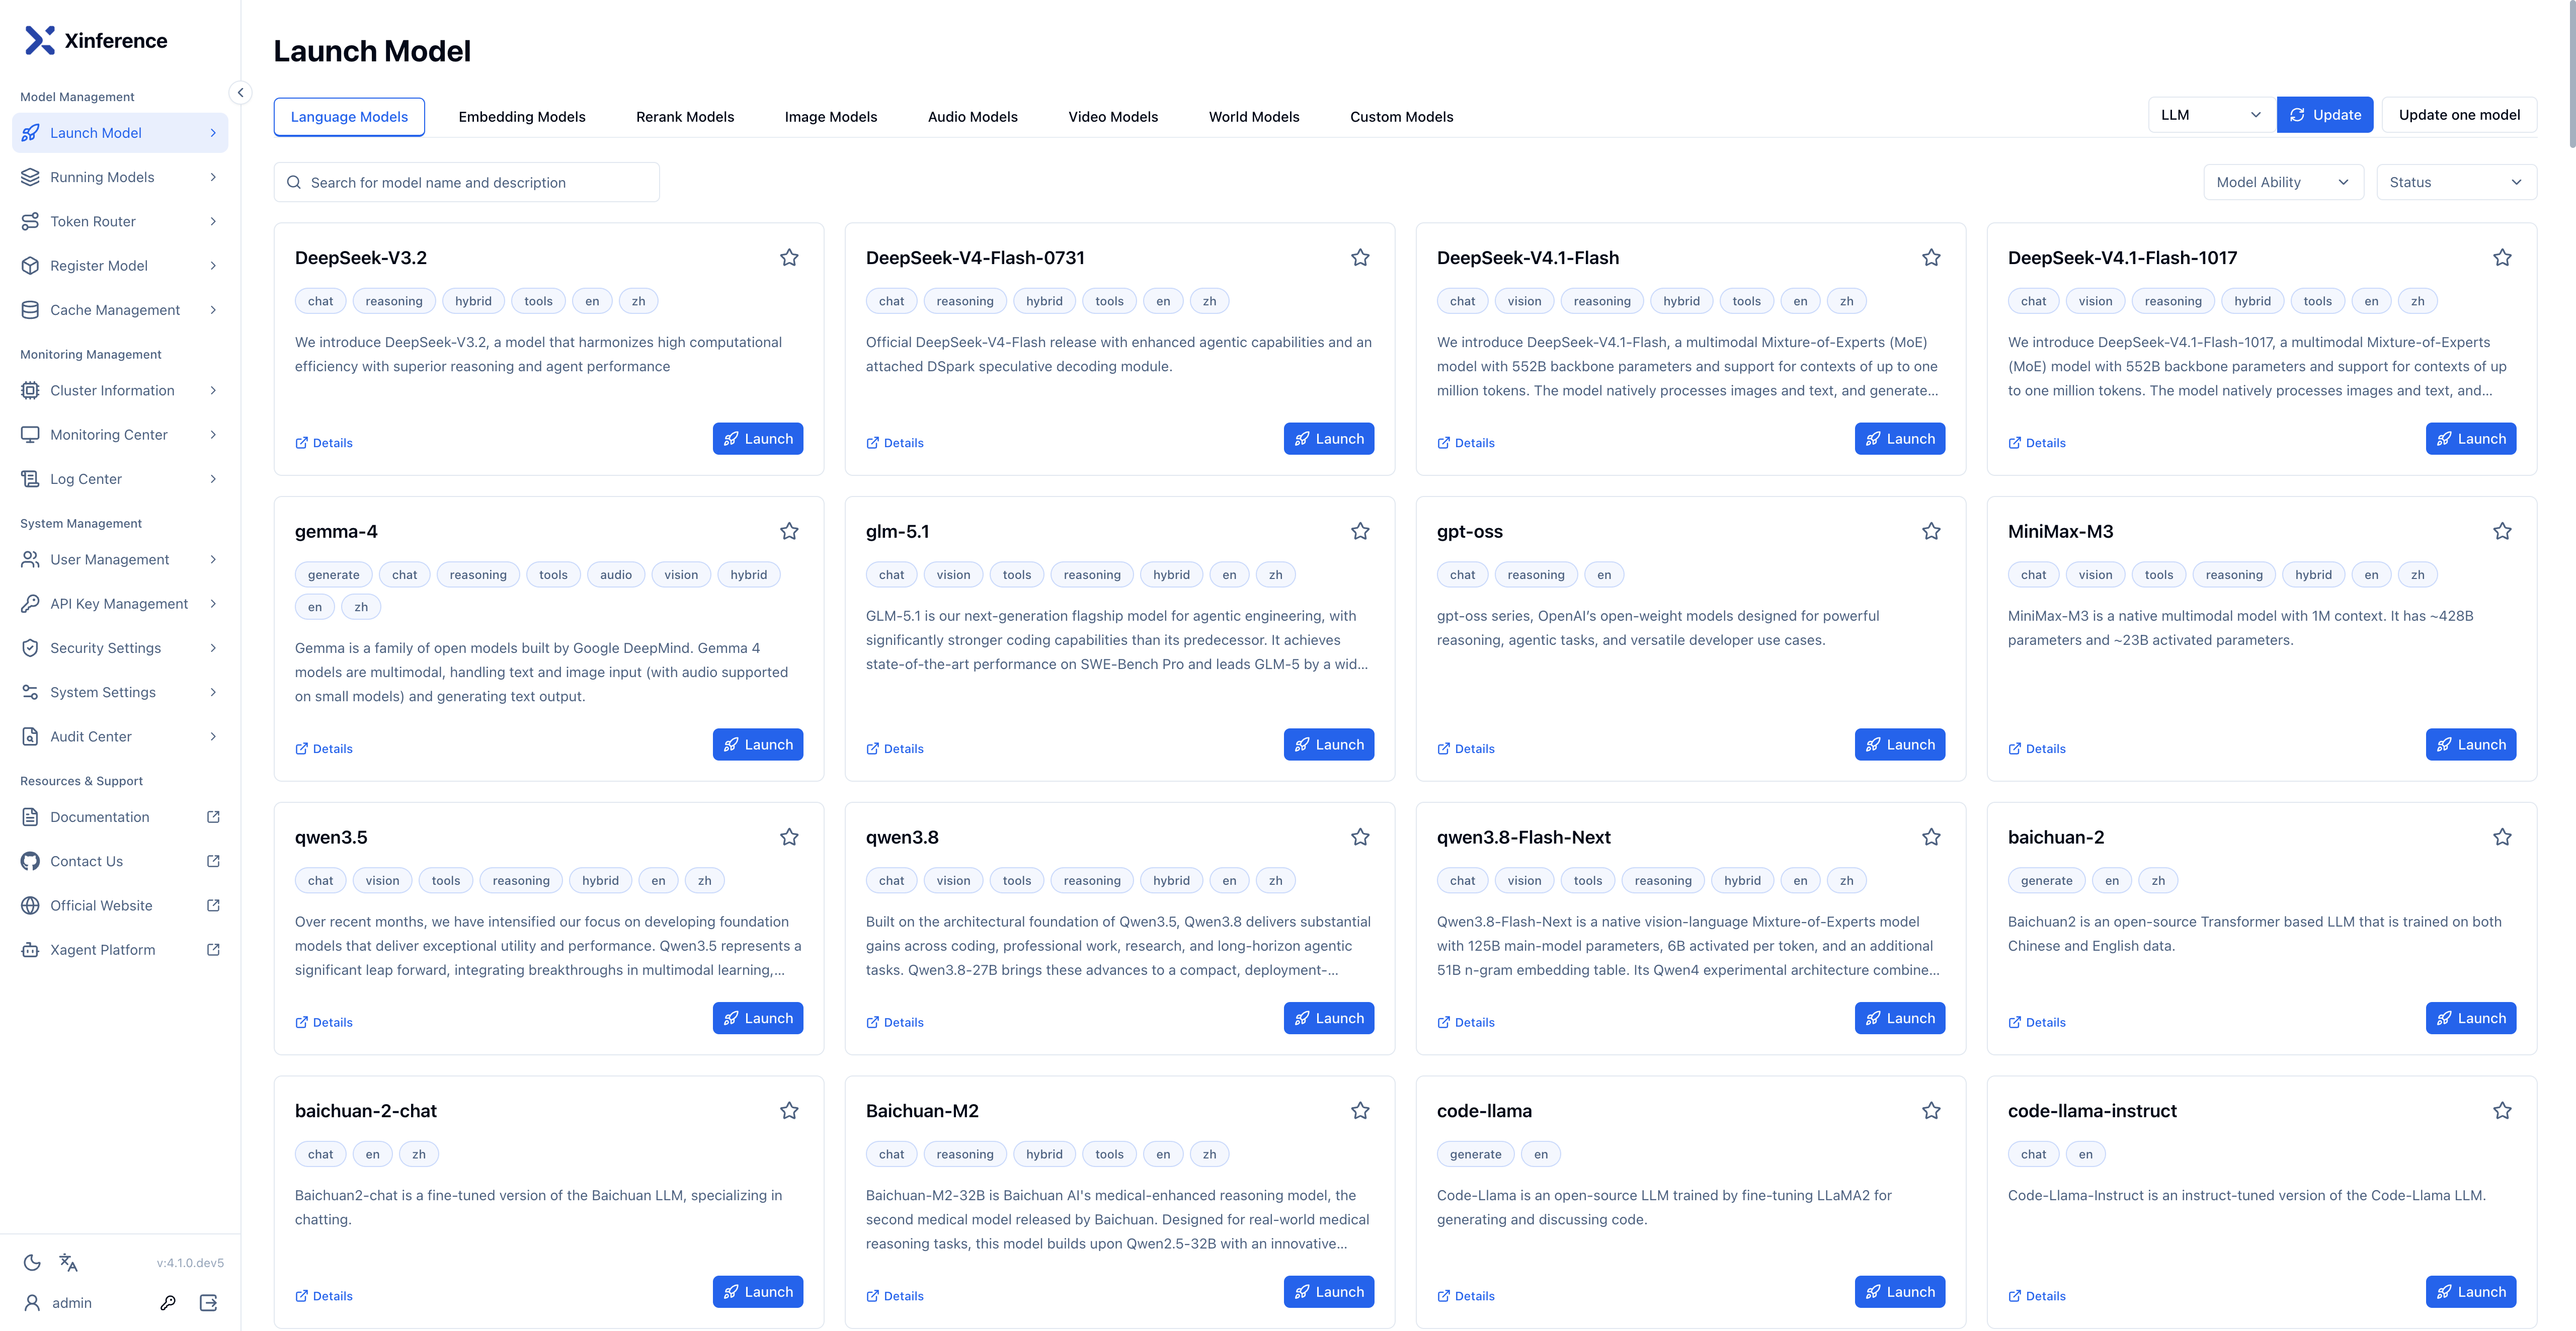
开篇图即官方 README 中的 Web UI
截图(assets/screenshot.png)。控制台为打包进
xinference 包内的 Next.js
静态导出,由后端自身托管,运行时不需要
Node.js。界面主要区域包括:左侧模型类型导航与注册表浏览区、右侧运行中模型(Running
Models)列表、模型部署 /
启动对话框(可选择引擎、模型格式、参数规模、量化、副本数、显卡数量与索引、上下文长度等),以及模型详情、启动配置历史与收藏入口。自
v3.0 起认证默认开启,首次访问控制台需要创建初始管理员账号;登录后 API
调用需要登录态或 API Key。
3.2 启动模型对话框与推荐配置
在 LLM 的部署对话框中,可点击 “Recommend configuration”(v3.5.0 加入)由平台结合当前 Worker、空闲显存与已装引擎,一次性填好建议的引擎、格式、尺寸、量化与显卡配置;推荐结果只是起始方案,不保证一定装得下,部署前仍需人工复核。嵌入式与多模态等参数在对话框中按模型类型动态展示;本地路径与自定义引擎参数需要手动填写。
4 官方跳转链接汇总
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/xorbitsai/inference | 服务端源码、前端工程、部署脚本与 README |
| 官方文档 | inference.readthedocs.io | 安装、使用、引擎、自定义模型、集群与安全主文档 |
| 安装指南 | Installation | pip、一键安装脚本、服务注册与引擎安装口径 |
| 使用指南 | Using Xinference | 本地启动、拉起模型、OpenAI 兼容调用、集群与 Docker 入门 |
| 内置模型目录 | Built-in Models | LLM / Embedding / Rerank / 图像 / 视频 / 音频 / 多模态 / 世界模型注册表 |
| 自定义模型 | Custom Models | 直接拉起本地模型与注册自定义模型配置模板 |
| 后端引擎 | Backends | llama.cpp、Transformers、vLLM、SGLang、MLX、TRT-LLM 平台与条件 |
| Docker 镜像 | Using Docker Image | 官方镜像标签、CUDA / 驱动要求、数据卷挂载 |
| Docker Compose | Docker Compose Deployment | 单机编排、CPU 覆盖文件与离线 / 气隙 profile |
| Kubernetes | Using Kubernetes | Helm Chart 部署与集群自定义配置 |
| 环境变量 | Environment Variables | 全部运行时环境变量与默认值 |
| 模型启动 | Model Launching Instructions | 副本、GPU 分配、推荐配置、上下文长度、离线下载 |
| 内存测算 | Model Memory Calculation | cal-model-mem 命令与输出字段口径 |
| 故障排查 | Troubleshooting | 模型站访问、驱动兼容、端口、下载、MKL 与依赖冲突 |
| 认证系统 | Authentication System | 账号、权限、API Key 与 JWT 配置 |
| Issues | github.com/xorbitsai/inference/issues | Bug 跟踪与功能建议 |
| Releases | github.com/xorbitsai/inference/releases | 版本发布说明与变更日志 |
| Docker Hub | hub.docker.com/r/xprobe/xinference | 官方镜像标签(latest、v<release>、nightly-main、-cpu
后缀) |
| PyPI | pypi.org/project/xinference | Python 包发布页 |
| 社区 · Discord | discord.gg/Xw9tszSkr5 | 官方 Discord 讨论群 |
| 社区 · Telegram | t.me/+nCNpwmySwk9iYmI1 | 官方 Telegram 群 |
| 企业版 | xinference.co | Xinference Enterprise 与托管 Model API 介绍(非社区版范围) |
| 许可证 | LICENSE | Apache License 2.0 全文 |
5 前置要求与服务器配置
5.1 软件前提
- Python(pip 路径):在已有的 Linux / Windows /
macOS Python 环境中执行
pip install xinference;官方一键安装器会自行准备uv与 Python 3.12 隔离环境,不依赖系统 Python 版本。模型虚拟环境默认开启,引擎依赖在首次拉起模型时装入对应隔离环境,无需预先安装xinference[all]或某个引擎 extra。 - Docker(容器路径):Docker Engine 已安装并可运行;GPU 主机还需完成 Docker 与 CUDA 环境准备,并安装 NVIDIA Container Toolkit。
- 显卡驱动(GPU 路径):官方 v3.0.0 起的 GPU 镜像基于
nvidia/cuda:13.0.2-devel-ubuntu22.04,文档要求主机 CUDA 13.0 及以上、NVIDIA 驱动版本580及以上;用nvidia-smi能正常返回显卡信息即说明驱动就绪。低于该口径的主机请选用对应旧版本镜像标签,具体兼容组合以 Docker Image 文档 为准。 - CPU 主机:可使用带
-cpu后缀的镜像标签;llama.cpp、Transformers、MLX(macOS)等引擎可在无显卡环境运行,但大模型推理速度明显受限,仅适合小模型体验、调试与低并发场景。 - macOS:MLX 引擎面向 Apple Silicon;Intel Mac 可能解析到旧依赖或安装失败(Installation 文档提示);Windows 环境官方建议使用 WSL 后按 Linux 口径选择引擎。
- 网络:首次安装需要访问 PyPI;首次拉起模型需要访问 Hugging Face 或 ModelScope;离线 / 气隙主机使用 Compose 离线 profile 与私有 PyPI 镜像,详见 6.4 节。
- 模型权重:平台不附带权重;内置模型首次拉起时自动下载并缓存,也可以提前把合规获取的模型文件放到本地后用
--model-path直接拉起。
5.2 硬件与系统建议
| 项目 | 官方口径与建议 |
|---|---|
| 操作系统 | Linux(vLLM / SGLang / TRT-LLM 生产路径);Windows(pip 或 WSL);macOS Apple Silicon(MLX 优先);官方 Docker GPU 镜像面向 Linux NVIDIA 主机 |
| 显卡 | vLLM / SGLang / TRT-LLM 要求 Linux + CUDA 设备;多卡部署配合
--shm-size 扩大共享内存;CPU 与 Apple Silicon
走对应引擎 |
| 显存 | 无固定统一阈值,取决于模型参数规模、量化档位、上下文长度与并发副本;部署前用
xinference cal-model-mem 离线测算(9.6 节),或在控制台
“Recommend configuration” 中结合空闲显存评估 |
| 内存 | 低显存引擎会把权重交换到内存;CPU 推理与大模型加载需要充足系统内存;嵌入式模型检索链路建议预留 16GB 以上内存,具体以模型测算结果为准 |
| 磁盘 | 预留模型权重、引擎虚拟环境与输出目录空间;单个 7B 级量化模型数 GB
起,多模型与多格式缓存会持续累积;定期用 xinference cached
/ xinference remove-cache 清理 |
| 集群网络 | Supervisor 与各 Worker 之间需互通;XOSCAR_AUTH_KEY
未设置时 actor 传输不做认证,actor
端口必须用网络策略限制在可信集群节点之间 |
| 离线环境 | 需预先把 Xinference 镜像、私有 PyPI 镜像镜像与模型权重传输到内网;模型启动时不能再访问公网 PyPI |
5.3 端口、目录与进程分配
| 项 | 默认值 | 用途与说明 |
|---|---|---|
| 服务端口 | 9997 |
Web 控制台、RESTful API、OpenAI 兼容 /v1 与 Anthropic
兼容 /anthropic 路径共用;--port 或
XINFERENCE_PORT 可改 |
| 控制台路径 | http://<host>:9997(集群 Supervisor 上为
/ui) |
Next.js 静态导出由后端托管 |
| 接口文档 | http://<host>:9997/docs |
Swagger / OpenAPI 在线端点文档 |
| 健康检查 | http://<host>:9997/status |
Compose 与服务化部署的健康探测端点 |
| 指标端点 | /metrics |
默认在 Supervisor 与 Worker
上启用指标导出;XINFERENCE_DISABLE_METRICS=1 关闭 |
| 本地数据目录 | ~/.xinference |
日志、系统设置、启动历史库 launch_history.db、认证库
auth/auth.db、注册表等;XINFERENCE_HOME
覆盖 |
| HF 缓存 | ~/.cache/huggingface |
Hugging Face 权重缓存;Docker 中需挂载容器内对应路径 |
| ModelScope 缓存 | ~/.cache/modelscope |
ModelScope 权重缓存;Docker 中需挂载容器内对应路径 |
| Supervisor 进程 | xinference-supervisor |
集群调度入口,监听配置主机与端口 |
| Worker 进程 | xinference-worker |
实际承载模型推理,回连 Supervisor 端点 |
| 模型虚拟环境 | XINFERENCE_HOME 下按模型 / 引擎隔离 |
首次拉起时创建并安装引擎依赖;XINFERENCE_ENABLE_VIRTUAL_ENV=0
可关闭 |
注意:把服务暴露到局域网或公网时,应启用认证(v3.0 起默认开启)并配合
XINFERENCE_ALLOWED_IPSIP 白名单、反向代理鉴权;不要在无认证情况下把控制台与/v1接口挂到公网。
6 方式一:Docker / Compose 一键部署(推荐服务化场景)
官方在 Docker Hub 提供 xprobe/xinference 镜像,并在仓库
xinference/deploy/docker/ 提供 Compose 编排,覆盖 GPU
主机、CPU 主机与离线环境。
6.1 前置准备
- 主机已安装 Docker Engine 与 NVIDIA Container Toolkit(GPU 主机)。
- 执行
nvidia-smi确认驱动正常;对照 5.1 节确认驱动 / CUDA 版本满足所选镜像标签要求。 - 确认
9997(或计划使用的其他端口)未被占用。
6.2 GPU
主机:docker run 直接启动
官方 README 给出的启动命令(端口、主机绑定与卷挂载可按需调整):
docker run --name xinference -d \
  -p 9997:9997 \
  -e XINFERENCE_HOME=/data \
  -v /on/your/host:/data \
  --gpus all \
  xprobe/xinference:latest \
  xinference-local -H 0.0.0.0
官方 Using Xinference 文档给出的另一形式(指定模型源、宿主机映射到
9998、开启调试日志):
docker run \
  -e XINFERENCE_MODEL_SRC=modelscope \
  -p 9998:9997 \
  --gpus all \
  xprobe/xinference:v<your_version> \
  xinference-local -H 0.0.0.0 --log-level debug
要点(Docker Image 文档口径):
--gpus all在 GPU 镜像上不可省略,否则容器内无法识别显卡并报错。xinference-local -H 0.0.0.0中的-H 0.0.0.0不可省略,否则端口只绑定在容器回环地址,宿主机无法访问。- 多显卡场景建议显式设置共享内存大小,例如
--shm-size=128g;默认/dev/shm仅 64MB,vLLM 后端容易因共享内存不足而 OOM(见 10.5 节)。 - 镜像标签规则:
nightly-main(每日构建,不保证稳定)、v<release version>(随版本发布,更稳定)、latest(最新稳定发布);CPU 版本在标签后加-cpu后缀,如nightly-main-cpu。
6.3 CPU 主机:-cpu 镜像
docker run \
  -e XINFERENCE_MODEL_SRC=modelscope \
  -p 9998:9997 \
  xprobe/xinference:v<your_version>-cpu \
  xinference-local -H 0.0.0.0 --log-level debug
CPU 镜像不带 GPU 运行时,适合无显卡主机上跑小模型、Embedding 与调试;大语言模型推理速度以秒 / 分钟级计,不建议作为生产对外服务。
6.4 数据卷挂载与模型缓存复用
官方镜像默认不含模型文件,模型下载进容器后会随容器删除而丢失。推荐把宿主机目录挂载到容器内
XINFERENCE_HOME,让权重与日志持久化:
docker run \
  -v /on/your/host:/on/the/container \
  -e XINFERENCE_HOME=/on/the/container \
  -p 9997:9997 \
  --gpus all \
  xprobe/xinference:v<your_version> \
  xinference-local -H 0.0.0.0
由于 Xinference 缓存目录通过符号链接组织,使用 Hugging Face 与 ModelScope 作为模型站时,建议把对应原始缓存目录一并挂载(官方 Docker Image 示例):
docker run \
  -v /your/home/path/.xinference:/root/.xinference \
  -v /your/home/path/.cache/huggingface:/root/.cache/huggingface \
  -v /your/home/path/.cache/modelscope:/root/.cache/modelscope \
  -p 9997:9997 \
  --gpus all \
  xprobe/xinference:v<your_version> \
  xinference-local -H 0.0.0.0
6.5 Docker Compose 编排(官方仓库内置)
官方 Compose 文件位于仓库
xinference/deploy/docker/,绑定挂载同目录
pip.conf,只下载 docker-compose.yml
一个文件不够,需要获取整个目录:
git clone https://github.com/xorbitsai/inference.git
cd inference/xinference/deploy/docker
GPU 主机一键启动:
docker compose up -d等待服务健康后校验:
docker compose ps
curl http://localhost:9997/status
控制台地址为 http://localhost:9997。自 v3.0
起认证默认开启,首次访问控制台需要创建初始管理员账号;之后 API
调用需要登录或 API Key。若在受信内网且希望关闭认证,在
docker-compose.yml 的 environment: 段加入
XINFERENCE_AUTH_ADVANCED=false(口径见 Authentication
System 文档)。
CPU-only 主机使用覆盖文件切换到 -cpu 镜像并移除 GPU
预留:
docker compose -f docker-compose.yml -f docker-compose.cpu.yml up -d6.5.1 Compose .env 变量
复制模板后按需修改:
cp .env.example .env| 变量 | 默认值 | 用途 |
|---|---|---|
XINFERENCE_IMAGE |
xprobe/xinference:latest |
运行镜像;生产环境建议固定 v<version> 标签 |
XINFERENCE_PORT |
9997 |
宿主机暴露的 RESTful API / 控制台端口 |
XINFERENCE_MODEL_SRC |
auto |
模型下载源:auto(探测 HF 可达性,失败回落
ModelScope)、huggingface、modelscope |
XINFERENCE_SHM_SIZE |
8gb |
共享内存大小,多卡推理可适当调大 |
XINFERENCE_LOG_LEVEL |
info |
日志级别 |
XOSCAR_AUTH_KEY |
未设置 | 集群 actor 传输共享密钥;部署集群时在 Supervisor 与所有 Worker 上使用同一随机值 |
XINFERENCE_HOME_DIR |
命名卷 | 持久化模型与配置目录;可指向宿主机绝对路径复用已有缓存 |
XINFERENCE_HF_CACHE_DIR |
命名卷 | Hugging Face 缓存持久化位置 |
XINFERENCE_MODELSCOPE_CACHE_DIR |
命名卷 | ModelScope 缓存持久化位置 |
XINFERENCE_WHEELS_DIR /
XINFERENCE_PYPISERVER_PORT /
XINFERENCE_PYPISERVER_IMAGE |
— | 离线 profile 私有 PyPI 服务器相关配置 |
6.5.2 离线 / 气隙环境
默认模式下引擎依赖在模型启动时装入按模型隔离的虚拟环境,需要访问
PyPI;离线主机通过 Compose offline profile 随附私有 PyPI
服务器(镜像
xprobe/xinference-pypiserver),预置运行时可能安装的
wheel(含 vLLM / SGLang 的 CUDA 栈)。步骤来自官方文档:
- 用
docker save/docker load把 Xinference 镜像与私有镜像镜像传入内网,并在.env中把两者固定到同一发布标签,保证镜像与模型规格、引擎依赖清单匹配。 cp offline.env.example offline.env;编辑pip.conf取消离线块三行注释(index-url、extra-index-url、trusted-host指向http://xinference-pypiserver:8080/simple)。- 按离线 profile 启动 Compose;完整步骤与变量见 Docker Compose Deployment 文档离线小节。
注意:预构建镜像的 GPU 栈面向 CUDA 13.0;该离线镜像不包含 CUDA 12.8 / 12.9 的在线支持栈。
6.6 Kubernetes(Helm Chart)
官方提供 Helm Chart 用于 Kubernetes 部署,集群需具备 GPU 支持:
# 添加仓库
helm repo add xinference https://xorbitsai.github.io/xinference-helm-charts

# 更新索引并查询可用版本
helm repo update xinference
helm search repo xinference/xinference --devel --versions

# 安装(版本号替换为查询到的 release 版本)
helm install xinference xinference/xinference -n xinference --version 0.0.1-v<xinference_release_version>
自定义配置、节点调度与 GPU 分配以 Using Kubernetes 文档为准。
7 方式二:pip / 一键脚本 / 源码本地运行
适合需要复用已有 Python 环境、二次开发、跟踪主干提交,或在无桌面环境的 Linux 服务器上手动部署的场景。
7.1 pip 安装到已有环境
pip install xinference安装完成后得到 xinference-local
本地服务命令、xinference 管理 CLI 与
xinference.client Python
客户端。单独安装最小依赖的客户端时,官方建议客户端版本与服务端版本保持一致:
pip install xinference-client==<SERVER_VERSION>7.2 一键安装脚本(隔离环境)
安装器会准备 uv、Python 3.12 与一个隔离的 Xinference
工具环境,并在前台启动本地服务,Ctrl+C 停止。
Linux / macOS:
curl -fsSL https://raw.githubusercontent.com/xorbitsai/inference/main/scripts/install.sh | shWindows PowerShell:
irm https://raw.githubusercontent.com/xorbitsai/inference/main/scripts/install.ps1 | iex安装器相关环境变量(Installation 文档口径):
| 变量 | 用途 |
|---|---|
XINFERENCE_START=0 |
只安装不启动 |
XINFERENCE_VERSION |
固定 / 回退到指定发布版本 |
XINFERENCE_PYTHON |
选择 Python 版本 |
XINFERENCE_EXTRAS |
预装指定引擎 extra |
XINFERENCE_TOOL_DIR |
修改 uv 工具存储目录 |
XINFERENCE_HOME |
持久化模型数据目录(与工具环境分离) |
XINFERENCE_BACKEND |
auto(按检测到的 GPU 驱动或 CPU 选择
PyTorch)、cpu、cu128 等;macOS 使用原生
PyTorch wheel |
XINFERENCE_SERVICE |
Linux / macOS 设 user 或 system,Windows
设 system,注册系统服务 |
XINFERENCE_HOST / XINFERENCE_PORT |
服务监听地址与端口,默认 127.0.0.1 /
9997 |
XINFERENCE_TIMEOUT |
服务就绪超时秒数,默认 120 |
不想做持久化安装时,可用 uvx 一次性运行(首次调用下载
Python 环境与依赖):
uvx --python 3.12 --from xinference xinference-local7.3 启动本地服务
# 默认本机启动
xinference-local

# 监听全部网卡并指定端口(局域网访问需要 -H 0.0.0.0)
xinference-local --host 0.0.0.0 --port 9997

# 指定数据目录
XINFERENCE_HOME=/tmp/xinference xinference-local --host 0.0.0.0 --port 9997

# 切换模型下载源为 ModelScope(国内网络环境常用)
XINFERENCE_MODEL_SRC=modelscope xinference-local --host 0.0.0.0 --port 9997
启动日志示例(官方 Using 文档口径):
INFO     Xinference supervisor 0.0.0.0:64570 started
INFO     Xinference worker 0.0.0.0:64570 started
INFO     Starting Xinference at endpoint: http://0.0.0.0:9997
INFO     Uvicorn running on http://0.0.0.0:9997 (Press CTRL+C to quit)
启动后:
- 控制台:
http://127.0.0.1:9997 - 接口文档:
http://127.0.0.1:9997/docs - 健康检查:
http://127.0.0.1:9997/status
7.4 拉起第一个内置模型(CLI / cURL / Python)
以 qwen2.5-instruct
为例,首次启动会从模型站下载参数并缓存;后续启动直接复用。CLI(注意自
v0.11.0 起必须指定 --model-engine):
xinference launch --model-engine transformers -n qwen2.5-instruct -s 0_5 -f pytorchcURL:
curl -X 'POST' \
  'http://127.0.0.1:9997/v1/models' \
  -H 'accept: application/json' \
  -H 'Content-Type: application/json' \
  -d '{
    "model_engine": "transformers",
    "model_name": "qwen2.5-instruct",
    "model_format": "pytorch",
    "size_in_billions": "0_5"
  }'
Python Client:
from xinference.client import RESTfulClient

client = RESTfulClient("http://127.0.0.1:9997")
model_uid = client.launch_model(
    model_engine="transformers",
    model_name="qwen2.5-instruct",
    model_format="pytorch",
    size_in_billions="0_5",
)
print("Model uid: " + model_uid)
调用对话模型:
model = client.get_model("qwen2.5-instruct")
resp = model.chat(
    messages=[{"role": "user", "content": "Who won the world series in 2020?"}]
)
print(resp)
引擎相关参数可在拉起时直接透传,例如 vLLM 的显存利用率:
xinference launch --model-engine vllm -n qwen2.5-instruct -s 0_5 -f pytorch --gpu_memory_utilization 0.97.5 注册为系统服务
pip / Conda / uv 安装完成后,可把本地服务注册为系统服务并后台运行:
xinference service install --start
xinference service status
xinference service logs
xinference service restart
xinference service stop
xinference service uninstall- Linux 使用 systemd 用户服务;希望不登录即可开机自启,执行
loginctl enable-linger USER。 - macOS 使用登录时启动的 LaunchAgent;无头主机请改用系统模式。
- 需要 system 级服务(Linux systemd 或 macOS
LaunchDaemon)时,使用提权终端、绝对命令路径并在动作前加
--system:
sudo /absolute/path/to/xinference service --system install --user USER --start
sudo /absolute/path/to/xinference service --system status
sudo /absolute/path/to/xinference service --system uninstall- Windows 服务当前要求 x86-64 Windows 与管理员 PowerShell,以
LocalSystem 身份运行;服务数据默认
%PROGRAMDATA%\Xinference\data,Linux / macOS 默认运行账号的~/.xinference;安装时可用--home指定数据目录、--host与--port指定监听地址与端口。
7.6 集群模式:Supervisor + Worker
在每台机器完成安装后,先在 Supervisor 与所有 Worker 上配置同一个
XOSCAR_AUTH_KEY(见 8.1 节),然后:
Supervisor 节点:
xinference-supervisor -H "${supervisor_host}"Worker 节点:
xinference-worker -e "http://${supervisor_host}:9997" -H "${worker_host}"CLI 连接集群时带 -e / --endpoint 指定
Supervisor 地址:
xinference launch -n qwen2.5-instruct -s 0_5 -f pytorch -e "http://${supervisor_host}:9997"Supervisor 控制台位于
http://${supervisor_host}:9997/ui,接口文档位于
http://${supervisor_host}:9997/docs。
7.7 源码克隆与本地开发
git clone https://github.com/xorbitsai/inference.git
cd inference- 后端 Python 开发:在虚拟环境中以可编辑模式安装,按 Installation
文档关闭模型虚拟环境后手动安装所需引擎 extra,例如
pip install "xinference[transformers]"。 - 前端开发:Web UI 是打包进包内的 Next.js 静态导出;源码模式下先执行
cd frontend && npm ci && npm run build构建一次,或用npm run dev做前端热更新开发;开发环境要求见仓库 “Creating a development environment” 文档页。 - 自定义镜像构建:仓库内
xinference/deploy/docker/Dockerfile为官方 Dockerfile 源码,在仓库顶层目录执行:
git clone https://github.com/xorbitsai/inference.git
cd inference
docker build --progress=plain -t test -f xinference/deploy/docker/Dockerfile .
8 配置项说明
8.1 常用环境变量(摘录自官方 Environments Variables 文档)
| 变量 | 默认值 | 用途 |
|---|---|---|
XINFERENCE_ENDPOINT |
http://127.0.0.1:9997 |
CLI / Client 连接的 Xinference 服务端点 |
XINFERENCE_HOME |
~/.xinference |
日志、模型、注册表、认证库等持久化根目录 |
XINFERENCE_MODEL_SRC |
auto |
模型下载源:huggingface、modelscope、auto;auto
先探测 HF(含 HF_ENDPOINT 与代理配置),不可达回落
ModelScope;单次拉起可用 --download_hub 覆盖 |
XINFERENCE_HUB_DETECT_TIMEOUT |
3 秒 |
自动探测模型站连通性的超时 |
XINFERENCE_SYSTEM_SETTINGS_PATH |
<XINFERENCE_HOME>/system-settings.json |
Web UI 系统设置 JSON 路径 |
XINFERENCE_ENABLE_VIRTUAL_ENV |
1(v2.0 起) |
全局开启按模型隔离的虚拟环境;设 0 关闭后需在 Worker
环境手动安装引擎依赖 |
XINFERENCE_VIRTUAL_ENV_SKIP_INSTALLED |
1 |
创建虚拟环境时跳过系统 site-packages 中已存在的包 |
XINFERENCE_MODEL_REGISTER_ROOTS |
XINFERENCE_MODEL_DIR、XINFERENCE_CACHE_DIR |
LLM 自动注册允许读取的额外目录,Unix 用 : 分隔、Windows
用 ; 分隔 |
XINFERENCE_TRUST_REMOTE_CODE |
未设置 | 加载自定义 CosyVoice 等需要在加载时执行 Python
代码的模型时,需在启动 Worker 前置
1;仅对受信模型源开启 |
XINFERENCE_FLEXIBLE_LAUNCHERS |
内置启动器 | 逗号分隔追加允许的 Flexible 启动器全限定名;白名单启动器以 Worker 权限执行 Python 代码,只加受信实现 |
XINFERENCE_BATCH_SIZE |
32 |
服务端批处理默认批大小 |
XINFERENCE_BATCH_INTERVAL |
0.003 秒 |
默认批处理间隔 |
XINFERENCE_MAX_CONCURRENT_LAUNCHES |
5 |
单 Worker 并发拉起模型上限,超出排队 |
XINFERENCE_ALLOW_MULTI_REPLICA_PER_GPU |
1 |
是否允许单 GPU 多副本 |
XINFERENCE_LAUNCH_STRATEGY |
IDLE_FIRST_LAUNCH_STRATEGY |
副本 GPU 分配策略 |
XINFERENCE_MAX_TOKENS |
未设置 | 全局覆盖请求最大 token 数限制 |
XINFERENCE_ALLOWED_IPS |
未设置(不限制) | 限制可访问的 IP 或 CIDR 网段 |
XINFERENCE_HTTP_REQUEST_TIMEOUT |
120 秒 |
完整 HTTP 请求(头 + 体)最长接收时间,0
关闭;流式响应与 WebSocket 不受影响 |
XINFERENCE_HTTP_TIMEOUT_KEEP_ALIVE |
5 秒 |
请求间 keep-alive 空闲超时 |
XINFERENCE_HTTP_LIMIT_CONCURRENCY |
未设置(不限) | HTTP 服务允许的最大并发连接 / 任务数,超出返回 503 |
XINFERENCE_DISABLE_HEALTH_CHECK |
未设置 | 设 1 关闭启动健康检查 |
XINFERENCE_HEALTH_CHECK_FAILURE_THRESHOLD |
5 |
启动期健康检查最大失败次数 |
XINFERENCE_HEALTH_CHECK_INTERVAL |
5 秒 |
健康检查间隔 |
XINFERENCE_HEALTH_CHECK_TIMEOUT |
10 秒 |
健康检查超时 |
XINFERENCE_DISABLE_METRICS |
未设置 | 设 1 关闭 Supervisor / Worker 的 /metrics
导出 |
XINFERENCE_DOWNLOAD_MAX_ATTEMPTS |
3 |
模型文件下载最大重试次数 |
XINFERENCE_SSE_PING_ATTEMPTS_SECONDS |
600 秒 |
SSE 保活 ping 间隔 |
XINFERENCE_MODEL_GPU_MEMORY_CACHE_TTL |
90 秒 |
Worker 上报失败时 Supervisor 保留的最近一份显存快照最长时间 |
XINFERENCE_AUTH_ADVANCED |
1(v3.0 起) |
数据库认证系统开关;设 0 / false /
no 可关闭认证(仅受信内网) |
XINFERENCE_AUTH_DB_PATH |
<XINFERENCE_HOME>/auth/auth.db |
账号、权限、API Key 与刷新令牌 SQLite 库 |
XINFERENCE_AUTH_JWT_SECRET_KEY |
首启自动生成并持久化 | 认证系统 JWT 签名密钥 |
XINFERENCE_AUTH_ENCRYPTION_KEY |
首启自动生成并持久化 | 静态加密存储 API Key 的密钥 |
XINFERENCE_ACCESS_TOKEN_EXPIRE_MINUTES |
30 |
访问令牌有效期(分钟) |
XINFERENCE_OIDC_ENABLED |
0 |
是否启用 OIDC 单点登录(如 Keycloak);启用后需配置 Issuer、Client ID、Client Secret、Redirect URI |
XINFERENCE_AUDIT_LOG_RETENTION_DAYS |
90 |
审计日志保留天数 |
XINFERENCE_MEDIA_BLOCK_PRIVATE_ADDRESS |
true(v3.5 起) |
拒绝解析到回环 / 私有 /链路本地地址的 image_url /
video_url / audio_url,防 SSRF |
XINFERENCE_MEDIA_ALLOW_LOCAL_PATH |
false(v3.5 起) |
是否允许 file:// URL
与裸本地文件路径作为聊天媒体输入 |
XINFERENCE_MEDIA_FETCH_TIMEOUT |
20 秒 |
拉取单个远程媒体 URL 的总墙钟时间(含跳转) |
XINFERENCE_MEDIA_MAX_BYTES |
67108864(64 MiB) |
单个拉取媒体文件最大字节数 |
XOSCAR_AUTH_KEY |
未设置 | Xoscar actor 传输共享密钥;集群部署时 Supervisor 与所有 Worker 使用同一随机值,生成命令见 7.6 节说明 |
XINFERENCE_CSG_TOKEN /
XINFERENCE_CSG_ENDPOINT |
未设置 / https://hub-stg.opencsg.com/ |
CSGHub 模型源 Token 与端点 |
凭据与密钥只保存在本机环境变量、
.env或密钥管理系统中,不要写入公开仓库、截图、文档或分享链接。
8.2 CLI 常用参数
全局选项:
| 参数 | 用途 |
|---|---|
-v, --version |
显示版本号退出 |
--log-level TEXT |
日志级别 |
-H, --host TEXT |
服务 / 连接主机 |
-p, --port INTEGER |
服务 / 连接端口 |
-e, --endpoint TEXT |
集群模式下指定 Supervisor 端点 |
常用子命令:
| 子命令 | 用途 |
|---|---|
xinference launch |
拉起模型;核心参数见 8.3 节 |
xinference list |
列出当前运行中的模型 |
xinference registrations -t <类型> |
列出可拉起模型注册表(类型如
LLM、embedding、rerank、image、audio
等) |
xinference terminate --model-uid <uid> |
终止运行中模型并释放资源 |
xinference register /
xinference unregister |
注册 / 移除自定义模型 |
xinference engine |
查询模型可运行的引擎与参数组合(可配合
--model-engine、-f 限定条件) |
xinference chat / xinference generate |
在命令行中直接对话 / 文本补全测试 |
xinference cached /
xinference remove-cache |
查看缓存模型 / 清理缓存 |
xinference cal-model-mem |
离线测算模型显存与内存需求 |
xinference vllm-models |
查询当前环境 vLLM 支持的模型清单 |
xinference login |
登录认证系统获取会话 / API Key |
xinference stop-cluster |
停止集群 |
8.3
模型拉起(xinference launch)常用参数
| 参数 | 用途 |
|---|---|
--model-engine <引擎> |
推理引擎:vllm、sglang、llama.cpp、transformers、MLX(vLLM
等引擎名大小写以 CLI 帮助为准) |
-n, --model-name <名称> |
内置模型名称 |
-u, --model-uid <UID> |
指定模型唯一标识;不指定时默认与模型名相同 |
-s, --size-in-billions <规模> |
参数规模,格式如
7、0_5、1.8 |
-f, --model-format <格式> |
模型格式:pytorch、gguf /
ggmlv3、gptq、awq、bnb、fp4、fp8
等,随模型而定 |
-q, --quantization <量化> |
量化档位:none、Int4、Int8、Int3
等,随引擎与格式而定 |
--context-length <长度> |
统一上下文长度(输入 + 输出 token);映射到 vLLM
max_model_len、SGLang / Transformers / MLX
context_length、llama.cpp n_ctx |
--replica <数量> |
副本数;多实例分布到多卡 / 多 Worker |
--replica-config '<JSON>' |
逐副本绑定 Worker 与显卡索引;与
--worker-ip、--gpu-idx、非 auto
的 --n-gpu、--n-worker >1 互斥 |
--n-gpu <数量 / auto> |
使用显卡数量;auto 由调度策略分配;null
表示 CPU 放置 |
--gpu-idx <索引列表> |
指定显卡索引 |
--worker-ip <地址> |
指定 Worker 节点 |
--model-path <路径> |
直接拉起本地模型文件(模型家族属于内置支持范围时免注册) |
--env <名> <值> |
为该模型单独设置运行时环境变量,例如
--env VLLM_USE_V1 0 |
--enable-thinking |
为支持思考模式的混合推理模型(如 Qwen3 系列)启用思考模式 |
| 引擎透传参数 | 直接在命令行写引擎参数名与值,例如
--gpu_memory_utilization 0.9,由平台透传给对应引擎 |
嵌套参数用
.分隔(例如 llama.cpp 采样参数sampling.top_k);完整参数以xinference launch --help与官方 Model Launching 文档为准。
8.4 自定义模型注册配置(JSON 模板摘录)
LLM 注册配置关键字段(官方 Custom Models 文档模板,字段含义以文档为准):
{
  "version": 2,
  "context_length": 32768,
  "model_name": "custom-qwen-2.5",
  "model_lang": ["en", "zh"],
  "model_ability": ["generate"],
  "model_description": "This is a custom model description.",
  "model_family": "my-custom-qwen-2.5",
  "model_specs": [
    {
      "model_format": "pytorch",
      "model_size_in_billions": "0_5",
      "quantization": "none",
      "model_id": null,
      "model_hub": "huggingface",
      "model_uri": "file:///path/to/models--Qwen--Qwen2.5-0.5B",
      "model_revision": null,
      "activated_size_in_billions": null
    }
  ],
  "chat_template": null,
  "stop_token_ids": null,
  "stop": null,
  "reasoning_start_tag": null,
  "reasoning_end_tag": null,
  "cache_config": null,
  "virtualenv": {
    "packages": [],
    "inherit_pip_config": true,
    "index_url": null,
    "extra_index_url": null,
    "find_links": null,
    "trusted_host": null,
    "no_build_isolation": null
  },
  "is_builtin": false
}
Embedding、Rerank、图像、音频与 Flexible 模型的注册模板字段不同,分别在控制台注册对话框中按类型填写,完整 schema 见 Custom Models 文档对应标签页。
8.5 配置文件与持久化数据
| 文件 / 目录 | 位置 | 说明 |
|---|---|---|
| 系统设置 | <XINFERENCE_HOME>/system-settings.json |
Web UI 中配置的系统项 |
| 启动历史库 | <XINFERENCE_HOME>/launch_history.db(SQLite) |
保存模型部署对话框的启动配置历史,跨浏览器与机器共享 |
| 认证库 | <XINFERENCE_HOME>/auth/auth.db(SQLite) |
账号、权限、API Key、刷新令牌;JWT 密钥与加密密钥同目录首启自动生成 |
| 模型虚拟环境 | XINFERENCE_HOME 下按模型 / 引擎隔离 |
首次拉起创建并安装依赖;依赖不变时复用 |
| 离线 pip 配置 | 仓库 xinference/deploy/docker/pip.conf |
Compose 启动时绑定挂载,供模型虚拟环境安装依赖使用 |
9 常用运维命令
以下命令按日常场景整理;Linux / macOS 与 Windows PowerShell 对应子命令一致,路径差异见 8.1 节。
9.1 启动、停止与重启
# 前台启动本地服务(默认本机回环)
xinference-local

# 监听全部网卡、指定端口与日志级别
xinference-local --host 0.0.0.0 --port 9997 --log-level info

# 指定数据目录与模型源
XINFERENCE_HOME=/data/xinference XINFERENCE_MODEL_SRC=modelscope xinference-local

# 系统服务方式(已注册服务后)
xinference service status
xinference service restart
xinference service stop
xinference service install --start
xinference service uninstall- 前台模式下
Ctrl+C停止;修改引擎、环境变量或认证配置后需要重启服务生效。 - 服务化部署由 systemd / LaunchAgent / Windows
服务托管,崩溃自动重启;日志通过
xinference service logs查看。
9.2 模型生命周期管理
# 查看运行中的模型
xinference list
curl http://127.0.0.1:9997/v1/models

# 查看注册表(按模型类型)
xinference registrations -t LLM
curl http://127.0.0.1:9997/v1/model_registrations/LLM

# 拉起模型(示例:transformers 引擎、0.5B、pytorch)
xinference launch --model-engine transformers -n qwen2.5-instruct -s 0_5 -f pytorch

# 指定模型 UID、上下文长度与副本数
xinference launch --model-engine vllm -n qwen2.5-instruct -s 7 -f pytorch \
  -u my-qwen --context-length 32768 --replica 2

# 终止模型释放显存
xinference terminate --model-uid "qwen2.5-instruct"
curl -X DELETE http://127.0.0.1:9997/v1/models/qwen2.5-instruct

# 命令行直接对话测试
xinference chat -m <model-uid>
xinference generate -m <model-uid>
9.3 状态、日志与健康检查
# 健康检查
curl http://127.0.0.1:9997/status

# 服务化日志
xinference service logs

# 控制台启动时开启调试日志
xinference-local --log-level debug

# 指标端点(默认开启)
curl http://127.0.0.1:9997/metrics
Python Client 查询集群状态:
from xinference.client import RESTfulClient
client = RESTfulClient("http://127.0.0.1:9997")
print(client.get_supervisor_info())
print(client.get_workers_info())
9.4 更新版本
# pip 路径:只升级 Xinference、保持 PyTorch 不被动升级(避免 vLLM / PyTorch ABI 冲突,见 10.10)
pip install -U xinference

# 一键安装器路径:重新执行同一命令即更新到最新稳定版
curl -fsSL https://raw.githubusercontent.com/xorbitsai/inference/main/scripts/install.sh | sh

# Docker 路径:在 .env / 启动命令中固定或升级镜像标签
# XINFERENCE_IMAGE=xprobe/xinference:v<new_version>
docker compose pull && docker compose up -d
升级后原来正在运行的模型需要重新拉起;模型数据与缓存在升级过程中保留。
9.5 备份与恢复
建议定期备份以下路径与文件:
| 备份对象 | 路径 / 位置 | 说明 |
|---|---|---|
| 模型权重与缓存 | XINFERENCE_HOME、~/.cache/huggingface、~/.cache/modelscope |
体积较大,可单独按目录迁移到外置盘或 NAS |
| 系统设置 | <XINFERENCE_HOME>/system-settings.json |
控制台系统配置 |
| 启动历史 | <XINFERENCE_HOME>/launch_history.db |
部署对话框配置历史 |
| 认证库与密钥 | <XINFERENCE_HOME>/auth/ |
账号、权限、API Key、JWT 与加密密钥;迁移时整体复制 |
| 自定义模型注册项 | 控制台导出或配置 JSON | 重装后重新注册 |
| Compose 配置 | xinference/deploy/docker/ 目录与
.env、offline.env |
编排参数与离线源配置 |
# Linux 下打包配置与认证数据(不含大模型权重)
tar -czf xinference-config-backup.tar.gz \
  system-settings.json launch_history.db auth/
恢复时把备份目录放回 XINFERENCE_HOME
对应位置;模型权重可通过 XINFERENCE_HOME
或缓存目录挂载指向备份位置,不必复制进安装目录。
9.6 部署前显存 / 内存测算
cal-model-mem 命令基于 gpu_poor
算法离线估算模型内存,输出
model_mem、kv_cache、recurrent_state_mem、prefix_cache_mem、overhead、active_mem
与总量:
xinference cal-model-mem -s 7 -q Int4 -f gptq -c 16384 -n qwen1.5-chat官方示例输出:
model_name: qwen1.5-chat
kv_cache_dtype: 16
model size: 7.0 B
quant: Int4
context: 16384
gpu mem usage:
  model mem: 4139 MB
  kv_cache: 8192 MB
  recurrent state: 0 MB
  retained prefix cache: 0 MB
  overhead: 650 MB
  active: 17024 MB
total: 30005 MB (30 GB)参数口径:-s/--size-in-billions
参数规模;-q/--quantization
量化;-f/--model-format
格式;-c/--context-length
上下文长度;-n/--model-name
模型名(提供后从模型站拉取配置辅助估算)。HF_ENDPOINT
环境变量可设置 Hugging Face 镜像端点。
9.7 缓存清理
# 列出本地缓存模型
xinference cached

# 清理指定缓存模型(释放磁盘,不删除已运行模型)
xinference remove-cache --model-uid <uid>
缓存清理只移除磁盘上的权重副本;下次拉起同一模型时会重新下载。
10 常见故障排查
以下问题整理自官方 Troubleshooting 文档、Installation / Docker Image / Backends 文档与 Model Launching 文档;排查时先以默认参数、单模型、单副本复现最小场景,再逐项加回引擎参数、副本数与自定义配置定位。
10.1 Hugging Face gated 仓库无访问权限
- 现象:拉起模型时报
Cannot access gated repo ... Repo model ... is gated. You must be authenticated to access it. - 原因:模型仓库需要先在模型卡页面接受使用条款,或缺少访问 Token。
- 处理:先打开对应 HF 仓库页面(如示例
https://huggingface.co/meta-llama/Llama-2-7b-hf)阅读并同意条款;在 HF Token 设置页 生成 Token,启动服务前设置环境变量:
export HUGGING_FACE_HUB_TOKEN=your_token_here- 不使用 HF 时可改从 ModelScope
拉起:
XINFERENCE_MODEL_SRC=modelscope xinference-local ...。
10.2 外部机器无法通过
<IP>:9997 访问
- 现象:本机
http://127.0.0.1:9997正常,局域网或其他机器访问<服务器 IP>:9997失败。 - 处理(官方 Troubleshooting 口径):启动时绑定全部网卡:
xinference-local -H 0.0.0.0- Docker 方式需在
docker run中显式-p <宿主机端口>:9997;Compose 中通过XINFERENCE_PORT控制宿主机端口。 - 检查主机防火墙 / 安全组是否放行对应端口;
-H 0.0.0.0不可省略,否则服务只绑定容器或进程回环地址。
10.3 内置模型下载慢或下载失败
- 现象:首次拉起模型长时间卡在下载,或报网络超时、文件不完整。
- 处理(官方 Troubleshooting 口径):中国大陆网络环境建议启动时指定 ModelScope 源:
XINFERENCE_MODEL_SRC=modelscope xinference-local --host 0.0.0.0 --port 9997Docker 中加入
-e XINFERENCE_MODEL_SRC=modelscope。也可设置
HF_ENDPOINT 指向 HF
镜像;XINFERENCE_DOWNLOAD_MAX_ATTEMPTS(默认
3)调整下载重试次数。下载中断后缓存复用已完成分片,重启拉起即可续传;缓存路径见
5.3 节。
10.4 拉起 LLM 时报缺少
model_engine
- 现象:拉起大模型失败,提示缺少
model_engine参数。 - 口径:自 v0.11.0 起,拉起 LLM
必须显式指定推理引擎;先执行
xinference engine --model-name <模型名>查询该模型可用的引擎与参数组合,再在xinference launch中带上--model-engine。
10.5 Docker 内
vLLM 后端 OOM、RayWorkerVllm died
- 现象:官方 Docker 镜像中加载 vLLM 模型失败,日志报共享内存相关错误或 Worker 进程被杀。
- 处理(官方 Troubleshooting 口径):Docker 默认
/dev/shm仅 64MB,对 vLLM 偏小,启动时加大共享内存:
docker run --shm-size=128g ...Compose 中通过 XINFERENCE_SHM_SIZE(默认
8gb)调整;多卡场景按模型与并发提高该值。
10.6
MKL
线程层冲突(Qwen2ForCausalLM failed to be inspected)
- 现象:启动服务时报
ValueError: Model architectures ... failed to be inspected,底层日志为mkl-service + Intel(R) MKL: MKL_THREADING_LAYER=INTEL is incompatible with libgomp ...。 - 原因:conda 安装的 NumPy 使用 Intel MKL,与环境中已加载的 GNU OpenMP(libgomp)冲突。
- 处理(官方两种方案):
# 方案一:强制 MKL 使用 GNU OpenMP
MKL_THREADING_LAYER=GNU xinference-local

# 方案二:用 pip 重装 NumPy
pip uninstall -y numpy && pip install numpy
# 或强制重装
pip install --force-reinstall numpy
使用 vLLM 时不要用 conda 安装 PyTorch,按 vLLM 官方安装指南选择匹配 GPU 的 PyTorch 版本。
10.7 NVIDIA 驱动与 PyTorch 版本不匹配
- 现象:GPU 环境报
CUDA initialization: The NVIDIA driver on your system is too old类警告,显卡识别失败。 - 处理:到 PyTorch 官网选择与本机驱动 CUDA 版本匹配的 wheel 重新安装;官方 Troubleshooting 建议 CUDA 版本不要低于 11.8,优先 11.8–12.1 区间示例:
# 示例:CUDA 11.8 驱动对应 torch 2.0.1+cu118(仅为文档示例,实际组合以 PyTorch 官网与所选引擎要求为准)
pip install torch==2.0.1+cu118- 官方 Docker GPU 镜像有自己的 CUDA / 驱动口径(5.1 节),手动 pip 环境的版本组合以 vLLM、SGLang、Transformers 各自安装文档为准。
10.8 PyPI 镜像缺少依赖包导致解析到旧版本
- 现象:安装
xinference[audio]等 extra 时,因单一镜像缺少num2words(MeloTTS 依赖)等包,pip / uv 回退解析到不兼容的旧版xinference与xoscar,随后报MainActorPool.append_sub_pool() got an unexpected keyword argument 'start_method'。 - 处理(官方 Troubleshooting 口径):配置多个镜像源互补,例如:
uv pip install xinference[audio] \
  --index-url https://mirrors.aliyun.com/pypi/simple \
  --extra-index-url https://pypi.tuna.tsinghua.edu.cn/simple
也可以在 ~/.config/uv/uv.toml 中配置
index-url 与 extra-index-url。
10.9 uv 安装解析到 2021 年旧版 transformers / tokenizers
- 现象:
uv pip install xinference后装入transformers==4.12.2、tokenizers==0.10.3等远古版本,构建tokenizers失败。 - 原因:uv
对直接依赖优先取最新版本,
huggingface-hub被解析到 1.x 后与transformers<=4.57.3的<1.0约束冲突,uv 反向把 transformers 降级到古老版本(官方 Troubleshooting 说明该行为源自 uv 依赖解析策略)。 - 处理(官方三种方案):
# 方案一(推荐):预先约束 huggingface-hub 版本范围
uv pip install "huggingface-hub>=0.34.0,<1.0" xinference

# 方案二:把 transformers 显式作为直接依赖
uv pip install transformers xinference

# 方案三:改用 pip,依赖解析相对保守
pip install xinference
10.10 vLLM + PyTorch + Xinference 升级后段错误(Segmentation Fault)
- 现象:升级 Xinference 后
xinference-local启动即Aborted (core dumped)/ 段错误,日志打印Automatically detected platform cuda后退出。 - 原因(官方 Troubleshooting 口径):vLLM 0.12.0
之前版本针对 PyTorch 2.8.0 编译,与 PyTorch 2.9 不兼容;Xinference
pyproject.toml对 torch 未设上限,uv pip install -U会重新解析全部依赖并把 PyTorch 升到不兼容版本。 - 处理:只升级 Xinference、保持现有 PyTorch 不变:
# pip:保守升级,不动 PyTorch
pip install -U xinference

# uv:不要带 -U,固定 Xinference 版本
uv pip install "xinference==1.16.0"- 已出现段错误时,按 vLLM 官方说明重装匹配版本的 vLLM 与 PyTorch 组合;模型虚拟环境开启时,依赖装入隔离环境,可在对应模型环境中修正版本。
10.11 llama.cpp 上下文 / KV Cache 显存问题
- 现象(官方 Backends Common Issues
口径):多模态图片编码报
failed to process image、Internal Error;或提示the request exceeds the available context size、Input prompt is too big compared to KV size,日志出现KV cache is full、Insufficient Memory。 - 处理:
- 降低
n_ctx(上下文长度)以减少 KV Cache 占用;串行推理时不要盲目加大n_parallel,它不会改善单请求延迟。 - 多模态上下文偏移(
ctx_shift)默认关闭;上下文不足时提高n_ctx或减少n_parallel。 - 部分层卸载到 GPU:通过
n_gpu_layers调整;未指定n-gpu-layers时 v1.6.1 起自动估算 NGL,但估算不精确,仍可能 OOM。 - 嵌套采样参数用
.分隔(如sampling.top_k),完整参数定义见 llama.cppcommon.h的common_params结构。
- 降低
10.12 模型虚拟环境依赖安装失败
- 现象:模型拉起进度停在
waiting_for_dependencies/installing_dependencies,随后报包下载或构建失败。 - 原因:模型虚拟环境默认开启,首次拉起时按模型规格从 PyPI 安装引擎依赖;离线主机或网络受限主机无法访问索引源。
- 处理:在线主机配置可用的 PyPI 镜像(10.8
节);离线主机使用 Compose 离线 profile 的私有 PyPI 服务器(6.5.2
节),或在模型注册配置的
virtualenv.packages、index_url中声明内部镜像。确需关闭虚拟环境时,设置XINFERENCE_ENABLE_VIRTUAL_ENV=0(或拉起模型时--disable-virtual-env),自行在 Worker 环境安装xinference[transformers]、xinference[vllm]等对应 extra;不要把互不兼容的引擎依赖混装在同一进程环境。
10.13 其他高频检查项
- 端口占用:
9997被其他进程占用时改用-p <其他端口>;先确认是否残留上一次 Xinference 进程,结束旧进程后再启动。 - 权限目录:
XINFERENCE_HOME、HF / ModelScope 缓存目录所在磁盘需要可写;不要把缓存目录放在只读挂载或跨文件系统符号链接断裂的位置。 - SSRF 媒体拦截:v3.5 起
XINFERENCE_MEDIA_BLOCK_PRIVATE_ADDRESS默认拦截指向内网地址的媒体 URL,file://与裸本地路径默认不允许;受信内网且确有需要时再评估关闭,注意由此引入的安全风险。 - 自定义模型代码执行:CosyVoice
等模型配置加载时会执行 Python 代码;非内置受信模型需要
XINFERENCE_TRUST_REMOTE_CODE=1,只对确认安全的模型源开启。
11 风险与合规说明
以下条款整理自官方
LICENSE、README、安装 / 安全 / 认证文档与通用合规口径;如与官方原文不一致,以仓库LICENSE、README 与 官方文档站 最新版本为准。
11.1 开源协议(Apache License 2.0)
Xinference 源码采用 Apache License 2.0(仓库
LICENSE,PyPI 与 README 徽章同口径)。Apache 2.0
属于宽松许可证:
- 允许自由使用、修改、分发与商用,保留版权声明、许可证副本与显著变更说明即可;不像 AGPL 那样对网络服务强制披露修改源码。
- 包含明确的专利授权条款;二次开发、内嵌进自有产品或对外提供服务前,仍建议结合自身业务确认专利署名、NOTICE 文件与商标使用要求。
- 仓库内集成或调用的第三方引擎(vLLM、SGLang、llama.cpp、MLX、Transformers、xllamacpp 等)与客户端 SDK 各自遵循其原始许可证与版本约束;安装时一并核对对应组件的许可文本。
11.2 模型权重与第三方素材许可
- 平台仓库不附带模型权重;内置模型指向 Hugging Face、ModelScope 等模型站上的第三方权重,各模型许可不同:有的仅允许研究 / 非商用,有的要求署名与使用限制,部分模型为 gated 条款(禁止特定用途、年龄限制、禁止商业部署)。下载与使用前必须阅读对应模型卡 / 模型站说明,不要默认 “能下载即可商用”。
- 用模型生成的文本、图像、音频、视频内容,其版权归属与可注册性在不同司法辖区规定不同;平台不保证生成内容原创、可商用或无侵权风险。
- 涉及真人肖像、声音、角色形象的生成,需确认训练素材与输出内容不侵犯他人肖像权、声音权、著作权与商标权;公开传播、商用或参赛前应取得授权或确认素材处于可训练许可范围。
11.3 自定义代码执行与信任边界
- 注册自定义模型、声明
virtualenv.packages、允许 Flexible 启动器、为 CosyVoice 等开启XINFERENCE_TRUST_REMOTE_CODE,都等价于在 Worker 权限下执行第三方 Python 代码;只从可信来源引入模型配置、依赖包与启动器,安装前阅读其源码与更新状态。 - 模型虚拟环境隔离了不同模型的 Python 依赖,但不替代进程级沙箱;不可信模型配置不应部署在承载其他业务的生产主机上。
11.4 网络暴露、认证与集群安全
- 自 v3.0
起认证系统默认开启,首次访问创建管理员账号;不要把管理控制台与
/v1接口在无认证、无白名单情况下挂到公网。 - 集群部署必须配置
XOSCAR_AUTH_KEY:HTTP API 认证不保护 actor 端口;未设置密钥时 actor 传输不做认证,需用网络安全组 / 防火墙把 actor 端口限制在可信集群节点之间;认证本身不加密流量、不防重放。 XINFERENCE_ALLOWED_IPS、反向代理层鉴权、TLS 终结应在对外部署时叠加;API Key、JWT 密钥、加密密钥妥善保管并定期轮换;XINFERENCE_MEDIA_BLOCK_PRIVATE_ADDRESS默认开启 SSRF 防护,不要在公网部署中关闭。XINFERENCE_AUTH_ADVANCED=false仅适用于完全受信的单机内网调试,关闭后接口与控制台不做账号校验。
11.5 数据隐私
- 单机默认模式下,提示词、参考图、音频与生成结果保存在本机磁盘与
XINFERENCE_HOME目录;使用远程模型站、云端插件或把服务暴露到公网后,数据流向由对应服务与配置决定。 - 模型缓存、启动历史、认证库与审计日志可能包含用户名、配置与请求记录;备份、迁移与磁盘报废时按内部数据管理制度处理。
- API Key、模型站
Token、代理口令只保存在本机环境变量、
.env或密钥管理系统中,不要写入公开仓库、截图、文档、Issue 或聊天记录;提交官方 Issue 时附上日志前先脱敏。
11.6 免责声明
项目按现状(AS-IS)提供,官方不保证在特定硬件、系统版本、引擎组合与模型权重下持续可用,不保证生成结果正确、合规或无侵权风险;使用者自行承担出图 / 出文质量、模型许可、内容版权、数据泄露与业务损失风险。如认为仓库内特定文件侵犯合法权益,请通过 GitHub Issues 提交说明,不要在公开 Issue 中上传账号凭据、模型 Token、未公开图片或敏感配置。