

SadTalker · 音频驱动单张人像照片说话头动画 · 中文部署与使用全指南
项目仓库: https://github.com/OpenTalker/SadTalker
开源协议:Apache 2.0(官方已移除非商业限制) · 开发语言:Python(PyTorch) · 论文:CVPR 2023,arXiv:2211.12194 · 环境:Linux 官方 conda 环境 Python 3.8 + PyTorch 1.12.1(cu113) · WebUI:Gradio(默认 7860 端口) · 模型权重:GitHub Releases / Google Drive / 百度网盘 · 输入:一张人像照片(或视频)+ 一段 wav / mp3 音频
1 项目简介
SadTalker 是一个音频驱动单张人像照片生成说话头视频的开源研究项目,论文 SadTalker: Learning Realistic 3D Motion Coefficients for Stylized Audio-Driven Single Image Talking Face Animation 被 CVPR 2023 收录。官方一句话定位(TL;DR):单张人像照片 🙎♂️ + 音频 🎤 = 说话头视频 🎞。项目先从音频预测 3D 面部表情系数与头部姿态系数,再由面部渲染模型把姿态与表情驱动到输入人像上,最后可选接入人脸增强与背景增强。
作者单位为西安交通大学、腾讯 AI Lab 与蚂蚁集团。官方在免责声明中明确:本项目不是腾讯官方产品;未经腾讯书面许可,不得使用腾讯合法拥有的名称或标识。
非官方声明:本文依据官方 README、
docs/install.md、docs/best_practice.md、docs/FAQ.md、requirements.txt、inference.py与scripts/download_models.sh整理部署步骤;项目为学术研究代码,官方未提供打包好的在线服务承诺,效果、稳定性与硬件表现以仓库最新版本为准。项目内置模型仅面向真实人物或接近真实人物的人像照片,官方说明动漫 / 卡通风格说话头生成不在当前能力范围内。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | SadTalker |
| 仓库地址 | github.com/OpenTalker/SadTalker |
| 项目定位 | 音频驱动单张人像照片的说话头(Talking Head)动画生成 |
| 开源协议 | Apache 2.0(README Highlights:已更新为 Apache 2.0,移除非商业限制) |
| 论文 / 出处 | CVPR 2023,arXiv:2211.12194 |
| 开发语言 / 框架 | Python 3.8(Linux 官方环境)、PyTorch 1.12.1+cu113、torchaudio 0.12.1、Gradio |
| 输入 | 驱动音频(wav / mp3)+ 源人像照片或视频 |
| 输出 | results/<时间戳>/*.mp4 说话头视频 |
| 部署方式 | 官方一键脚本 webui.sh / webui.bat;conda
源码环境 + inference.py CLI;第三方社区 Docker
镜像(非官方) |
| WebUI 端口 | Gradio 默认 7860(app_sadtalker.py /
launcher.py 调用 demo.launch()
未显式指定端口) |
| 模型权重渠道 | GitHub Releases(v0.0.2-rc)、Google Drive、百度网盘(提取码
sadt);GFPGAN 离线补丁 gfpgan/weights |
| 人脸增强 | --enhancer gfpgan /
RestoreFormer;背景增强
--background_enhancer realesrgan |
| 系统入口 | WebUI:python app_sadtalker.py 或
bash webui.sh;CLI:python inference.py ... |
1.2 适用场景
- 为已有真人照片生成与音频口型、表情、头部姿态匹配的说话视频,用于演示、教学旁白、短视频素材研究等。
- 在本地或自有服务器离线跑通音频驱动说话头流水线,复现 CVPR 2023 论文方法。
- 作为 Stable Diffusion WebUI 扩展接入(官方提供
docs/webui_extension.md),在绘图工作流内生成说话人脸。 - 结合参考视频控制眨眼(
--ref_eyeblink)或头部姿态(--ref_pose),提升动作自然度。 - 研究自由视角说话头:通过
--input_yaw、--input_pitch、--input_roll控制头部朝向变化。
1.3 能力边界(官方口径)
- 人像类型:官方
docs/best_practice.md明确模型只在真实人物或接近真实人物的人像上工作;动漫风格说话头生成方法官方称将在未来版本发布,当前不支持。 - 音频格式:FAQ 明确仅支持 wav 或 mp3 作为输入;其他格式需先转码。
- 姿态与表情强度:
--expression_scale控制表情幅度,--still模式保持与原图一致的姿态、减少头部运动;姿态风格由--pose_style(取值[0, 46))选择。 - 预处理模式:
--preprocess支持crop、extcrop、resize、full、extfull;resize适合证件照类正面人像,对全身人像效果差;full需配合--still把裁剪区域贴回原图。 - 离线运行:README 免责声明说明本开源代码完全离线运行,不收集任何个人信息或其他数据;在线收集数据需由部署方自行合规。
- 官方 README 未逐字公布最低显存、内存与 CPU 核数硬性指标;旧版模型清单与新版 safetensors 打包模型并存,硬件余量以实际加载日志为准,以官方仓库最新说明为准。
2 功能特性
2.1 音频驱动的 3D 系数预测
- 表情网络(ExpNet):从音频预测面部表情系数;
- 姿态 VAE(PoseVAE):从音频预测头部姿态系数;
- MappingNet:映射得到 3D 运动系数;
- 面部渲染(face-vid2vid 复现):把系数渲染到源人像上,输出说话头视频。
2.2 多种生成模式
- Still 模式:
--still使用与原图相同的姿态参数,头部动作更少,适合全身 / 整图动画。 - 参考眨眼:
--ref_eyeblink从参考视频借用眨眼动作,使眼部更自然;参考视频短于音频时自动循环。 - 参考姿态:
--ref_pose从参考视频借用头部姿态。 - 全身 / 整图模式:
--preprocess full自动处理裁剪区域并贴回原图,配合--still与增强器效果更好。 - 自由视角:
--input_yaw、--input_pitch、--input_roll按角度序列生成头部朝向变化的新视角说话头。 - 3D 可视化:
--face3dvis生成 3D 人脸与 3D 面部关键点(需额外安装,见docs/face3d.md)。
2.3 画质增强
- 人脸增强:
--enhancer gfpgan或RestoreFormer,通过人脸修复网络提升面部清晰度。 - 背景增强:
--background_enhancer realesrgan,对整段视频背景做超分辨率增强。 - 512 面部模型:2023.06.05 更新发布
512×512(beta)人脸模型,对应
SadTalker_V0.0.2_512.safetensors。
2.4 界面与集成
- 本地 Gradio Demo:与 Hugging Face 在线 Demo 类似的本地界面。
- Stable Diffusion WebUI 扩展:官方提供
docs/webui_extension.md接入说明。 - Colab / HF Space / Replicate / Discord:官方 README 提供在线体验与社区入口(见第 4 章)。
3 官方界面预览
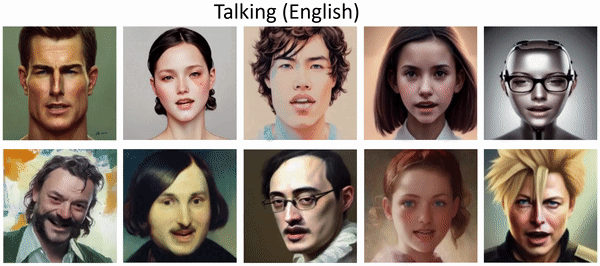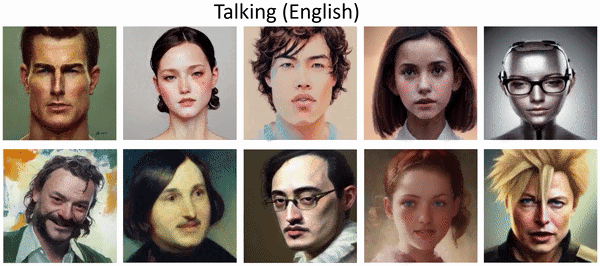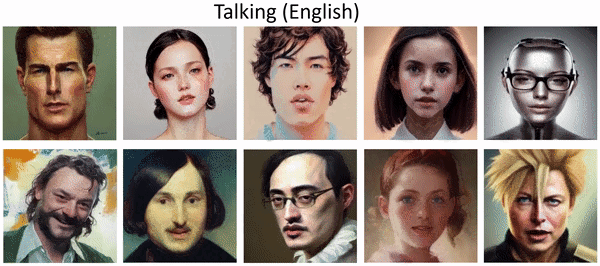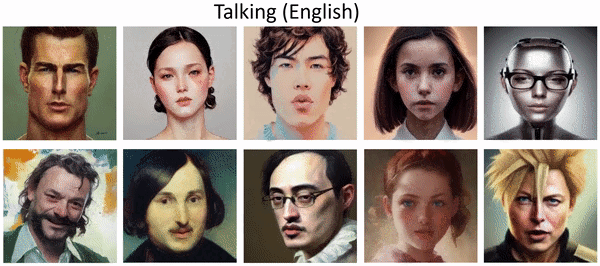
图2 为 README 顶部内嵌的官方演示 GIF,展示"照片 + 音频 →
说话头视频"的整体效果;本地 python app_sadtalker.py
启动后的 Gradio
界面包含源图上传、音频上传、预处理模式、姿态风格、表情幅度、增强器与参考视频等控件,具体布局以本地启动版本为准。
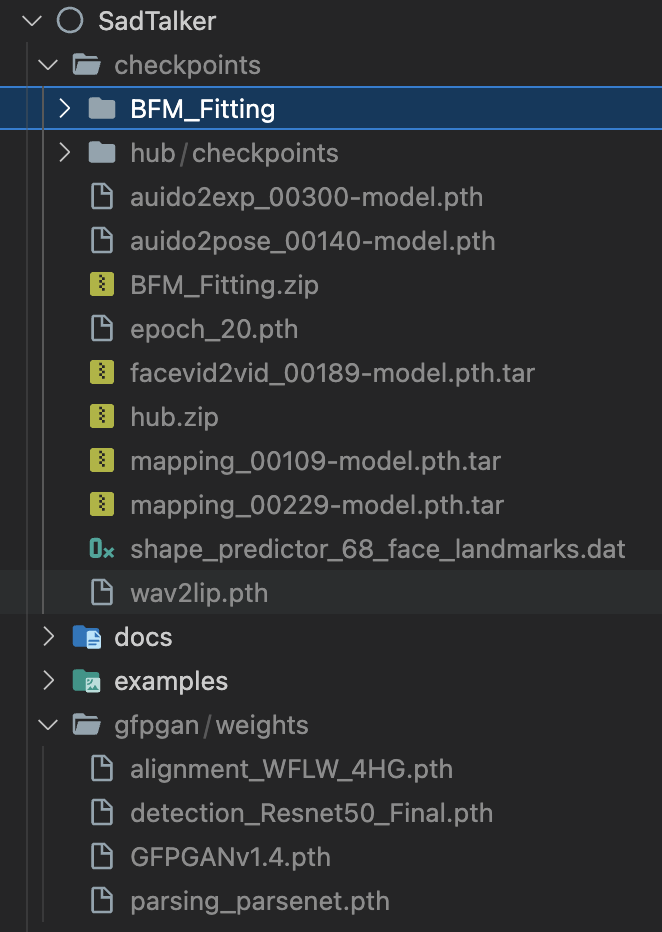
图3 为 README"Model
Details"折叠区给出的检查点目录参考;当前新版下载脚本主要放置
SadTalker_V0.0.2_256.safetensors、SadTalker_V0.0.2_512.safetensors
与 MappingNet 权重,旧版 .pth 文件清单见第 8.2
节。
4 官方跳转链接汇总
下表列出项目相关的官方入口,均可直接点击访问。
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | https://github.com/OpenTalker/SadTalker | 源码、README、推理脚本与 WebUI |
| 项目主页 | https://sadtalker.github.io | 官方论文与演示站 |
| 论文 PDF | arxiv.org/abs/2211.12194 | CVPR 2023 论文 |
| 在线 Demo(HF Space) | huggingface.co/spaces/vinthony/SadTalker | 官方在线体验 |
| Colab Notebook | quick_demo.ipynb | 官方 Colab 快速演示 |
| Issues 反馈 | https://github.com/OpenTalker/SadTalker/issues | Bug 反馈与问题讨论 |
| FAQ 文档 | docs/FAQ.md | 常见报错与处理 |
| 最佳实践 | docs/best_practice.md | 预处理、增强、参考模式与自由视角说明 |
| 安装补充文档 | docs/install.md | macOS、Windows 原生、WSL、社区 Docker 说明 |
| SD WebUI 扩展 | docs/webui_extension.md | Stable Diffusion WebUI 接入方式 |
| 模型 Releases | github.com/OpenTalker/SadTalker/releases | 新版 safetensors 与 MappingNet 权重 |
| 模型 Google Drive | 预训练模型 | 官方网盘备用渠道 |
| 模型百度网盘 | pan.baidu.com/s/1kb1BCPaLOWX1JJb9Czbn6w | 提取码 sadt |
| GFPGAN 离线补丁 | Google Drive / Releases / 百度网盘(提取码 `sadt`) | 人脸检测与增强模型 |
| Discord | discord.gg/rrayYqZ4tf | 官方社区 |
| 许可证 | LICENSE | Apache 2.0 |
5 前置要求与服务器配置
5.1 软件前提
- Git:用于克隆仓库。
- Conda(Linux / macOS 官方路径):安装 Anaconda,官方在 conda 环境中创建 Python 3.8。
- Python 版本:Linux 官方环境
python=3.8;launcher.py的版本检查支持 Python 3.7–3.11(以仓库最新launcher.py为准)。 - PyTorch(Linux / Windows CUDA):官方命令安装
torch==1.12.1+cu113、torchvision==0.13.1+cu113、torchaudio==0.12.1,CUDA 索引https://download.pytorch.org/whl/cu113。 - ffmpeg:Linux 用
conda install ffmpeg;macOS 用brew install ffmpeg;Windows 需把ffmpeg加入%PATH%。 - Python
依赖:
pip install -r requirements.txt(requirements.txt锁定numpy==1.23.4、face_alignment==1.3.5、librosa==0.9.2、kornia==0.6.8、basicsr==1.4.2、facexlib==0.3.0、gfpgan、gradio、av、safetensors等)。 - 可选 Coqui TTS:Gradio Demo
内的文本转语音功能可选,README 注明需另行
pip install TTS;不安装不影响"音频 + 照片"的核心推理。 - dlib(macOS):
docs/install.md要求 macOS 单独pip install dlib安装原始 dlib。
5.2 硬件建议(官方口径与说明)
| 项目 | 说明 |
|---|---|
| GPU | 官方 Linux 命令基于 CUDA 11.3 安装 PyTorch;有 NVIDIA
显卡可显著加速渲染;inference.py 提供 --cpu
开关可在 CPU 模式运行(速度较慢) |
| 显存 | README 未给出硬性显存下限;FAQ 提供 CUDA 显存不足时的
PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128 缓解方案 |
| 内存 / 存储 | 需容纳检查点、GFPGAN 权重与渲染中间结果;模型大小以 Releases 实际下载为准 |
| 操作系统 | Linux(官方主要测试环境)、Windows 原生、macOS(M1 13.3 测试记录)、Windows WSL |
说明:官方未公布逐模型显存占用、内存下限与采样率清单;本节未补充臆造数值。先按第 7 章完成环境,再用示例音频与照片实测;显存不足时按第 10.6 节调整分配参数或启用 CPU 模式。
5.3 端口分配
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
| 7860 | Gradio WebUI | Gradio 默认本机 / 局域网 | 浏览器访问本地 Demo 界面 |
远程服务器运行 WebUI 时,建议通过 SSH 隧道或带认证的反向代理访问 7860 端口,不要把界面不加鉴权地直接暴露到不可信公网。
6 方式一:官方一键脚本启动 WebUI(本地推荐路径)
容器化现状(如实说明):SadTalker 仓库未随附官方 Dockerfile 与
docker-compose.yml,本章不编造 Compose 文件。官方推荐的本地一键路径是webui.sh(Linux / macOS)与webui.bat(Windows);第三方社区 Docker 镜像作为非官方备选在第 7.5 节单列说明。
6.1 Linux / macOS 一键脚本
git clone https://github.com/OpenTalker/SadTalker.git
cd SadTalker

# 先按第 7 章完成 conda 环境与模型下载,再启动 WebUI
bash webui.sh
webui.sh
的主要行为(供排障对照,以仓库最新脚本为准):
- 检测
git与python3、python3-venv是否可用; - 在项目目录创建并激活
venv虚拟环境; - 默认
TORCH_COMMAND安装torch==1.12.1+cu113 torchvision==0.13.1+cu113 torchaudio==0.12.1(macOS 分支使用pip install torch==1.12.1 torchvision==0.13.1;AMD 显卡按脚本内 ROCm 分支处理); - 执行
launcher.py,由其检查 Python 版本、安装依赖并from app_sadtalker import sadtalker_demo后demo.launch()启动 Gradio。
6.2 Windows 一键脚本
- 安装 Python 3.8 并勾选 "Add Python to PATH";
- 安装
git与ffmpeg(ffmpeg需在%PATH%中); - 克隆仓库(README Windows 小节给出镜像地址
https://github.com/Winfredy/SadTalker.git); - 按第 7.3 节下载检查点与 GFPGAN 模型;
- 在资源管理器中以普通非管理员用户身份双击
webui.bat,脚本自动安装依赖并启动 Gradio Demo。
6.3 直接启动 Gradio Demo
依赖环境就绪后,也可以直接运行:
python app_sadtalker.py浏览器打开 Gradio 默认地址(通常为
http://127.0.0.1:7860),上传源图与音频,选择预处理模式、姿态风格、表情幅度与增强器后生成视频。
6.4 WebUI 常用操作
- 上传
source_image(人像照片或视频)与driven_audio(wav / mp3); - 选择
preprocess模式、pose_style、expression_scale; - 按需勾选
still、选择enhancer(gfpgan / RestoreFormer)与background_enhancer(realesrgan); - 可选上传
ref_eyeblink、ref_pose参考视频; - 生成结果写入
results/目录。
7 方式二:源码 / conda 环境手动安装与 CLI 推理
7.1 Linux / Unix 环境安装(官方 README)
# 1. 安装 Anaconda、Python 与 git 后创建环境
git clone https://github.com/OpenTalker/SadTalker.git
cd SadTalker

conda create -n sadtalker python=3.8
conda activate sadtalker

# 2. 安装 CUDA 11.3 版本 PyTorch
pip install torch==1.12.1+cu113 torchvision==0.13.1+cu113 torchaudio==0.12.1 \
  --extra-index-url https://download.pytorch.org/whl/cu113

# 3. 安装 ffmpeg
conda install ffmpeg

# 4. 安装项目依赖
pip install -r requirements.txt

# 可选:Gradio Demo 内文本转语音功能
# pip install TTS
7.2 macOS 环境(docs/install.md,M1 Mac 13.3 测试记录)
git clone https://github.com/OpenTalker/SadTalker.git
cd SadTalker

conda create -n sadtalker python=3.8
conda activate sadtalker

# 安装 PyTorch(文档记录安装 PyTorch 2.0)
pip install torch torchvision torchaudio

conda install ffmpeg
pip install -r requirements.txt

# macOS 需要单独安装原始 dlib
pip install dlib
7.3 下载模型权重
Linux / macOS 自动下载脚本:
bash scripts/download_models.sh脚本主要动作(以仓库最新版本为准):
- 创建
./checkpoints目录; - 从 GitHub Releases
v0.0.2-rc下载:mapping_00109-model.pth.tarmapping_00229-model.pth.tarSadTalker_V0.0.2_256.safetensorsSadTalker_V0.0.2_512.safetensors
- 创建
./gfpgan/weights并下载:alignment_WFLW_4HG.pth(facexlib)detection_Resnet50_Final.pth(facexlib)GFPGANv1.4.pth(GFPGAN)parsing_parsenet.pth(facexlib)
网络无法访问 GitHub Releases 时,可从 README 提供的 Google
Drive、百度网盘(提取码 sadt)手动下载对应文件,放入
checkpoints/ 与 gfpgan/weights/
对应位置。GFPGAN 离线补丁用于避免生成过程中再联网下载增强模型。
7.4 CLI 推理
默认配置:照片 + 音频 + 人脸增强
python inference.py --driven_audio <audio.wav> \
                    --source_image <video.mp4 or picture.png> \
                    --enhancer gfpgan
结果保存到 results/$SOME_TIMESTAMP/*.mp4。
全身 / 整图生成(Still + full 预处理)
python inference.py --driven_audio <audio.wav> \
                    --source_image <video.mp4 or picture.png> \
                    --result_dir <a file to store results> \
                    --still \
                    --preprocess full \
                    --enhancer gfpgan
自由视角头部朝向
python inference.py --driven_audio <audio.wav> \
                    --source_image <video.mp4 or picture.png> \
                    --result_dir <a file to store results> \
                    --input_yaw -20 30 10
--input_yaw -20 30 10 表示头部 yaw 角度先从
-20 到 30,再从 30 到
10;--input_pitch、--input_roll
用法相同。
CPU 模式
python inference.py --driven_audio <audio.wav> \
                    --source_image <picture.png> \
                    --cpu
7.5 第三方社区 Docker 镜像(非官方备选)
docs/install.md 提供一个由社区成员 @thegenerativegeneration
维护的 Docker 镜像 wawa9000/sadtalker,不属于
OpenTalker 官方发布,可用性与安全性由镜像作者负责:
docker run --gpus "all" --rm -v $(pwd):/host_dir wawa9000/sadtalker \
    --driven_audio /host_dir/deyu.wav \
    --source_image /host_dir/image.jpg \
    --expression_scale 1.0 \
    --still \
    --result_dir /host_dir
说明:该镜像命令参数直接透传给
inference.py;生产或对外服务前请自行核对镜像来源、依赖版本与模型许可,不要把第三方镜像当作官方产物。
8 配置项说明
8.1
inference.py 主要参数(来自源码
argparse)
| 参数 | 默认值 | 取值 / 说明 |
|---|---|---|
--driven_audio |
./examples/driven_audio/bus_chinese.wav |
驱动音频路径,仅 wav / mp3 |
--source_image |
./examples/source_image/full_body_1.png |
源人像照片或视频路径 |
--ref_eyeblink |
None |
参考视频,借用眨眼动作;短于音频时循环 |
--ref_pose |
None |
参考视频,借用头部姿态 |
--checkpoint_dir |
./checkpoints |
检查点目录 |
--result_dir |
./results |
结果输出目录 |
--pose_style |
0 |
姿态风格,整数范围 [0, 46) |
--batch_size |
2 |
面部渲染批大小 |
--size |
256 |
面部渲染图像尺寸;可选 512(beta 模型) |
--expression_scale |
1.0 |
表情幅度系数,越大动作越强 |
--input_yaw |
None |
自由视角 yaw 角度序列,如 -20 30 10 |
--input_pitch |
None |
自由视角 pitch 角度序列 |
--input_roll |
None |
自由视角 roll 角度序列 |
--enhancer |
None |
人脸增强器:gfpgan、RestoreFormer |
--background_enhancer |
None |
背景增强器:realesrgan |
--cpu |
False |
启用 CPU 模式(--cpu 开关) |
--face3dvis |
False |
生成 3D 人脸与 3D 关键点(需额外安装) |
--still |
False |
Still 模式:保持原图姿态、减少头部运动 |
--preprocess |
crop |
crop、extcrop、resize、full、extfull |
--verbose |
False |
保存中间输出 |
--old_version |
False |
使用 .pth 旧版权重而非 safetensors 版本 |
--net_recon |
resnet50 |
重建网络选择:resnet18、resnet34、resnet50(源码标注该参数实际未启用) |
--bfm_folder |
./checkpoints/BFM_Fitting/ |
3DMM 拟合模型目录 |
--bfm_model |
BFM_model_front.mat |
BFM 模型文件名 |
8.2 模型目录与权重清单
新版(v0.0.2-rc,默认 safetensors 打包模型)
| 文件 | 说明 |
|---|---|
checkpoints/mapping_00229-model.pth.tar |
预训练 MappingNet |
checkpoints/mapping_00109-model.pth.tar |
预训练 MappingNet |
checkpoints/SadTalker_V0.0.2_256.safetensors |
打包检查点,256 面部渲染 |
checkpoints/SadTalker_V0.0.2_512.safetensors |
打包检查点,512 面部渲染(beta) |
gfpgan/weights |
facexlib 与 gfpgan
所用人脸检测、增强模型 |
旧版(--old_version 或历史 Release
包内)
| 文件 | 说明 |
|---|---|
checkpoints/auido2exp_00300-model.pth |
ExpNet 表情网络 |
checkpoints/auido2pose_00140-model.pth |
PoseVAE 姿态网络 |
checkpoints/facevid2vid_00189-model.pth.tar |
face-vid2vid 复现模型 |
checkpoints/epoch_20.pth |
Deep3DFaceReconstruction 3DMM 提取器 |
checkpoints/wav2lip.pth |
高精度唇形同步模型(Wav2Lip) |
checkpoints/shape_predictor_68_face_landmarks.dat |
dlib 68 点人脸关键点模型 |
checkpoints/BFM |
3DMM 基础模型库 |
checkpoints/hub |
face alignment 人脸检测模型 |
8.3 预处理模式选型(docs/best_practice.md)
| 模式 | 适用输入 | 说明 |
|---|---|---|
crop |
近景人脸 | 按人脸关键点裁剪后生成表情与姿态动画,动作最自然 |
extcrop |
扩展裁剪 | 在 crop 基础上扩大裁剪范围 |
resize |
证件照类正面人像 | 整图缩放生成说话头;全身人像效果差 |
full |
全身 / 整图 | 自动处理裁剪区域并贴回原图;建议配合 --still |
extfull |
扩展整图 | 整图模式的扩展版本 |
Still 模式会停止眨眼与头部姿态运动;
full模式不配合--still时头部姿态容易脱离原图。
8.4 增强器安装依赖
pip install gfpgan          # 人脸增强
pip install realesrgan      # 背景增强
9 常用运维命令
# 激活 / 退出 conda 环境
conda activate sadtalker
conda deactivate

# 重新安装项目依赖(修改 requirements.txt 后)
pip install -r requirements.txt

# 重新下载 / 补全模型权重
bash scripts/download_models.sh

# 启动本地 Gradio Demo
python app_sadtalker.py

# 或使用一键脚本
bash webui.sh

# 查看推理参数帮助
python inference.py -h

# 清理上一次生成的中间结果(谨慎,results 目录下为用户产物)
ls results/更新代码:git pull 后重新
pip install -r requirements.txt,并按 Releases
说明核对是否需要更新检查点。备份时保留
checkpoints/、gfpgan/weights/ 与自己的
results/ 产物;下载的模型权重不要提交到公开仓库。
10 常见故障排查
10.1 ffmpeg
不是内部或外部命令(FAQ)
现象:Windows 提示
ffmpeg is not recognized;Linux / macOS 音频解码失败。
处理:
- Linux:
conda install ffmpeg; - macOS:
brew install ffmpeg; - Windows:把
ffmpeg加入系统%PATH%,按 FAQ #54 与官方教程配置。
10.2
ModuleNotFoundError: No module named 'ai'(FAQ)
处理:检查 epoch_20.pth
的文件大小是否完整;多为模型下载不完整或损坏,删除后重新从 Releases /
网盘下载(参考 FAQ #167、#113)。
10.3 macOS M1 报 Illegal Hardware Error(FAQ)
处理:单独重装 dlib:
pip install dlib对应 FAQ #129、#109。
10.4
FileNotFoundError: checkpoints/BFM_Fitting/similarity_Lm3D_all.mat(FAQ)
原因:检查点与 GFPGAN 模型未下载完整,或目录放置位置错误。
处理:按第 7.3 节重新下载模型,确认
checkpoints/BFM_Fitting/、checkpoints/、gfpgan/weights/
内文件齐全、路径正确。
10.5
RuntimeError: unexpected EOF, expected ... bytes. The file might be corrupted.(FAQ)
原因:权重文件未自动下载完整,属于损坏文件。
处理:更新代码后手动下载 GFPGAN 文件夹与检查点;删除损坏文件重新下载,避免断点残留。
10.6 CUDA out of memory(FAQ)
处理:设置 PyTorch CUDA 内存分配切分大小后重试:
# Windows
set PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128
python inference.py ...

# Linux
export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128
python inference.py ...
仍不足时降低 --batch_size、改用 256 尺寸模型,或加
--cpu 在 CPU 上慢速运行。
10.7
音频解码报错
Invalid data found when processing input(FAQ)
现象:MP3 头缺失或格式不支持。
处理:项目只支持 wav 或 mp3;先用
ffmpeg 把音频转成 wav / mp3 后再作为 --driven_audio
输入。
10.8 WSL 环境库路径缺失(docs/install.md)
处理:先导出 WSL 图形 / 库路径:
export LD_LIBRARY_PATH=/usr/lib/wsl/lib:$LD_LIBRARY_PATH再激活环境并启动推理或 WebUI。
10.9 人物动作僵硬或五官变形
排查:
- 确认输入是真实人物或接近真实人物的正面、清晰、无强遮挡人像;
crop模式下脸部应完整入镜;全身素材改用--preprocess full --still;- 表情幅度过大时调小
--expression_scale; - 检查参考视频
ref_eyeblink/ref_pose是否清晰、人脸对齐; - 启用
--enhancer gfpgan改善面部清晰度。
11 风险与合规说明
11.1 许可证范围
- 本项目代码按 Apache 2.0 发布;README Highlights
明确许可证已更新为 Apache 2.0 并移除非商业限制,具体条款以仓库
LICENSE原文为准。 - 实现中借用了 face-vid2vid 复现、PIRender、Deep3DFaceReconstruction、Wav2Lip、facexlib、GFPGAN、Real-ESRGAN 等第三方开源模型与库,集成分发时需同时核对各自许可证。
- 模型权重的适用条款以对应 Releases 与第三方模型仓库说明为准。
11.2 肖像权与声音授权(官方免责声明口径)
README Disclaimer 明确禁止使用本开源代码从事:
- 诈骗、欺骗、侵犯他人肖像权、名誉权等损害他人合法权益的活动;
- 其他违反法律法规或违背社会公序良俗的行为,包括提供虚假信息、传播色情、恐怖、暴力信息等。
使用要求:
- 只能使用本人拥有肖像权、或已取得肖像权人明确书面授权的照片;
- 驱动音频应为本人声音或已授权使用的声音;
- 不得把生成视频用于冒充真人身份、电信诈骗、虚假新闻、恶意诋毁或深度伪造欺骗;
- 对外发布 AI 生成的人物视频时,应按当地法规标注 AI 合成属性。
11.3 商标与归属限制(官方免责声明口径)
- 本项目不是腾讯官方产品;未经腾讯书面许可,不得使用"腾讯"等腾讯合法拥有的名称、商标或标识。
- 开源代码本身完全离线运行、不收集个人信息;若部署方用其对外提供服务并收集用户数据,须自行依法发布隐私政策、采取数据安全措施,涉及个人信息时取得用户同意;相关法律责任与腾讯无关。
- 本开源代码不具备直接面向终端用户提供服务的能力;若用于再训练、产品化对外服务等场景,部署方须自行遵守所在地区法律法规,产生的法律责任与腾讯无关。
11.4 数据与素材
- README 说明演示图片与音频版权归社区用户所有,或由 Stable Diffusion 生成;如认为某素材侵权,可联系官方仓库移除。
- 本地保存的参考照片、音频与生成视频属于敏感素材,应限制访问权限,不要提交到公开仓库或不可信服务器。
11.5 免责声明
本指南依据官方公开文档整理,命令、参数、端口与模型渠道均来自仓库
README、docs/install.md、docs/best_practice.md、docs/FAQ.md、requirements.txt、inference.py
与
scripts/download_models.sh;官方后续版本可能调整依赖版本、模型渠道与界面参数,部署时以仓库最新说明为准。作者与本文不对因使用、修改或运行本项目产生的直接或间接损失承担责任,法律不得排除或限制的责任除外。