
PaddleOCR:超详细部署与使用教程
PaddleOCR 是百度飞桨(PaddlePaddle)开源的超轻量级 OCR 系统,集文字检测、方向分类、文本识别、文档解析于一体的文字识别与文档解析开发套件,支持 80+ 语言识别,并持续推出 PP-OCRv5、PP-StructureV3、PP-ChatOCRv4 等系列模型。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 百度(飞桨 PaddlePaddle 团队) | github.com/PaddlePaddle/PaddleOCR | 文档站:paddlepaddle.github.io/PaddleOCR ;产品官网:www.paddleocr.com | Apache-2.0 | 约 92k | v3.7.0 | Python |
目录
一、项目概述
1.1 项目定位
PaddleOCR 是百度飞桨团队开源的文字识别与文档解析开发套件,主打「开箱即用、训推一体、产业级可用」。它提供完整 OCR 工具链:数据合成与标注 → 模型训练 → 模型压缩 → 推理部署 → 服务化部署 → 大模型接入。官方提供 80+ 语言识别模型、版面分析、表格/公式/印章/图表识别、文档比对、智能文档理解(PP-ChatOCRv4)等能力,广泛应用于票据、证照、工业文档、金融财报等场景。其轻量级 PP-OCRv5 系列模型可在 CPU 上高效运行,也支持 GPU / XPU / NPU。
1.2 核心功能
- 通用文字识别:PP-OCRv3 / PP-OCRv4 / PP-OCRv5 系列,检测 + 方向分类 + 识别三段式管线,支持中英文及 80+ 语言。
- 通用文档解析(PP-StructureV3):版面分析、表格识别(含图表转表格)、公式识别、印章识别、OCR 结果结构化输出。
- 智能文档理解:PP-ChatOCRv4(文档问答)、PP-DocBee2、文档翻译(PP-DocTranslation),可接入大模型。
- 文档方向矫正与还原:方向分类、弯曲文档矫正(use_doc_unwarping)等预处理能力。
- 训推一体工具链:一条命令启动训练;三行代码推理;一条命令启动高性能服务化部署;提供 MCP 服务器轻松接入大模型。
- 多硬件支持:CPU / GPU(NVIDIA CUDA)/ XPU(昆仑芯)/ NPU(昇腾),Python 3.8–3.12,支持 Linux / Windows / macOS。
- 多模型下载源:支持 AI Studio、ModelScope 等模型下载源,可指定。
- 多体量模型选择:PP-OCRv5 系列提供不同体量的模型变体(轻量级用于端侧/CPU、高精度用于服务器),可按设备性能选用(以官方模型库列表为准)。
1.3 技术架构
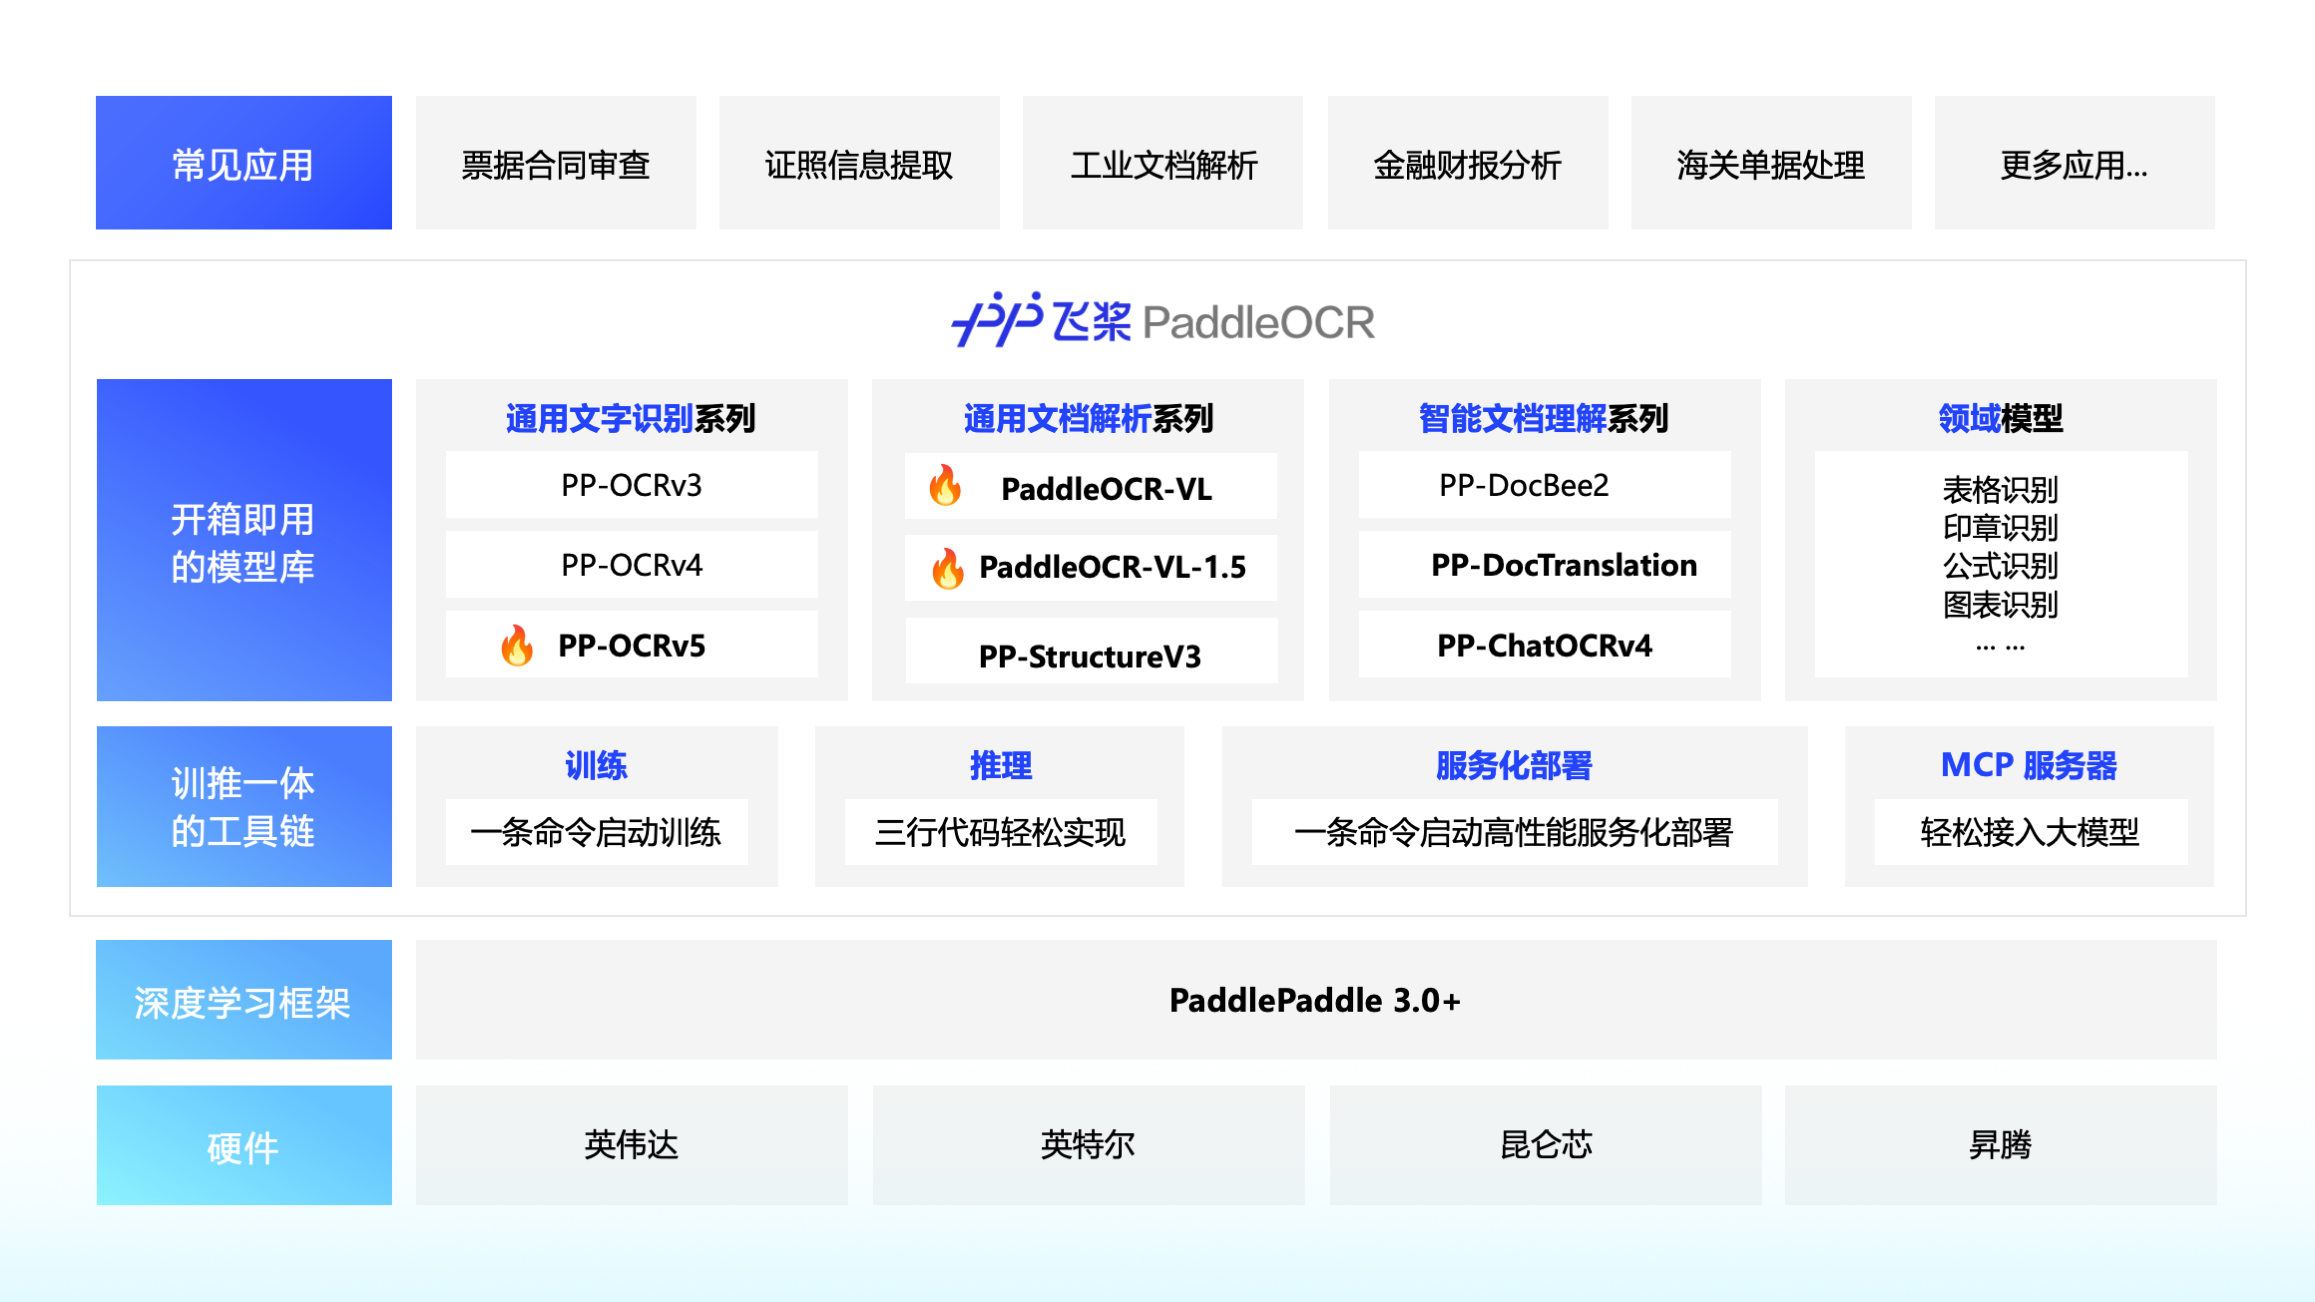
下图是 PaddleOCR 官方文档中的功能架构总览:顶部为常见应用(票据合同审查、证照信息提取、工业文档解析、金融财报分析、海关单据处理等);中部为开箱即用的模型库(通用文字识别系列、通用文档解析系列、智能文档理解系列、领域模型);底部为训推一体的工具链(训练、推理、服务化部署、MCP 服务器)以及底层深度学习框架(PaddlePaddle 3.0+)与硬件支持(NVIDIA、Intel、昆仑芯、昇腾)。

二、环境要求
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux(推荐)/ Windows / macOS |
| Python | 3.8 – 3.12(官方徽章标注;具体以各版本 requirements 为准) |
| 硬件 | CPU 即可运行(PP-OCRv5 轻量模型);GPU 需 NVIDIA 显卡 + CUDA(训练与高吞吐推荐) |
| 内存 | 推理 ≥ 2GB;训练视模型与 batch 而定(官方建议 8GB+,以文档为准) |
| 磁盘 | 安装依赖 + 模型缓存 ≥ 5GB 可用空间 |
| 深度学习框架 | PaddlePaddle(CPU 版 paddlepaddle / GPU 版 paddlepaddle-gpu),PaddleOCR 3.x 建议 PaddlePaddle 3.0+(以官方安装页为准) |
| 包管理 | pip 或 conda |
安装 PaddlePaddle 前建议先到官方安装页按你的系统/显卡生成精确安装命令:https://www.paddlepaddle.org.cn/install/quick
三、部署方式
3.1 方式一:pip 安装(CPU,最快上手)
# 1) 创建虚拟环境(推荐)
python3 -m venv ocr_env && source ocr_env/bin/activate

# 2) 安装飞桨框架(CPU 版)
python -m pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple

# 3) 安装 PaddleOCR
python -m pip install paddleocr -i https://mirror.baidu.com/pypi/simple
验证安装:
python -c "import paddle; print(paddle.__version__)"
python -c "import paddleocr; print(paddleocr.__version__)"
3.2 方式二:GPU 安装(CUDA)
先在官方安装页(https://www.paddlepaddle.org.cn/install/quick )选择「GPU 版 + 你的 CUDA 版本」,复制生成的命令执行,例如(以官网生成命令为准,勿照抄此示例版本号):
python -m pip install paddlepaddle-gpu==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
python -m pip install paddleocr -i https://mirror.baidu.com/pypi/simple
验证 GPU 可用:
python -c "import paddle; paddle.utils.run_check()" # 出现 PaddlePaddle is installed successfully 即正常
3.3 方式三:源码安装(开发/定制)
git clone https://github.com/PaddlePaddle/PaddleOCR.git
cd PaddleOCR
python -m pip install -r requirements.txt
python -m pip install -e .
源码安装适合需要修改源码、二次开发或体验最新特性(如 PaddleOCR-VL)的场景;
requirements.txt内容随版本变化,以仓库为准。
3.4 方式四:Docker 部署(可选)
PaddleOCR 官方未提供一键式官方镜像(以官方文档为准),但仓库提供 Dockerfile 可自行构建:
cd PaddleOCR
docker build -t paddleocr:latest .
docker run -it --rm -v $(pwd):/workspace paddleocr:latest bash
3.5 验证部署成功(通用)
准备一张包含文字的图片(如 test.png),执行官方推荐的最小验证:
python - <<'EOF'
from paddleocr import PaddleOCR
ocr = PaddleOCR(use_doc_orientation_classify=False,
                use_doc_unwarping=False,
                use_textline_orientation=False,
                lang="ch")
result = ocr.predict(input="test.png")
print(result)
EOF
输出中包含识别文本行(rec_texts、rec_scores)即部署成功。首次运行会自动下载模型(默认从官方模型源下载,需要网络)。
3.6 离线/内网环境部署(模型预下载)
生产内网环境通常无法直连官方模型源,需要提前在联网机器上下载模型,再拷贝到目标机器:
# 1) 在联网机器上先跑一次,模型会下载到缓存目录
python -c "from paddleocr import PaddleOCR; PaddleOCR(lang='ch')"

# 2) 查看缓存目录位置(不同版本略有差异,以实际输出为准)
python -c "import paddlex; print(paddlex.envs.MODEL_HOME)"   # 或直接看 ~/.paddlex / ~/.paddleocr

# 3) 将模型目录整体打包拷贝到内网机器的相同用户路径下
tar czf ocr_models.tar.gz ~/.paddlex
# 内网机器上:tar xzf ocr_models.tar.gz -C ~
模型缓存目录、环境变量(如
PADDLE_PDX_MODEL_SOURCE/PADDLE_OCR_DOWNLOAD_SOURCE)的具体名称随版本变化,离线部署前请以对应版本官方文档为准。
3.7 conda 方式安装(可选)
conda create -n paddle python=3.10 -y
conda activate paddle
pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple
pip install paddleocr -i https://mirror.baidu.com/pypi/simple
3.8 升级与卸载
# 查看当前版本
pip show paddleocr paddlepaddle

# 升级到最新版
pip install -U paddleocr -i https://mirror.baidu.com/pypi/simple

# 卸载
pip uninstall paddleocr paddlepaddle -y
PaddleOCR 大版本间(2.x → 3.x)API 有变化,升级前先读官方升级/更新日志(README 提供 History Log 链接)。
四、使用方法
4.1 基础用法:Python API(PaddleOCR 3.x)
from paddleocr import PaddleOCR

# 创建 OCR 实例,参数说明:
# lang="ch"       识别语言(ch 中文简体 / en 英文 / japan 日文等,可组合 "ch,en")
# device="gpu"    推理设备,默认 cpu;可选 gpu / xpu / npu
# engine="paddle" 推理引擎,可选 paddle / onnxruntime / openvino / tensorrt / transformers
# use_doc_orientation_classify  是否进行文档方向分类
# use_doc_unwarping             是否进行文档弯曲矫正
# use_textline_orientation      是否进行文本行方向分类
ocr = PaddleOCR(use_doc_orientation_classify=True,
                use_doc_unwarping=True,
                use_textline_orientation=True,
                lang="ch")

# 单张图片推理
result = ocr.predict(input="img/contract.jpg")

# 批量推理(传入目录/列表)
result = ocr.predict(input=["img/a.jpg", "img/b.jpg"])

# 结果解析:result[0] 为第一张图的结果字典
res = result[0]
for txt, score in zip(res["rec_texts"], res["rec_scores"]):
    print(f"文本: {txt}  置信度: {score:.4f}")
结果可视化与落盘(推荐做法):官方 predict 返回的 dict 中带 rec_polys(文本框坐标)、rec_boxes(检测框)、rec_scores(置信度)等字段;可视化可用 cv2/PIL 自行绘制,或将结构化结果保存为 JSON 供下游系统消费:
import json, cv2

res = result[0]
# 保存结构化结果(文本 + 坐标 + 置信度)
out = [{"text": t, "score": float(s),
        "box": b.tolist() if hasattr(b, "tolist") else b}
       for t, s, b in zip(res["rec_texts"], res["rec_scores"], res["rec_polys"])]
with open("ocr_result.json", "w", encoding="utf-8") as f:
    json.dump(out, f, ensure_ascii=False, indent=2)

# 在原图上绘制检测框
img = cv2.imread("img/contract.jpg")
for pts in res["rec_polys"]:
    pts = pts.astype("int32").reshape(-1, 2)
    cv2.polylines(img, [pts], True, (0, 255, 0), 2)
cv2.imwrite("img/contract_vis.jpg", img)
PDF 与多页文档:predict(input="xxx.pdf") 支持直接传入 PDF 路径,会逐页解析;也可传目录或文件列表批量推理(3.x 官方文档示例用法,具体字段以官方文档为准)。
4.2 常用命令:命令行(CLI)
PaddleOCR 2.x 时代的经典命令行(部分版本仍兼容;3.x 的 CLI 参数以官方文档为准):
# 识别单张图片(中文)
paddleocr --image_dir ./img/11.jpg --lang ch

# 使用 GPU 推理
paddleocr --image_dir ./img/11.jpg --lang ch --device gpu

# 查看帮助
paddleocr --help
4.3 进阶功能
- 文档解析(PP-StructureV3):解析 PDF/图片中的版面、表格、公式、印章,输出结构化结果:
python
  from paddleocr import PPStructureV3
  engine = PPStructureV3()
  result = engine.predict(input="doc.pdf")   # 支持 PDF 与图片
-
智能文档理解(PP-ChatOCRv4):文档问答/信息抽取,可接入大模型(Kimi/Qwen 等,按官方文档配置 API Key)。
-
指定模型下载源:PaddleOCR 支持从 AI Studio、ModelScope 等下载模型:
bash
  export PADDLE_OCR_DOWNLOAD_SOURCE=MODELSCOPE   # 或 AI_STUDIO / PADDLE 等
- 服务化部署(PaddleX / Paddle Serving):官方推荐一条命令启动高性能服务化部署(HTTP 服务),并提供 MCP 服务器轻松接入大模型应用;具体命令与镜像以官方「服务化部署」文档为准(paddlepaddle.github.io/PaddleOCR 文档站内有对应章节)。
- 模型下载源切换:PaddleOCR 支持从 AI Studio、ModelScope 等源下载模型,可设置环境变量指定(如
export PADDLE_OCR_DOWNLOAD_SOURCE=MODELSCOPE,变量名以官方文档为准),便于在海外/内网环境使用。 -
PaddleOCR-VL 多模态模型:仓库新增 PaddleOCR-VL / PaddleOCR-VL-1.5 多模态视觉语言模型(截图文字理解、长文档解析等场景),使用方式见官方模型卡片与文档。
-
模型训练/微调:PaddleOCR 训推一体,支持 PP-OCRv5 系列模型的检测、识别、方向分类独立训练与微调,数据准备(标注工具 PaddleLabel/PaddleOCR 数据格式)、训练(
tools/train.py)、评估(tools/eval.py)、导出(tools/export_model.py)的完整流程见官方文档「模型训练」章节。 -
MCP 服务器:官方提供 MCP 服务器,可轻松接入大模型应用(以官方文档为准)。
4.4 适用场景
- 票据、合同、发票、证照(身份证/营业执照/护照)的信息抽取;
- 工业文档解析:说明书、图纸文字、检测报告;
- 金融财报、海关单据的批量结构化;
- 多语言图文内容识别(80+ 语言)、拍照翻译;
- 结合大模型的文档问答、知识库构建(PP-ChatOCRv4);
- 端侧/边缘部署:PP-OCRv5 轻量模型可在 CPU 与国产芯片(昆仑芯/昇腾)上运行。
五、常见问题排查(FAQ)
Q1:安装时报错 ERROR: Could not find a version that satisfies the requirement paddlepaddle
- 原因:Python 版本过新(>3.12)或 pip 源无对应版本。
- 解决:使用 Python 3.8–3.12 的虚拟环境;换官方源 -i https://mirror.baidu.com/pypi/simple;GPU 版去官方安装页生成命令。
Q2:运行时提示 libGL.so.1: cannot open shared object file
- 原因:系统缺少 OpenGL 动态库。
- 解决:apt-get install -y libgl1 libglib2.0-0(Debian/Ubuntu);yum install -y libgl(CentOS)。
Q3:ImportError: cannot import name 'PaddleOCR' from 'paddleocr'
- 原因:安装的 PaddleOCR 版本过老(如 0.x)或与代码不匹配。
- 解决:升级到 3.x:pip install -U paddleocr;确认 import 路径正确。
Q4:首次运行模型下载失败/超时
- 原因:默认模型源(AI Studio)网络不通。
- 解决:切换模型下载源:export PADDLE_OCR_DOWNLOAD_SOURCE=MODELSCOPE;或手动下载模型到缓存目录(~/.paddlex/official_models 等,以官方文档为准)。
Q5:GPU 推理报错 PaddlePaddle is not compiled with CUDA 或显存不足
- 原因:安装的是 CPU 版 paddlepaddle,或 CUDA 版本不匹配,或 batch 过大。
- 解决:按官方安装页安装匹配 CUDA 的 paddlepaddle-gpu;python -c "import paddle; paddle.utils.run_check()" 验证;减小图片尺寸或 batch;--device gpu 前先确认 paddle.device.is_compiled_with_cuda()。
Q6:Windows 下识别中文乱码/控制台编码错误
- 解决:设置 PYTHONIOENCODING=utf-8;代码文件保存为 UTF-8;输出到文件时指定 encoding="utf-8"。
Q7:onnxruntime 引擎报错缺少依赖
- 解决:pip install onnxruntime(CPU)或 onnxruntime-gpu(GPU,版本需与 CUDA 匹配);指定 engine="onnxruntime" 时模型会自动转换。
Q8:识别结果为空或置信度极低
- 原因:图片过小/模糊、方向颠倒、文字非目标语言。
- 解决:开启方向分类(use_textline_orientation=True);提高图片分辨率;确认 lang 参数与图片语言一致。
Q9:提示模型下载 401 / 403 / 网络错误,或卡在下载阶段
- 原因:默认模型源不可达或被限流。
- 解决:换源:export PADDLE_OCR_DOWNLOAD_SOURCE=MODELSCOPE(或 AI_STUDIO);或按 3.6 节离线预下载模型后拷贝到缓存目录。
Q10:numpy / opencv-python / Pillow 等依赖版本冲突报错
- 原因:环境中已有其他项目安装的版本与 PaddleOCR 依赖不兼容。
- 解决:建议始终使用独立虚拟环境(venv/conda)安装 PaddleOCR;冲突时 pip install --upgrade numpy opencv-python-headless 或按报错提示固定版本(以官方 requirements 为准)。
六、部署注意事项与最佳实践
- 框架与套件版本匹配:PaddleOCR 3.x 建议搭配 PaddlePaddle 3.0+;版本不匹配会出现接口或算子兼容问题,安装前看官方安装页与 README 的版本说明。
- GPU 环境务必先验证:驱动、CUDA、cuDNN 版本要匹配,安装后用
paddle.utils.run_check()验证,别等到训练才发现。 - 模型缓存目录:模型默认下载到用户目录(
~/.paddlex/official_models或~/.paddleocr,以实际版本为准);离线环境可预先下载模型并放到对应目录。 - 生产服务化:不要直接用 Python 脚本当服务,推荐 PaddleX / Paddle Serving / 官方 MCP 服务器,开启模型常驻与并发。
- 中文路径问题:Windows 下图片/代码路径避免中文与特殊字符;Linux 下注意文件编码。
- 数据合规:识别身份证、票据等敏感信息时注意数据安全与合规要求。
- 性能优化:CPU 场景可开
use_onnx=True(旧版本参数)或engine="openvino";GPU 场景可开engine="tensorrt"(以官方文档为准)。 - 留意官方版本更新:PaddleOCR 迭代快(3.x 大版本间 API 有变化),使用前先读对应版本官方文档。
七、参考资料
- GitHub 仓库:https://github.com/PaddlePaddle/PaddleOCR
- 官方文档站:https://paddlepaddle.github.io/PaddleOCR/latest/
- 产品官网(在线体验):https://www.paddleocr.com
- 新文档站(PP-OCR 系列管线用法):https://www.paddleocr.ai/latest/zh/version3.x/pipeline_usage/OCR.html
- PaddlePaddle 官方安装页:https://www.paddlepaddle.org.cn/install/quick
- 模型库(PP-OCRv5 等):https://paddlepaddle.github.io/PaddleOCR/latest/zh/version3.x/models_list.html
- 模型训练文档:https://paddlepaddle.github.io/PaddleOCR/latest/zh/version3.x/training/training_introduction.html
- Release 下载:https://github.com/PaddlePaddle/PaddleOCR/releases