
llama.cpp(llama-server / llama-cli / llama-quantize)—— 纯 C/C++ 的高效本地 LLM 推理引擎
适用环境:Windows 10/11 原生、Windows 10/11 + WSL2(Ubuntu 24.04)、NVIDIA RTX 3070 8GB / RTX 4090 24GB,以及 Linux 云服务器。 信息口径:本章命令、编译参数、工具名、参数与端点均来自 llama.cpp 官方仓库 README、
docs/build.md、docs/models.md、tools/server/README.md、tools/cli/README.md、tools/quantize/README.md与官方 release 资产清单;核验日期 2026-10-25。
项目定位与基本信息
| 项目 | 内容 |
|---|---|
| 一句话定位 | 用纯 C/C++ 实现、基于 ggml 的 LLM/VLM 推理库与命令行工具集,支持 1.5-bit 到 8-bit 量化、CUDA/Vulkan/Metal/HIP 等多后端、CPU+GPU 混合推理,并自带 OpenAI 兼容 HTTP 服务器与内置 Web UI。 |
| 开源许可 | MIT License。出处:官方 README 徽章 [](https://opensource.org/licenses/MIT);仓库 LICENSE 文件 https://github.com/ggml-org/llama.cpp/blob/master/LICENSE(原始文件 https://raw.githubusercontent.com/ggml-org/llama.cpp/master/LICENSE,已实际打开核对,标题为 MIT License)。 |
| 官方 GitHub 仓库 | https://github.com/ggml-org/llama.cpp |
| 官方文档 / 站点 | https://github.com/ggml-org/llama.cpp/tree/master/docs (构建、模型、Docker、多 GPU 等官方文档索引);安装引导站 https://llama.app 。 |
| 版本信息 | 截至 2026-10-25:官方语义化稳定 release v0.7.0(发布于 2026-10-15,来源 https://github.com/ggml-org/llama.cpp/releases/tag/v0.7.0,页面 datetime="2026-10-15T17:13:19Z" 核验);预编译二进制发布在 Nightly 标签(b*),最新已核验资产为 b11874(发布于 2026-10-25,来源 https://github.com/ggml-org/llama.cpp/releases/tag/b11874)。README 徽章区分两类:Release 过滤 v*,Nightly 过滤 b*。 |
| 官方模型生态 | 兼容 Hugging Face 上所有 GGUF 模型:https://huggingface.co/models?library=gguf&sort=trending(来源 docs/models.md)。 |
官方图片
下图为官方 README 内嵌的两张官方截图(非 AI 生成、非第三方图):左为 llama cli 的 VLM 会话界面,右为 llama serve 内置 Web UI。
图 1:llama cli 命令行会话(官方 README 截图)
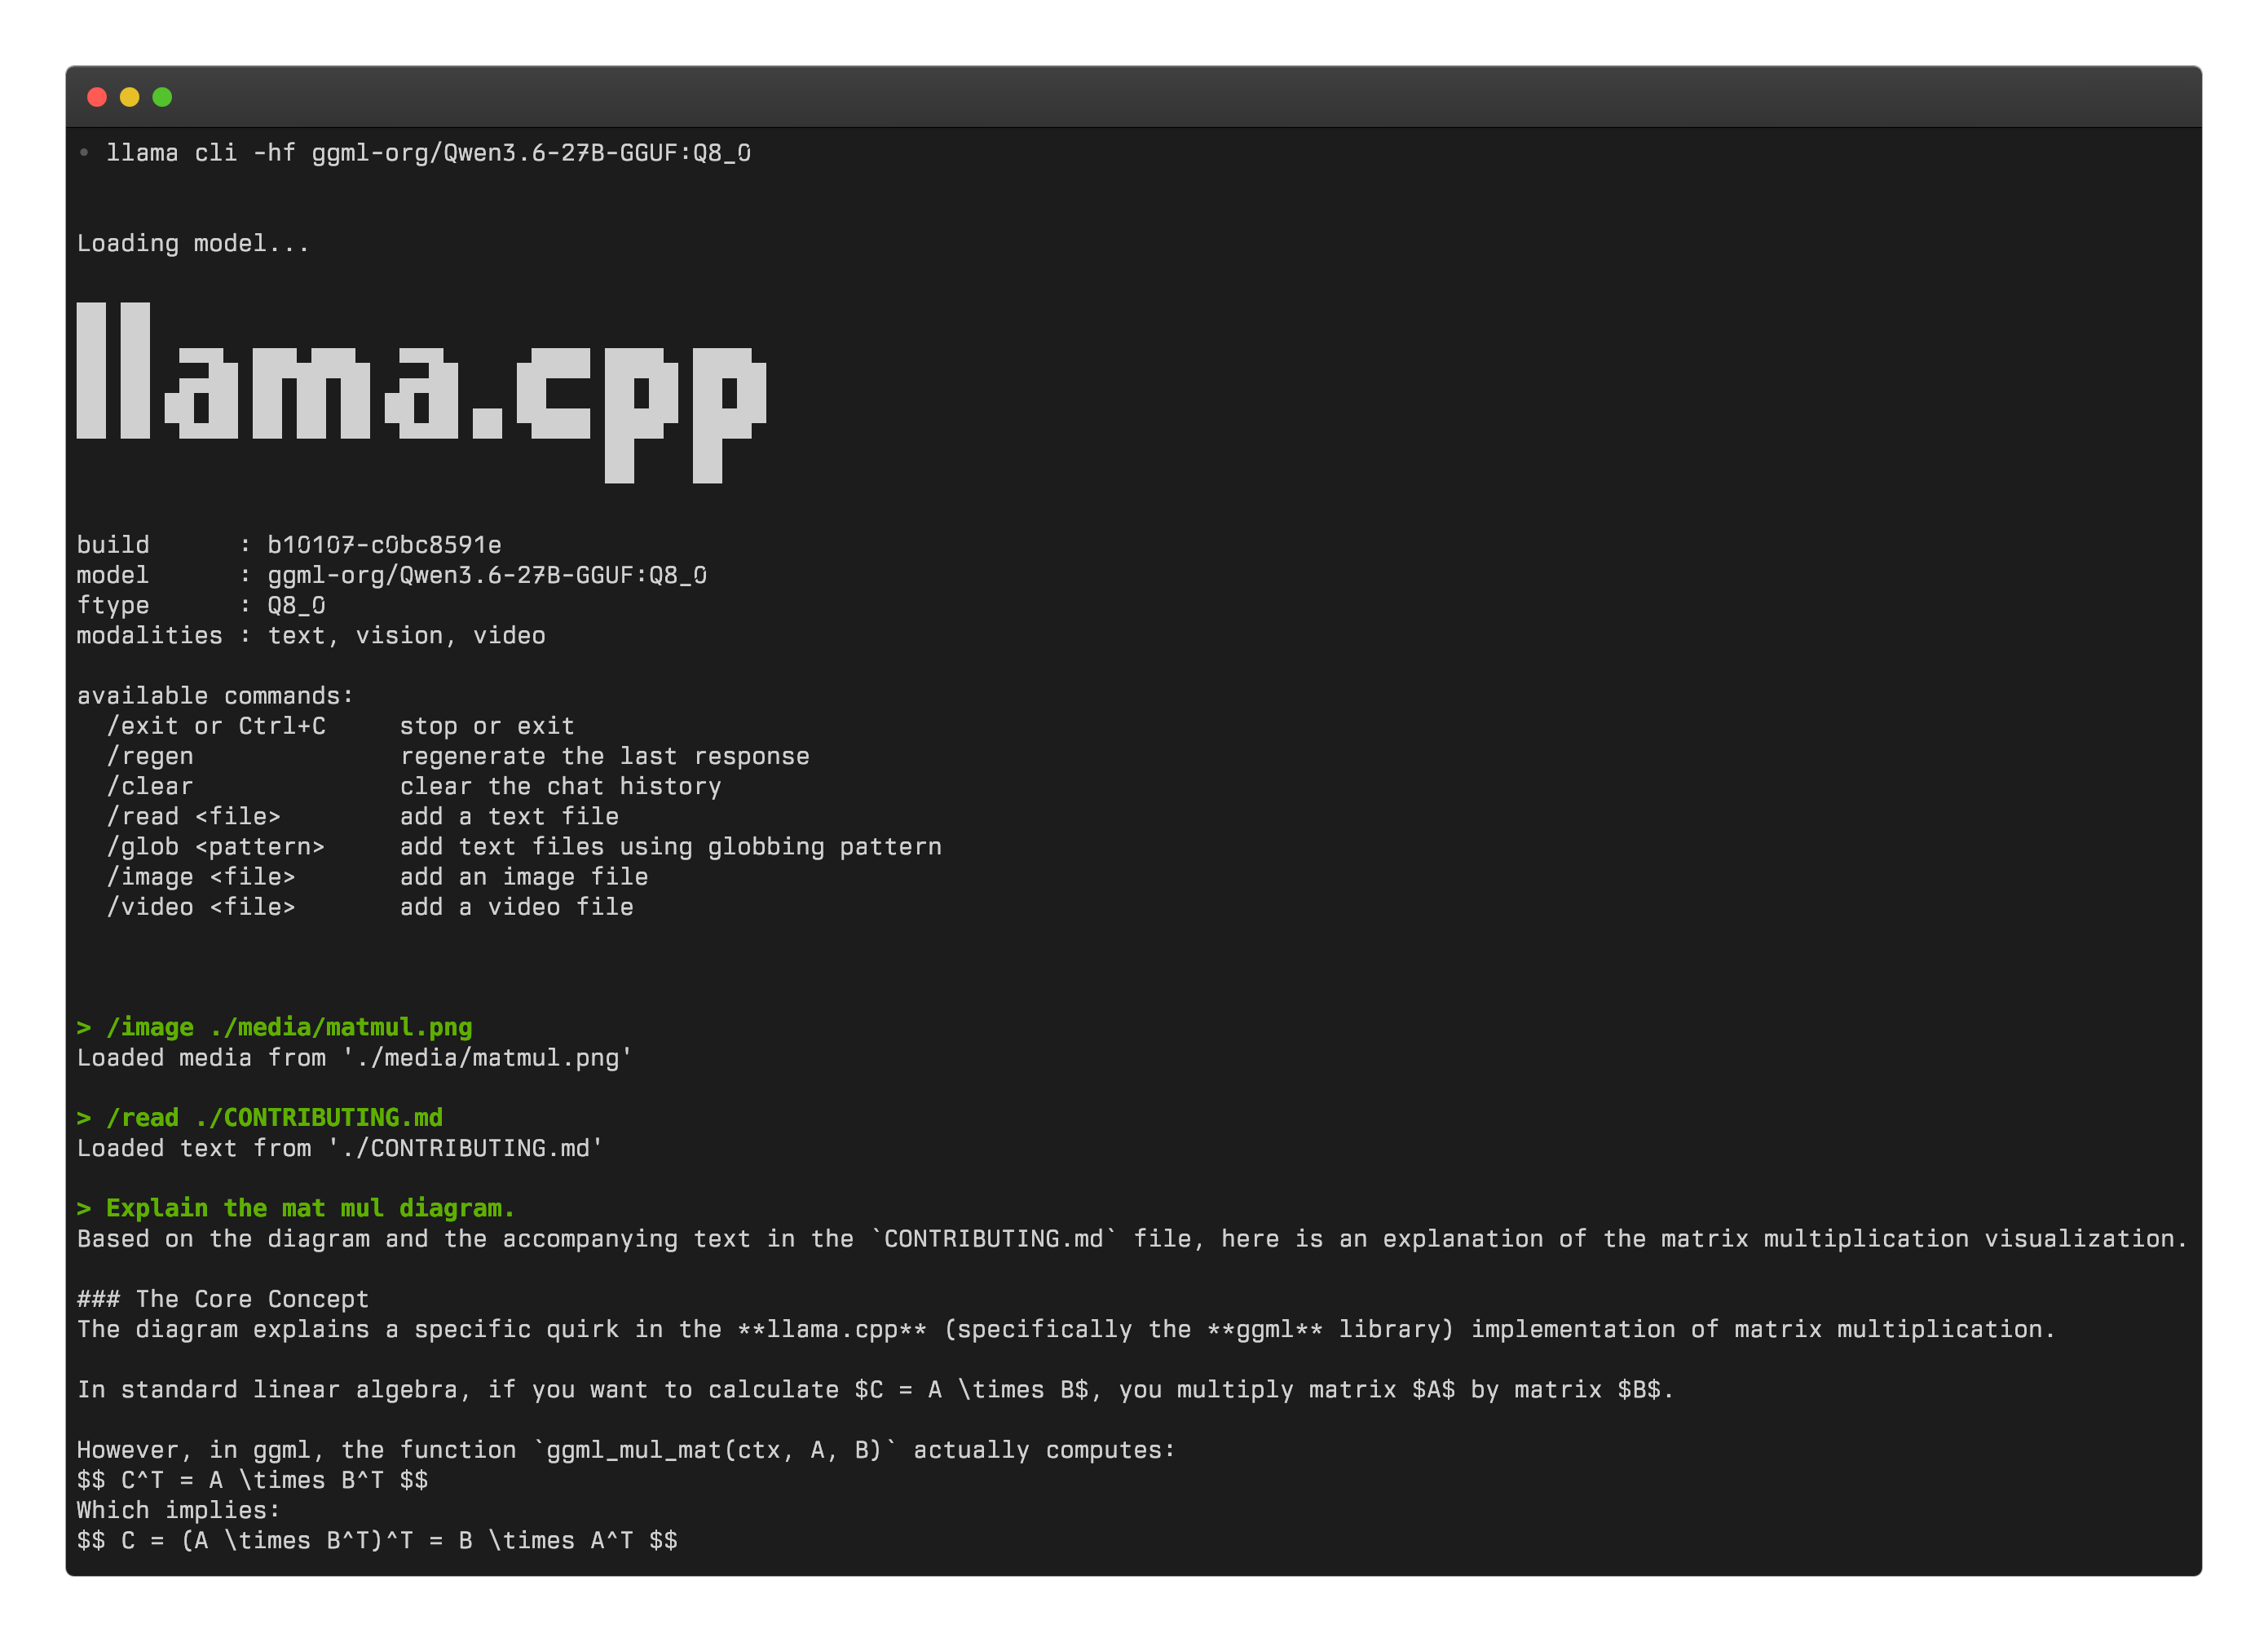
- 图片来源 URL:
https://github.com/user-attachments/assets/88726b48-1713-48aa-a525-95a02e78afc4(README 原文 alt:VLM session with 'llama cli',2026-10-25curl -L下载)。 - 本地路径:
https://zhouruolin.cn/upload/02_llamacpp_cli_screenshot.png;file校验:PNG image data, 2782 x 2014, 8-bit/color RGBA,317,242 字节(>20KB)。
图 2:llama serve 内置 Web UI(官方 README 截图)
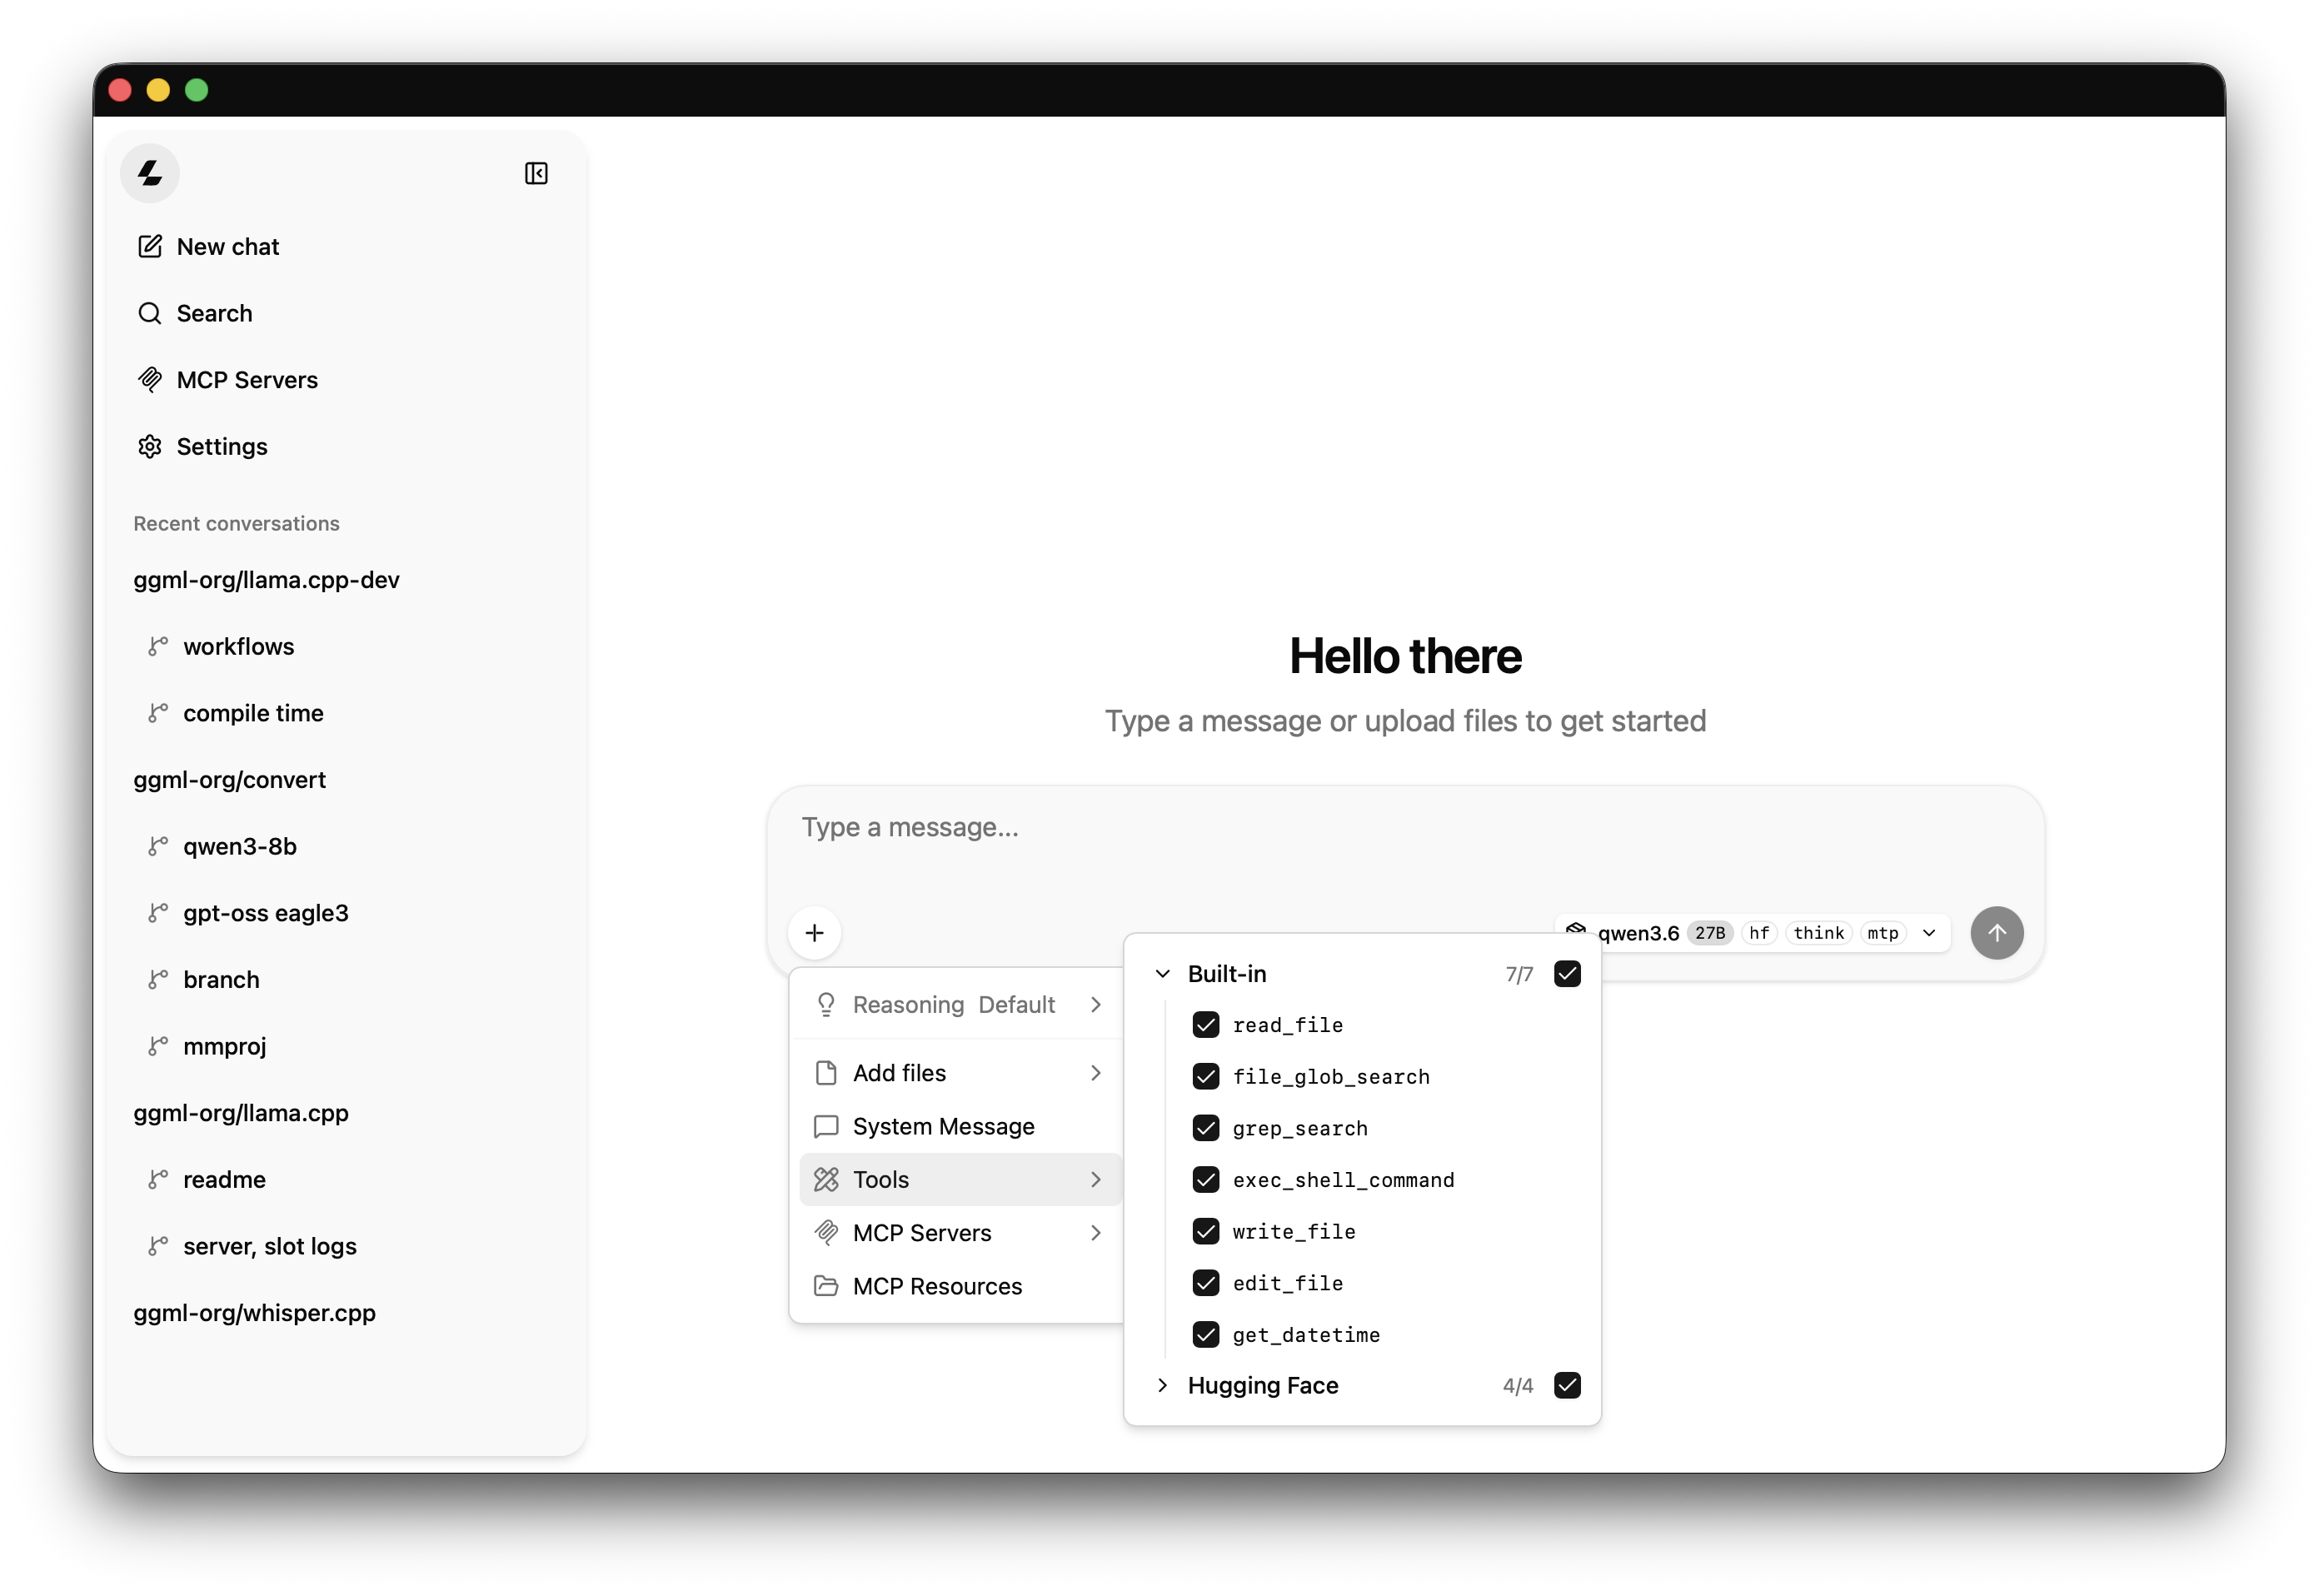
- 图片来源 URL:
https://github.com/user-attachments/assets/b402f972-2e32-4def-8771-8d849f08cf2e(README 原文 alt:Built-in web UI against 'llama serve' running Qwen 3.6,2026-10-25curl -L下载)。 - 本地路径:
https://zhouruolin.cn/upload/02_llamacpp_webui_screenshot.png;file校验:PNG image data, 2784 x 1916, 8-bit/color RGBA,688,668 字节(>20KB)。
环境要求
来源:
docs/build.md(CPU/CUDA 构建与计算能力表)、README.md(支持后端、量化档位、CPU+GPU 混合推理)、tools/quantize/README.md(量化工具内存/磁盘要求)、tools/server/README.md(默认端口与后端能力)。
| 类别 | 官方要求 / 说明 | 出处 |
|---|---|---|
| 操作系统(Windows 预编译) | Windows x64(ARM64 另有对应包);预编译包直接运行,无需自行编译。 | https://github.com/ggml-org/llama.cpp/releases(b11874 资产清单);docs/build.md Windows 构建节 |
| 操作系统(Linux / WSL2 源码编译) | 主流 Linux 发行版;WSL2(Ubuntu 24.04)内完成 CUDA 源码编译;CUDA 版本由 WSL2 内安装的 CUDA Toolkit 决定。 | docs/build.md CUDA 节;https://developer.nvidia.com/cuda-toolkit |
| GPU 与显存 | NVIDIA GPU 使用 CUDA 后端;官方构建示例列出 GeForce RTX 4090 = 计算能力 8.9、GeForce RTX 3070 = 8.6、RTX 3080 Ti = 8.6。README 明确支持 CPU+GPU 混合推理:超出总显存的模型可部分卸载到 CPU。 | docs/build.md “Override Compute Capability Specifications”;README.md Description |
| 显存 | 官方未公布固定下限;模型权重 + KV 缓存需放入显存,放不下的层自动留在 CPU(-ngl 控制卸载层数)。8GB 显存建议 7B–8B 的 Q4_K_M 级;24GB 显存可跑 14B–32B 量化模型(具体体积见 03 章 Qwen3 GGUF 表)。 |
tools/server/README.md -ngl/--gpu-layers 参数;README “CPU+GPU hybrid inference” |
| 内存 | 推理:权重 + KV 缓存占用系统内存;量化工具 llama-quantize 会把模型整体载入内存,原始精度(F32/BF16)模型必须先有足够 RAM 与磁盘存放中间文件。 |
tools/quantize/README.md “Memory/Disk Requirements” |
| 依赖(预编译 Windows CUDA 包) | 工作流将 ggml-cuda.dll 与 CUDA 运行时(cudart64_*、cublas64_*、cublasLt64_*)分别打包,在 release 合并步骤并入最终 zip;系统仍需有匹配的 NVIDIA 显卡驱动。 |
.github/workflows/release.yml windows-cuda 作业第 1193–1291 行 |
| 依赖(源码编译) | Git、CMake、C++ 编译器;CUDA 后端需安装 CUDA Toolkit(含 nvcc);可选 Ninja 并行构建;需要 HTTPS/TLS 时安装 OpenSSL 开发库(Debian/Ubuntu:sudo apt-get install libssl-dev)。 |
docs/build.md “CPU Build”“CUDA”节;README “Get the Code” git clone https://github.com/ggml-org/llama.cpp |
| 依赖(模型转换 / 量化) | Python 环境并安装仓库 requirements.txt:python3 -m pip install -r requirements.txt(或 uv pip install -r requirements.txt --index-strategy unsafe-best-match)。 |
tools/quantize/README.md “Overview” |
| 磁盘空间 | 程序本体很小;占用主要是 GGUF 模型权重。官方参考(tools/quantize/README.md,Llama-3.1-8B):原始 32.1 GB → Q4_K_M 4.9 GB;同模型参考表 Q4_K_M 4.58 GiB、Q5_K_M 5.33 GiB、Q6_K 6.14 GiB、Q8_0 7.95 GiB、F16 14.96 GiB。 |
tools/quantize/README.md “Quantization / Memory-Disk Requirements” |
RTX 3070 8GB 与 RTX 4090 24GB 编译参数对照(来源:docs/build.md “Override Compute Capability Specifications”,官方示例即列出 RTX 3070=8.6、RTX 4090=8.9):
| 机器 | CUDA 架构(Compute Capability) | 推荐 CMAKE_CUDA_ARCHITECTURES |
|---|---|---|
| RTX 3070 8GB | 86 |
86 |
| RTX 4090 24GB | 89 |
89 |
| 两机通用 / 交叉编译 | 同时覆盖 | "86;89" |
最详细部署步骤(Windows 预编译 与 WSL2 源码编译 两种视角)
依赖安装
A. Windows 10/11 原生(预编译 CUDA 包路线)
- 安装 NVIDIA 显卡最新驱动,设备管理器 /
nvidia-smi确认显卡被识别。 - 无需安装 Visual Studio、CMake 或 CUDA Toolkit(预编译包自带后端运行时)。
- 准备模型目录,例如
D:\llm\models\,用于存放 GGUF 文件。
B. WSL2(Ubuntu 24.04)源码编译路线
- Windows 侧安装 NVIDIA 驱动;进入 WSL2 执行
nvidia-smi,确认能看到显卡与CUDA Version(WSL2 直通由 Windows 驱动提供,不要在 Windows 上装 CUDA Toolkit 来给 WSL2 编译用,编译工具链要装在 WSL2 内)。 - 在 WSL2 内安装 CUDA Toolkit(含
nvcc,官方下载入口https://developer.nvidia.com/cuda-toolkit),安装后nvcc --version可执行。 - 安装编译基础工具(Git、CMake、C++ 工具链、Ninja;Debian/Ubuntu 常用命令):
sudo apt-get update
sudo apt-get install -y git cmake g++ build-essential ninja-build libssl-dev
说明:上面的
apt-get包名是 Ubuntu 通用开发工具链;llama.cpp 官方docs/build.md只规定了git clone+ CMake 构建流程与 CUDA Toolkit 前提,未直接给出该apt-get清单。
项目下载 / 安装(预编译包、一键脚本、源码三种官方方式)
方式一:Windows 官方预编译包(Nightly b11874,2026-10-25 资产清单核验)
- 发布页:
https://github.com/ggml-org/llama.cpp/releases - NVIDIA CUDA 12.4 x64 包直链(HTTP 200 已核验):
https://github.com/ggml-org/llama.cpp/releases/download/b11874/llama-b11874-bin-win-cuda-12.4-x64.zip - 同清单备选:CPU 包
llama-b11874-bin-win-cpu-x64.zip、CUDA 13.4 包llama-b11874-bin-win-cuda-13.4-x64.zip、Vulkan 包llama-b11874-bin-win-vulkan-x64.zip。
下载解压后,在解压目录内查找以下官方 CMake 目标对应的可执行文件(来源:各 tools/*/CMakeLists.txt):
| 工具 | Windows 可执行文件 | 官方 CMake 目标 / 文档 |
|---|---|---|
| HTTP 服务器 | llama-server.exe |
tools/server/CMakeLists.txt:set(TARGET llama-server); add_executable(${TARGET} main.cpp);tools/server/README.md Build 节 |
| 命令行对话 | llama-cli.exe |
tools/cli/CMakeLists.txt:set(TARGET llama-cli); add_executable(${TARGET} main.cpp);tools/cli/README.md |
| 模型量化 | llama-quantize.exe |
tools/quantize/CMakeLists.txt:set(TARGET llama-quantize); add_executable(${TARGET} main.cpp);tools/quantize/README.md |
方式二:官方一键脚本(README Quick start,https://llama.app)
# Linux / macOS(README 原文:curl -LsSf https://llama.app/install.sh | sh)
curl -LsSf https://llama.app/install.sh | sh
# Windows PowerShell(README 原文:irm https://llama.app/install.ps1 | iex)
irm https://llama.app/install.ps1 | iex
脚本安装的是统一命令 llama,子命令为 llama cli 与 llama serve(README 示例:llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF、llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF)。
方式三:WSL2 / Linux 源码编译(官方 docs/build.md)
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp

# CPU 构建(官方 CPU Build 命令)
cmake -B build
cmake --build build --config Release

# CUDA 构建(官方 CUDA 节命令)
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release
RTX 3070 / 4090 指定架构(官方 “Override Compute Capability Specifications”):
# 单卡 RTX 3070(86)
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="86"
cmake --build build --config Release -j"$(nproc)"

# 单卡 RTX 4090(89)
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="89"
cmake --build build --config Release -j"$(nproc)"

# 两机通用(86 + 89)
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES="86;89"
cmake --build build --config Release -j"$(nproc)"
只构建服务器目标(官方 tools/server/README.md Build 节):
cmake -B build
cmake --build build --config Release -t llama-server
# 产物:./build/bin/llama-server
可选:为覆盖所有 CUDA GPU(非原生机器)禁用原生优化:
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=OFF(docs/build.md“Non-Native Builds”)。需要 OpenSSL/SSL 支持时:cmake -B build -DLLAMA_OPENSSL=ON(tools/server/README.md“Build with SSL”)。
产物位置(官方文档):./build/bin/llama-server、./build/bin/llama-cli、./build/bin/llama-quantize。
模型 / 权重下载(官方链接 + 国内加速方案)
A. 官方 -hf 直连 Hugging Face(docs/models.md、tools/server/README.md -hf 参数)
# 官方 README Quick start 示例仓库;量化档大小写不敏感,默认 Q4_K_M
./build/bin/llama-cli -hf ggml-org/Qwen3.5-0.8B-GGUF
./build/bin/llama-server -hf ggml-org/Qwen3.5-0.8B-GGUF
B. 官方 MODEL_ENDPOINT 兼容端点(docs/models.md 原文:You can use the same CLI invocation to download from other sites, by pointing the MODEL_ENDPOINT environment variable to an endpoint compatible with the Hugging Face API.)
# 指向兼容 Hugging Face API 的镜像端点(端点需自行确认兼容性)
export MODEL_ENDPOINT=https://hf-mirror.com
./build/bin/llama-server -hf Qwen/Qwen3-8B-GGUF:Q4_K_M
说明:
hf-mirror.com为第三方国内镜像站(非 llama.cpp / Hugging Face 官方),MODEL_ENDPOINT仅要求端点兼容 HF API;若镜像路径不兼容,改用下面的“手动下载 + 本地路径”方案最稳妥。
C. 手动下载 GGUF + 本地路径加载(离线 / 慢网络最稳妥方案)
- 在可访问渠道(浏览器、
huggingface-cli或 ModelScope 镜像,见 03 章)下载目标.gguf,例如Qwen3-8B-Q4_K_M.gguf。 - 用
-m/--model指定本地文件(tools/server/README.md参数表):
# Linux / WSL2
./build/bin/llama-server -m /home/user/models/Qwen3-8B-Q4_K_M.gguf --host 0.0.0.0 --port 8080

# Windows 预编译包
llama-server.exe -m models\Qwen3-8B-Q4_K_M.gguf -c 4096
- 走代理时,启动前导出
HTTPS_PROXY/HTTP_PROXY(tools/server/README.md“Running behind a proxy”:export HTTPS_PROXY=http://proxy.example.com:8080,NO_PROXY与回环地址直连)。
D. 本地转 GGUF 与重新量化(官方 tools/quantize/README.md)
# 1) 安装 Python 依赖
python3 -m pip install -r requirements.txt

# 2) HF 模型转 BF16 GGUF(官方示例命令格式)
python convert_hf_to_gguf.py --outfile model-bf16.gguf --outtype bf16 --remote org/model

# 3) 量化为 Q4_K_M(官方新格式命令)
./build/bin/llama-quantize model-bf16.gguf model-Q4_K_M.gguf Q4_K_M

# 旧格式(官方 Quantization Examples 兼容写法,最后一位为线程数)
./llama-quantize input-model-f32.gguf q4_k_m 8
关键配置(参数 / 环境变量表)
下列参数全部来自 tools/server/README.md 与 tools/cli/README.md 自动生成的参数表;带 (env: ...) 的参数也可用同名 LLAMA_ARG_* 环境变量设置。命令行参数优先于环境变量(tools/server/README.md 注释:命令行与环境变量同时设置时,参数优先)。
| 参数 | 含义 | 默认值 / 取值 | 出处 |
|---|---|---|---|
-m, --model FNAME |
本地模型文件路径 | 无 | server/cli README Common params |
-mu, --model-url MODEL_URL |
模型下载 URL | 未使用 | 同上 |
-hf, -hfr, --hf-repo <user>/<model>[:quant] |
Hugging Face 仓库与可选量化档;量化档大小写不敏感,默认 Q4_K_M,找不到则回退仓库第一个文件;可用 --no-mmproj 关闭多模态投影自动下载 |
未使用;默认量化 Q4_K_M |
server/cli README Common params |
-hff, --hf-file FILE |
指定 HF 文件名,覆盖 -hf 中的量化档 |
未使用 | 同上 |
-hft, --hf-token TOKEN |
HF 访问令牌;默认取 HF_TOKEN 环境变量 |
HF_TOKEN |
同上 |
-ngl, --gpu-layers, --n-gpu-layers N |
卸载到显存的最大层数;可取具体层数、auto、all |
auto |
server/cli README Common params |
-sm, --split-mode {none,layer,row,tensor} |
多 GPU 切分方式:none 单卡;layer(默认,分层+KV 流水线);row(按行切权重并行);tensor(权重+KV 并行,实验性) |
layer |
同上 |
-dev, --device <dev1,dev2,..> |
指定卸载设备;none 表示不卸载;--list-devices 列出可用设备 |
README 未声明默认值 | server/cli README Common params |
-mg, --main-gpu INDEX |
主 GPU 编号(split-mode=none 时用哪张卡;row 时用于中间结果与 KV) |
0 |
同上 |
-c, --ctx-size N |
提示上下文长度;0 表示从模型元数据读取 |
0(模型默认) |
server/cli README Common params |
-n, --predict, --n-predict N |
最大生成 token 数;-1 无限 |
-1 |
同上 |
-b, --batch-size N |
逻辑最大批大小 | 2048 |
同上 |
-ub, --ubatch-size N |
物理最大批大小 | 512 |
同上 |
-t, --threads N |
生成阶段 CPU 线程数 | -1(自动) |
同上 |
-tb, --threads-batch N |
提示处理阶段线程数 | 同 --threads |
同上 |
-fa, --flash-attn [on\|off\|auto] |
Flash Attention 开关 | auto |
同上 |
-ctk, --cache-type-k TYPE |
K 缓存类型:f32, f16, bf16, q8_0, q4_0, q4_1, iq4_nl, q5_0, q5_1 |
f16 |
同上 |
-ctv, --cache-type-v TYPE |
V 缓存类型,取值同上 | f16 |
同上 |
-p, --prompt PROMPT |
起始提示词;系统提示词用 -sys |
无 | cli README Common params |
-f, --file FNAME |
含提示词的文件 | 无 | 同上 |
-sys, --system-prompt PROMPT |
系统提示词(取决于聊天模板是否支持) | 无 | cli README CLI-specific params |
--jinja, --no-jinja |
是否使用 Jinja 聊天模板引擎 | 默认启用 | server README Server-specific params;cli README CLI-specific params |
--chat-template JINJA_TEMPLATE / --chat-template-file FILE |
自定义 Jinja 聊天模板;默认取模型元数据模板 | 模型模板 | 同上 |
--host HOST |
监听地址(逗号分隔多地址,或 .sock Unix 套接字) |
127.0.0.1 |
server README Server-specific params |
--port PORT |
监听端口 | 9931 |
同上 |
-a, --alias STRING |
模型别名(逗号分隔),供 API 使用;GET /v1/models 的 id 默认为模型文件路径 |
文件路径 | 同上 |
-np, --parallel N |
服务器并行槽位数;-1 自动 |
-1 |
同上 |
-cb, --cont-batching, -nocb, --no-cont-batching |
连续批处理(动态批处理) | 默认启用 | 同上 |
--cors-origins ORIGINS |
允许跨域来源;特殊值 localhost 仅放行本地来源 |
*(默认) |
同上 |
--ui, --webui, --no-ui |
是否启用内置 Web UI | 默认启用 | 同上 |
--metrics |
启用 Prometheus 兼容指标端点 | 关闭 | 同上 |
--api-key KEY |
API 访问密钥,可逗号分隔多个;环境变量 LLAMA_API_KEY |
无 | 同上 |
--reasoning-format FORMAT |
思考标签解析:none(保留在 message.content)、deepseek(放入 message.reasoning_content)、deepseek-legacy(两者兼有) |
auto |
同上 |
-rea, --reasoning [on\|off\|auto] |
聊天中是否使用推理 / 思考 | auto(按模板检测) |
同上 |
--temp, --temperature N |
温度 | 0.80 |
server/cli README Sampling params |
--top-k N |
Top-K 采样,0 关闭 |
40 |
同上 |
--top-p N |
Top-P 采样,1.0 关闭 |
0.95 |
同上 |
--min-p N |
Min-P 采样,0.0 关闭 |
0.05 |
同上 |
--presence-penalty N |
重复存在惩罚 | 0.00 |
同上 |
--repeat-penalty N |
重复序列惩罚 | 1.00 |
同上 |
--keep N |
首轮提示词保留 token 数;-1 全部保留 |
0 |
同上 |
--context-shift / --no-context-shift |
无限生成时是否滚动移位上下文(淘汰旧 token);--context-shift 开启滚动,--no-context-shift 关闭 |
默认 disabled(不移位,到达 -c 后停止生成) |
server/cli README 参数表 |
启动
Windows 预编译包(在解压目录下,PowerShell):
# 启动服务器,本地模型,监听 127.0.0.1:9931(默认)
.\llama-server.exe -m models\Qwen3-8B-Q4_K_M.gguf -c 4096

# 指定对外地址与端口、全层卸载到 GPU
.\llama-server.exe -m models\Qwen3-8B-Q4_K_M.gguf --host 0.0.0.0 --port 8080 -ngl 99 -c 4096
WSL2 / Linux 源码编译产物:
# 查看可用设备(官方 --list-devices)
./build/bin/llama-server --list-devices

# CUDA 服务器启动示例(官方 Docker 示例同参数族)
./build/bin/llama-server -m models/Qwen3-8B-Q4_K_M.gguf \
  --host 0.0.0.0 --port 8080 \
  --n-gpu-layers 99 -c 4096 -fa

# 命令行对话(官方 cli README 模式)
./build/bin/llama-cli -m models/Qwen3-8B-Q4_K_M.gguf --jinja --color -ngl 99 -c 4096
官方 Docker 路线(docs/docker.md、tools/server/README.md Docker 示例):
# CPU 镜像:仅含 llama-server
docker run -p 8080:8080 -v /path/to/models:/models ghcr.io/ggml-org/llama.cpp:server \
  -m models/7B/ggml-model.gguf -c 512 --host 0.0.0.0 --port 8080

# CUDA 镜像(CUDA 12 编译),需 --gpus all
docker run -p 8080:8080 -v /path/to/models:/models --gpus all \
  ghcr.io/ggml-org/llama.cpp:server-cuda \
  -m models/7B/ggml-model.gguf -c 512 --host 0.0.0.0 --port 8080 --n-gpu-layers 99
镜像清单(docs/docker.md):full(cli + completion + 转换/量化工具)、light(cli + completion)、server(仅 llama-server);后缀 -cuda(CUDA 12)、-cuda13、-rocm、-vulkan、-musa、-intel;基础镜像平台为 linux/amd64、linux/arm64,full/light/server 另提供 linux/s390x,部分后端镜像仅 linux/amd64,以 docs/docker.md 清单为准。
使用方法
启动方式
| 方式 | 命令 / 入口 | 说明 |
|---|---|---|
| 命令行交互 | ./build/bin/llama-cli -m <模型>(Windows:llama-cli.exe) |
--jinja 默认启用;聊天模板默认取自模型元数据(tools/cli/README.md 参数表)。 |
| HTTP 服务器 | ./build/bin/llama-server -m <模型>(Windows:llama-server.exe) |
默认 127.0.0.1:9931;内置 Web UI 默认开启,浏览器访问同一地址。 |
| 统一命令 | llama cli ... / llama serve ... |
官方一键脚本安装后的子命令形式(README Quick start)。 |
| Docker | ghcr.io/ggml-org/llama.cpp:server[-cuda] |
官方 docs/docker.md 镜像。 |
界面 / 命令行操作步骤(带示例)
A. llama-cli 命令行对话(tools/cli/README.md;参数表见 02.4.4)
# 本地模型 + Jinja 模板 + 着色 + 全层 GPU 卸载 + Flash Attention + 8K 上下文
./build/bin/llama-cli \
  -m models/Qwen3-8B-Q4_K_M.gguf \
  --jinja --color \
  -ngl 99 -fa \
  -sm row \
  -c 8192 \
  --system-prompt "You are a concise assistant."
交互常用开关:
| 命令 / 参数 | 作用 | 出处 |
|---|---|---|
-co, --color [on\|off\|auto] |
着色区分提示词与生成内容;默认 auto(输出到终端时启用) |
cli README CLI-specific params |
-st, --single-turn |
单轮对话后退出;首轮已带 --prompt 时不进入交互 |
同上 |
-mli, --multiline-input |
允许多行粘贴 / 输入 | 同上 |
-sysf, --system-prompt-file FNAME |
从文件读取系统提示词 | 同上 |
-o, --output, --output-file FNAME |
输出到文件 | 同上 |
--show-timings, --no-show-timings |
每轮响应后显示耗时统计 | 默认启用 |
--simple-io |
基础 IO,兼容子进程与受限终端 | 同上 |
--server-base URL |
连接已有服务器而不是新启动(示例 http://localhost:9931) |
同上 |
B. llama-server 内置 Web UI 与 HTTP 接口(tools/server/README.md)
- 启动服务器(见 02.4.5)。
- 浏览器打开
http://127.0.0.1:9931/(自定义--port后用对应端口),使用内置 Web UI 对话。 - 其他前端(如 Open WebUI)通过 OpenAI 兼容接口接入:Base URL 填
http://<服务器IP>:<端口>/v1,API Key 任意填写(未启用--api-key时不校验)。 - 对接依据:llama.cpp 服务器提供 OpenAI 兼容chat/completions等路由(tools/server/README.mdFeatures 与 “OpenAI-compatible API Endpoints”);Open WebUI README 明确支持接入任意 OpenAI 兼容 API:https://github.com/open-webui/open-webui。
服务端 API 端点表(tools/server/README.md “API Endpoints”)
| 端点 | 协议兼容性 | 说明 |
|---|---|---|
GET /health(/v1/health 同样可用) |
健康检查 | 模型加载中返回 503 {"error": {"code":503,...}};就绪返回 200 {"status":"ok"} |
POST /completion |
非 OpenAI 兼容 | 给定 prompt 返回续写;OpenAI 客户端请用 /v1/completions |
POST /embedding |
非 OpenAI 兼容 | 文本向量;OpenAI 客户端请用 /v1/embeddings |
GET /v1/models |
OpenAI 兼容 | 已加载模型信息;id 默认 -m 文件路径,可用 --alias 修改 |
POST /v1/completions |
OpenAI 兼容 | 补全接口,支持流式 |
POST /v1/chat/completions |
OpenAI 兼容 | 聊天接口,支持同步 / 流式;支持 response_format(JSON 对象 / JSON Schema)、chat_template_kwargs(如 {"enable_thinking":false})、reasoning_effort、reasoning_format、工具调用 |
POST /v1/responses |
OpenAI 兼容 | Responses API |
POST /v1/embeddings |
OpenAI 兼容 | 文本 / 多模态向量 |
POST /v1/rerank、/v1/reranking |
重排序 | 需 --rerank 启用 |
--metrics 开启 |
Prometheus | 指标监控端点 |
端到端示例(输入 → 命令 → 输出)
场景:RTX 3070 8GB,WSL2 源码编译 CUDA 版,本地 GGUF Qwen3-8B-Q4_K_M.gguf(体积见 03 章),启动 OpenAI 兼容服务器并完成一次对话。
第 1 步:启动服务器
cd ~/llama.cpp
./build/bin/llama-server \
  -m ~/models/Qwen3-8B-Q4_K_M.gguf \
  --host 0.0.0.0 --port 8080 \
  -ngl 99 -c 8192 -fa \
  --jinja --alias qwen3-8b
启动日志关键行(结构示意,tools/server/README.md 默认参数):监听 http://0.0.0.0:8080,模型全层卸载,上下文 8192,Web UI 开启。
第 2 步:健康检查
curl http://localhost:8080/health
# 就绪返回:{"status": "ok"}
第 3 步:OpenAI 兼容聊天请求(tools/server/README.md 官方 curl 示例格式)
curl http://localhost:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer no-key" \
  -d '{
    "model": "qwen3-8b",
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "用三句话介绍你自己。"}
    ]
  }'
返回(OpenAI 兼容结构,字段说明见 /v1/chat/completions 文档;content 为模型回答):
{
  "object": "chat.completion",
  "model": "qwen3-8b",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "我是基于 Qwen3 系列的本地大模型,运行在 llama.cpp 推理引擎上。\n我的回答由本地显卡完成计算,不上传对话内容到云端。\n你可以直接在命令行或浏览器里向我提问。"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 66, "total_tokens": 90}
}
Python openai SDK 接入(官方 /v1/chat/completions 文档示例,Base URL 替换为本机地址):
import openai

client = openai.OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="sk-no-key-required"
)

completion = client.chat.completions.create(
    model="qwen3-8b",
    messages=[{"role": "user", "content": "用三句话介绍你自己。"}]
)
print(completion.choices[0].message.content)
常见坑(现象 + 原因 + 解决)
-
现象:CUDA 编译时报
nvcc warning : Cannot find valid GPU for '-arch=native', default arch is used,或编译产物只能用 CPU。 - 原因:docs/build.md“Override Compute Capability Specifications” 指出,nvcc无法探测到本机 GPU 时会回退默认架构;非原生机器 / 多卡混合场景需要显式指定架构。 - 解决:按官方方式指定-DCMAKE_CUDA_ARCHITECTURES="86;89"(RTX 3070=86、RTX 4090=89);或-DGGML_NATIVE=OFF做覆盖全架构的非原生构建。 -
现象:
llama-server/llama-cli启动后全程跑在 CPU,生成很慢。 - 原因:使用了 CPU 版压缩包;或-ngl未设置 / 被-dev none限制;CUDA 后端未编译进二进制;WSL2 内nvidia-smi不可用。 - 解决:核对下载的是bin-win-cuda-12.4-x64.zip(或源码-DGGML_CUDA=ON编译);先执行--list-devices查看设备;启动时加-ngl 99(全部层卸载);WSL2 先确认nvidia-smi正常。 -
现象:对话输出乱码、角色标记错乱、系统提示词不生效。 - 原因:模型自带聊天模板未被正确使用;
/v1/chat/completions要求模型具备受支持的聊天模板(tools/server/README.md提示:不支持的模型将默认使用 ChatML 模板)。 - 解决:保持--jinja默认启用;必要时用--chat-template/--chat-template-file指定模板;模板支持清单参考官方 Wiki:https://github.com/ggml-org/llama.cpp/wiki/Templates-supported-by-llama_chat_apply_template(tools/server/README.md内链)。 -
现象:端口
9931(或自定义端口)被占用,服务器启动失败。 - 原因:本机已有其他进程占用端口;或上一个llama-server实例未退出。 - 解决:--port指定其他端口(如8080);排查占用进程;检查--host绑定地址是否与其他服务冲突。 -
现象:
-hf拉取模型超时、中断或报网络错误。 - 原因:Hugging Face 在国内网络访问不稳定;代理未配置。 - 解决:优先“手动下载 GGUF +-m本地路径”(02.4.3 方案 C);或用MODEL_ENDPOINT指向兼容 HF API 的镜像;tools/server/README.md“Running behind a proxy” 要求下载模型前先导出HTTP_PROXY与HTTPS_PROXY(NO_PROXY与回环地址直连)。 -
现象:
llama-quantize阶段内存不足、进程被杀,或磁盘写满。 - 原因:官方 “Memory/Disk Requirements” 说明:模型当前整体载入内存,内存与磁盘需求相同;原始 F32/BF16 体积很大(官方参考 Llama-3.1-8B 原始 32.1GB)。 - 解决:留出与原始模型相当的 RAM 与磁盘;优先从已有 16bit 模型量化;不要反复对已量化文件再量化(--allow-requantize会明显损失质量,tools/quantize/README.md已警告);需要更优质量时配合--imatrix重要性矩阵。
本节来源清单
验证方式:
curl 200= 命令行 HTTP 状态码核验;web_fetch / 源码核对= 已下载官方原始文件逐条核对;general_search= 搜索索引佐证。核验日期 2026-10-25。
| # | URL | 用途 | 验证方式 |
|---|---|---|---|
| 1 | https://github.com/ggml-org/llama.cpp | 官方仓库主页、README(定位、后端、截图、一键脚本、Docker 说明) | curl 200;README 经 https://raw.githubusercontent.com/ggml-org/llama.cpp/master/README.md 下载核对 |
| 2 | https://github.com/ggml-org/llama.cpp/blob/master/LICENSE | MIT 许可证出处 | curl 200;raw 文件 https://raw.githubusercontent.com/ggml-org/llama.cpp/master/LICENSE web_fetch 核对为 MIT License |
| 3 | https://raw.githubusercontent.com/ggml-org/llama.cpp/master/LICENSE | LICENSE 原始文件 | web_fetch 实际读取 |
| 4 | https://github.com/ggml-org/llama.cpp/blob/master/docs/build.md | CPU/CUDA 构建命令、CMAKE_CUDA_ARCHITECTURES、RTX 3070=8.6 / RTX 4090=8.9、GGML_NATIVE、OpenSSL |
curl 200,已下载 docs/build.md 逐条核对 |
| 5 | https://github.com/ggml-org/llama.cpp/blob/master/docs/models.md | -hf 用法、MODEL_ENDPOINT、GGUF 格式、HF GGUF 目录 |
curl 200,已下载核对 |
| 6 | https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md | 服务器功能、端点、默认 127.0.0.1:9931、参数表、构建产物路径、Docker 示例、代理说明、OpenAI 兼容端点 |
curl 200,已下载核对(参数表逐条引用) |
| 7 | https://github.com/ggml-org/llama.cpp/blob/master/tools/cli/README.md | 命令行工具参数、--jinja、--color、系统提示词、单轮 / 多行等 |
curl 200,已下载核对 |
| 8 | https://github.com/ggml-org/llama.cpp/blob/master/tools/quantize/README.md | 量化工具用法、命令格式、选项、内存/磁盘要求、量化档体积参考表 | curl 200,已下载核对 |
| 9 | https://github.com/ggml-org/llama.cpp/blob/master/docs/docker.md | Docker 镜像名 :full/:light/:server 及 -cuda/-rocm/-vulkan 后缀、平台 |
curl 200,已下载核对 |
| 10 | https://github.com/ggml-org/llama.cpp/releases | 官方发布页(Release v* / Nightly b* 分类) |
curl 200 |
| 11 | https://github.com/ggml-org/llama.cpp/releases/tag/v0.7.0 | 最新稳定 release 版本号与日期(2026-10-15) | curl 200,页面 datetime 核对 |
| 12 | https://github.com/ggml-org/llama.cpp/releases/tag/b11874 | 最新 Nightly 标签(2026-10-25)与资产清单 | curl 200,expanded_assets/b11874 HTML 解析核对 |
| 13 | https://github.com/ggml-org/llama.cpp/releases/download/b11874/llama-b11874-bin-win-cuda-12.4-x64.zip | Windows CUDA 12.4 预编译包直链 | curl 200(HEAD 跟随重定向) |
| 14 | https://github.com/ggml-org/llama.cpp/releases/download/b11874/llama-b11874-bin-win-cpu-x64.zip | Windows CPU 预编译包备选 | 资产清单 HTML 核对(同 b11874 页面) |
| 15 | https://github.com/ggml-org/llama.cpp/releases/download/b11874/llama-b11874-bin-ubuntu-cuda-12.8-x64.tar.gz | Ubuntu CUDA 预编译包备选 | 资产清单 HTML 核对 |
| 16 | https://github.com/ggml-org/llama.cpp/blob/master/.github/workflows/release.yml | 预编译包打包内容、CMake 目标与后端 DLL 组装方式 | curl 200,已下载 1768 行工作流核对 |
| 17 | https://github.com/ggml-org/llama.cpp/blob/master/tools/server/CMakeLists.txt | llama-server 可执行目标名 |
curl 200,源码 add_executable(llama-server main.cpp) 核对 |
| 18 | https://github.com/ggml-org/llama.cpp/blob/master/tools/cli/CMakeLists.txt | llama-cli 可执行目标名 |
curl 200,源码 add_executable(llama-cli main.cpp) 核对 |
| 19 | https://github.com/ggml-org/llama.cpp/blob/master/tools/quantize/CMakeLists.txt | llama-quantize 可执行目标名 |
curl 200,源码 add_executable(llama-quantize main.cpp) 核对 |
| 20 | https://llama.app | 官方安装引导站 | curl 200 |
| 21 | https://llama.app/install.sh | Linux 一键安装脚本 | curl 200,已下载 215 行源码核对(自动探测 CUDA/ROCm/Vulkan/CPU/Metal) |
| 22 | https://llama.app/install.ps1 | Windows PowerShell 一键安装脚本 | curl 200(README Quick start 引用) |
| 23 | https://huggingface.co/models?library=gguf&sort=trending | HF 上 GGUF 模型目录(docs/models.md 官方链接) |
curl 200 |
| 24 | https://developer.nvidia.com/cuda-toolkit | CUDA Toolkit 官方下载入口 | curl 200 |
| 25 | https://developer.nvidia.com/cuda-gpus | 各型号 GPU 计算能力官方对照表(docs/build.md 引用) |
curl 200 |
| 26 | https://github.com/open-webui/open-webui | 第三方前端“支持任意 OpenAI 兼容 API”能力依据 | curl 200,README 第 13、28 行核对 |
| 27 | https://github.com/ggml-org/llama.cpp/wiki/Templates-supported-by-llama_chat_apply_template | 受支持聊天模板清单(server README 内链) | curl 200(2026-10-25 重定向跟随核验) |
| 28 | https://opensource.org/licenses/MIT | README 徽章指向的 MIT 许可证文本 | README 徽章链接 |
| 29 | https://hf-mirror.com | 第三方 Hugging Face 镜像(非官方,仅作 -hf 备选说明) |
curl 200;站点性质已在正文标注为第三方 |
| 30 | https://huggingface.co/ggml-org/Qwen3.5-0.8B-GGUF | README Quick start -hf 示例仓库 |
curl 200(2026-10-25 核验) |