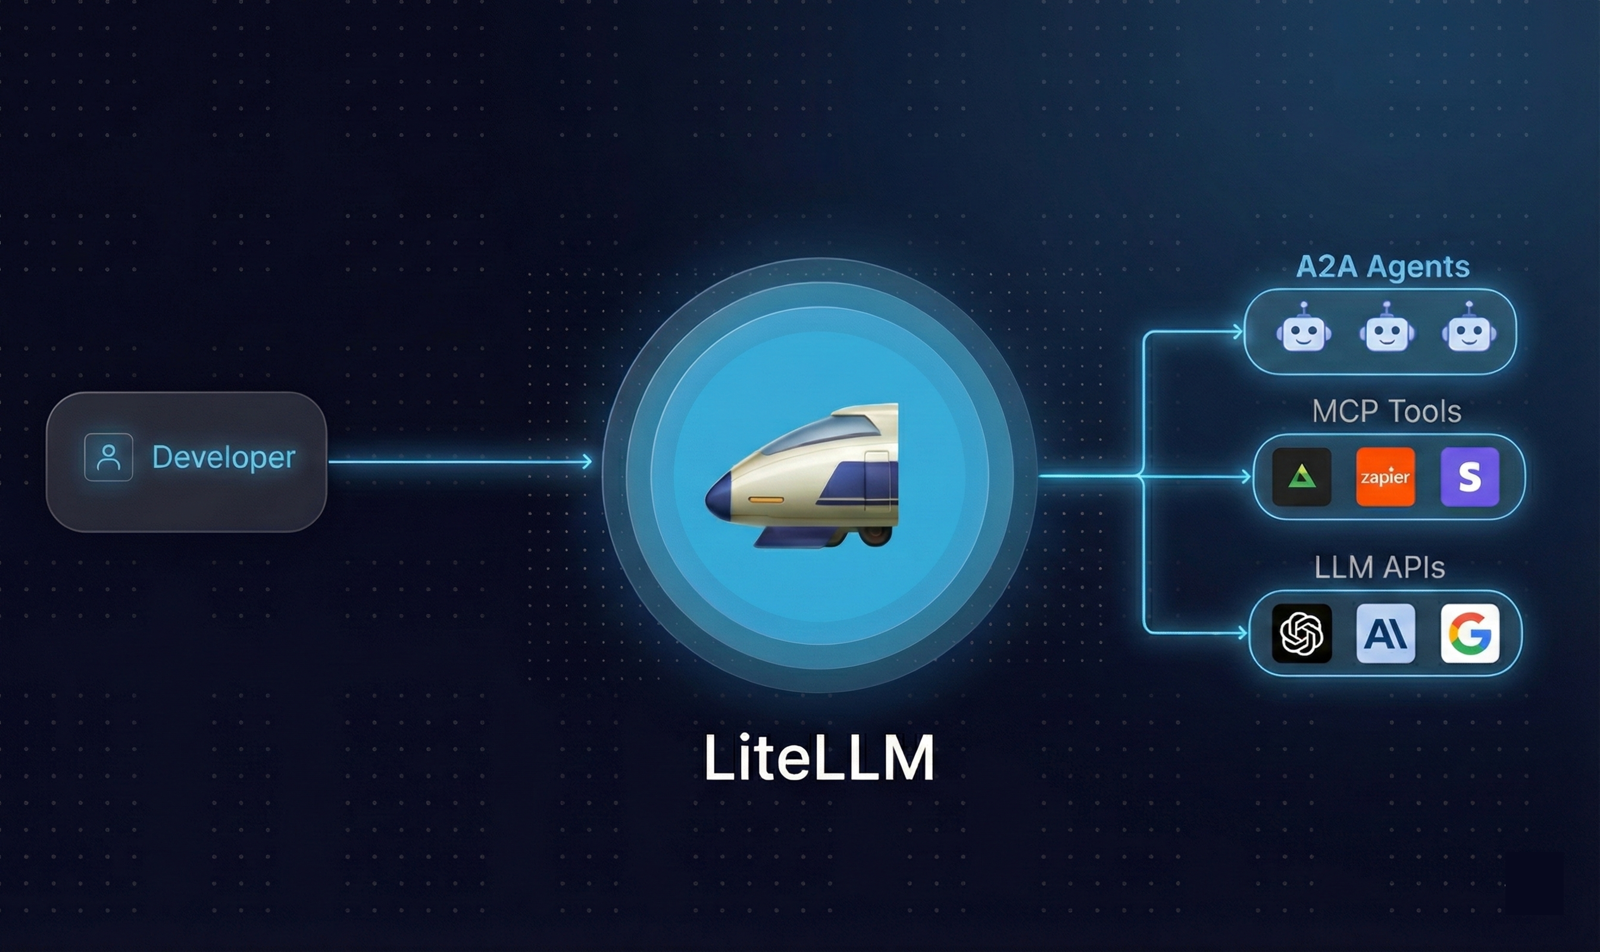

LiteLLM:统一 100+ 大模型 API 的网关与代理(OpenAI 兼容)|部署与使用全指南
适用版本:基于 LiteLLM 官方仓库(BerriAI/litellm)与官方文档(docs.litellm.ai)在 2025 年末至 2026 年初的真实状态撰写。项目当前非常活跃(发布线已到 v1.80.x 系列,每日均有提交与 nightly/rc 构建),并以每月多次的稳定版节奏发布。
一句话定位:用统一的 OpenAI 格式调用 100+ 大模型(OpenAI / Anthropic / Gemini / Bedrock / Azure / 本地模型等)的网关与代理,提供负载均衡、成本统计、限流与密钥管理。

一、项目简介与适用场景
1.1 它是什么
LiteLLM 是一个开源 AI 网关(AI Gateway)。它把 100+ 家大模型供应商(OpenAI、Anthropic、Google Gemini、AWS Bedrock、Azure OpenAI、Vertex AI、Groq、Ollama 本地模型等)统一封装成同一个 OpenAI 兼容的接口。你只需要面向一套 /v1/chat/completions 等端点写代码,LiteLLM 在背后负责把请求翻译成各家供应商的格式、再把响应翻译回 OpenAI 格式。
它有两种使用形态:
1.2 核心收益
统一 API:100+ 模型一个接口,告别各家 SDK、鉴权、请求/响应格式的差异。
OpenAI 兼容(drop-in):无需改代码即可在不同供应商之间切换,任何支持 OpenAI 格式的工具(OpenWebUI、LangChain、Cursor 等)都能直接对接。
生产级网关能力:虚拟密钥(Virtual Keys)、用量与成本统计(Spend Tracking)、预算与限流(Budgets & Rate Limits)、负载均衡、失败回退(Fallbacks)、管理后台开箱即用。
高性能:官方基准在 1k RPS 下 P95 延迟约 8ms。
1.3 典型适用场景
二、核心功能逐条拆解
三、全套官方链接
MIT 与企业版差异说明:仓库根目录
LICENSE明确——除enterprise/目录外的所有内容均以 MIT 许可发布;enterprise/目录(若存在)遵循其自身的enterprise/LICENSE。在 MIT 部分之上,企业版(Enterprise Tier)通过 License Key 解锁额外能力:单点登录(SSO)、SCIM 用户同步、全量管理员审计日志、分团队管理员、多区域部署以及官方工程支持。这些能力不开源、不在默认镜像内,需要商业授权。普通自托管、网关、负载均衡、虚拟密钥、成本统计、限流等核心功能全部在 MIT 开源部分,可免费商用。
四、硬件与环境前置要求
LiteLLM 本质是一个 API 网关/代理,本身不做模型推理,因此不需要 GPU;真正消耗算力的是被它转发的上游供应商或你自建的本地模型服务。
稳定版提示:生产环境务必固定版本标签(如
:v1.90.2或:v1.90.2-stable),不要长期用:latest或滚动标签,以便回滚可复现。所有镜像均经签名(cosign)。
五、多平台部署实战
下面给出三条路线:Docker(推荐)、pip 安装、源码安装。三种方式最终都启动同一个代理服务(默认端口 4000)。
5.1 Docker 一键部署(推荐,含 Postgres + 后台)
这是官方推荐的新手路线,自动拉起网关与 Postgres(用于存模型、密钥、用量)。
# 1) 下载官方快速开始 compose 文件
curl -sSLO https://github.com/BerriAI/litellm/raw/main/docker/docker-compose.quickstart.yml

# 2) 生成主密钥与加密盐(务必保存 .env,SALT_KEY 不可更改)
printf 'LITELLM_MASTER_KEY=sk-%s\nLITELLM_SALT_KEY=sk-%s\n' \
  "$(openssl rand -hex 32)" "$(openssl rand -hex 32)" > .env

# 3) 后台启动
docker compose -f docker-compose.quickstart.yml up -d
启动后访问 http://localhost:4000/ui:用户名 admin,密码即你 .env 里的 LITELLM_MASTER_KEY。在 Models + Endpoints → Add Model 添加供应商与模型,Virtual Keys 生成虚拟密钥,Playground 直接发请求测试。
5.2 Docker 纯代理(无数据库,仅 OpenAI 兼容转发)
适合只想做统一转发、不需要密钥/预算/后台的场景:
# litellm_config.yaml
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
docker run \
  -v $(pwd)/litellm_config.yaml:/app/config.yaml \
  -e OPENAI_API_KEY=<your-openai-key> \
  -e LITELLM_MASTER_KEY=sk-<paste-a-long-random-key> \
  -p 4000:4000 \
  docker.litellm.ai/berriai/litellm:latest \
  --config /app/config.yaml
⚠️ 无数据库时预算不生效:
litellm_settings.max_budget等全局预算依赖数据库;不连库时即便配了max_budget: 100也会继续放行、且无预算告警(启动仅打一行警告)。需要预算管控务必按 5.1 连 Postgres。
5.3 pip 安装(Python 环境)
# 安装含代理(proxy)额外依赖的版本
pip install 'litellm[proxy]'
# 或使用 uv
uv tool install 'litellm[proxy]'

# 准备 config.yaml 后用配置启动
litellm --config /path/to/config.yaml
若只做库级 SDK 调用(不启代理),直接
pip install litellm即可,代码中from litellm import completion。
5.4 源码安装(开发 / 自定义)
git clone https://github.com/BerriAI/litellm.git
cd litellm
python -m venv .venv && source .venv/bin/activate
pip install -e '.[proxy]'      # 可编辑安装含 proxy 依赖

# 启动代理
litellm --config config.yaml
另有一个独立的
litellm-core发行包(import litellm同款 API、无 CLI/后台/可选依赖),用于纯 SDK 环境;同一环境不要同时装litellm与litellm-core。
5.5 验证启动
curl http://localhost:4000/v1/chat/completions \
  -H 'Authorization: Bearer sk-<your-virtual-key-or-master-key>' \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gpt-4o",
    "messages": [{"role": "user", "content": "Say hello in five words."}]
  }'
预期返回标准 OpenAI 格式的 choices 与 usage。控制台出现 LiteLLM: Proxy initialized with Config, Set models: 表明 config.yaml 已正确加载。
六、配置文件参数全解(config.yaml)
config.yaml 是代理服务的核心。下面逐段解释关键参数。
6.1 model_list —— 模型与部署定义
示例:同一模型名挂两个 Azure 部署做负载均衡
model_list:
  - model_name: gpt-4o                # 客户端用的名字
    litellm_params:
      model: azure/gpt-4o-eu
      api_base: https://xxx.openai.azure.com/
      api_key: os.environ/AZURE_API_KEY_EU
      rpm: 6
  - model_name: gpt-4o
    litellm_params:
      model: azure/gpt-4o-ca
      api_base: https://yyy.openai.azure.com/
      api_key: os.environ/AZURE_API_KEY_CA
      rpm: 6
  - model_name: local-llama
    litellm_params:
      model: ollama/llama3
      api_base: http://host.docker.internal:11434
      api_key: none
通配模型:
- model_name: "*"+litellm_params.model: "*"可让所有供应商默认模型无需逐个声明即可用(依赖.env里的默认供应商凭据)。
6.2 router_settings —— 路由与容错
6.3 litellm_settings —— 模块级设置
6.4 general_settings —— 服务级设置
6.5 一个较完整的示例
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
      rpm: 100
  - model_name: claude
    litellm_params:
      model: bedrock/us.anthropic.claude-sonnet-5
      aws_region_name: us-east-1

litellm_settings:
  drop_params: True
  num_retries: 3
  request_timeout: 30
  fallbacks: [{"gpt-4o": ["claude"]}]

router_settings:
  routing_strategy: simple-shuffle
  timeout: 30

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL
config.yaml vs 数据库:开启
store_model_in_db后,后台/API 对general_settings、router_settings、litellm_settings、environment_variables的修改会写入数据库并在每次启动/刷新时覆盖 YAML 同名键(深合并,数据库优先);model_list不在其列,仍与数据库中的模型并列、参与负载均衡。改这些键请以 UI/API 为准或删除对应库表行。
七、启动 / 后台常驻 / 开机自启 / 改端口
7.1 改端口
7.2 systemd 后台常驻 + 开机自启(Linux 服务器推荐)
创建 /etc/systemd/system/litellm.service:
[Unit]
Description=LiteLLM Proxy
After=network.target

[Service]
User=litellm
WorkingDirectory=/opt/litellm
Environment=OPENAI_API_KEY=xxx
Environment=LITELLM_MASTER_KEY=sk-xxx
Environment=DATABASE_URL=postgresql://user:pass@host:5432/litellm
ExecStart=/opt/litellm/.venv/bin/litellm --config /opt/litellm/config.yaml --port 4000
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
sudo systemctl daemon-reload
sudo systemctl enable --now litellm      # 开机自启并立即启动
sudo systemctl status litellm
sudo journalctl -u litellm -f            # 看日志
7.3 pm2 后台常驻(Node 风格进程管理,跨平台友好)
npm install -g pm2
pm2 start "litellm --config config.yaml --port 4000" --name litellm
pm2 save
pm2 startup                          # 生成开机自启脚本(按提示执行)
pm2 logs litellm
7.4 Docker 后台与开机自启
# 已在 5.1 用 docker compose up -d 后台运行
# 开机自启:在 compose 文件中给服务加
#   restart: unless-stopped
# 或 Docker Desktop / systemd 的 docker.service 开机启动即可
docker compose -f docker-compose.quickstart.yml ps
docker logs -f <container-name>
八、功能实操教程
8.1 配置多模型并统一调用
在 config.yaml 的 model_list 中分别定义 OpenAI、Anthropic(Bedrock)、本地 Ollama 等,对外各给一个 model_name。客户端统一用 OpenAI SDK 指向网关:
import openai
client = openai.OpenAI(api_key="sk-<虚拟密钥>", base_url="http://localhost:4000")
# 切换模型只需改 model 字符串
resp = client.chat.completions.create(
    model="gpt-4o",                       # 或 "claude" / "local-llama"
    messages=[{"role": "user", "content": "你好"}]
)
8.2 负载均衡
把同一个 model_name 指向多个部署(不同 api_base 或不同区域),并设置 rpm/tpm,再选 router_settings.routing_strategy:
model_list:
  - model_name: zephyr
    litellm_params: { model: huggingface/.../zephyr-7b-beta, api_base: http://0.0.0.0:8001, rpm: 60 }
  - model_name: zephyr
    litellm_params: { model: huggingface/.../zephyr-7b-beta, api_base: http://0.0.0.0:8002, rpm: 600 }
router_settings:
  routing_strategy: simple-shuffle   # 配合 rpm/tpm 加权,吞吐最佳
官方压测结论:给所有部署设置 tpm/rpm + simple-shuffle 可最大化吞吐;多 LiteLLM 实例/ K8s 时再配置 Redis。
8.3 虚拟密钥(Virtual Key)
虚拟密钥是发给应用/同事的“替身钥匙”,替代真实供应商 key,并自带预算、限流、模型白名单。
生成密钥(需连 Postgres):
curl -X POST 'http://localhost:4000/key/generate' \
  -H 'Authorization: Bearer <your-master-key>' \
  -H 'Content-Type: application/json' \
  -d '{
    "models": ["gpt-4o", "claude"],
    "max_budget": 20,
    "budget_duration": "1mo",
    "rpm_limit": 60,
    "tpm_limit": 100000,
    "metadata": {"user": "team-a@corp.com"}
  }'
响应里的 key 只显示一次,妥善保存。随后用该 key 调用:
curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer sk-<生成的虚拟密钥>" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-4o","messages":[{"role":"user","content":"hi"}]}'
预算/用量查询:GET /key/info?key=<虚拟密钥>(返回该 key 的 spend 等);封禁/解封:POST /key/block、POST /key/unblock。还可用 aliases 在 key 上做模型升级/降级映射(如把请求里的 gpt-4 映射到便宜的 my-free-tier)。
8.4 成本与日志
自动计费:每次
/chat/completions等调用后,按内置价目表(model_prices_and_context_window.json)累加花费,分别写入LiteLLM_VerificationTokenTable(key)、LiteLLM_UserTable(user)、LiteLLM_TeamTable(team)。查看:管理后台 Logs 与 Usage 页;或用
/key/info、/user/info、/team/infoAPI。导出/可观测:通过
success_callback接入 Langfuse、Arize Phoenix、Langsmith、OTEL,或把日志写进 S3/GCS(litellm_settings里配置)。
8.5 与 OpenWebUI 集成
OpenWebUI 是流行的自托管聊天界面,可把它指向 LiteLLM 网关,从而在一个界面里访问 100+ 模型并统一统计成本。
步骤:
启动 LiteLLM(见第五、七章),确保已生成虚拟密钥并连了数据库。
在 LiteLLM 后台建团队与虚拟密钥:访问
http://localhost:4000/ui→ 新建 Team → 在 Virtual Keys 为该团队生成密钥,并在models字段限定该密钥可访问的模型。把 OpenWebUI 指向 LiteLLM:在 OpenWebUI 中
Settings → Connections → OpenAI API,填写: - URL:http://<litellm-host>:4000(你的 LiteLLM 代理基地址) - Key:上一步生成的虚拟密钥(不要复用LITELLM_MASTER_KEY)测试:左上角选模型时只会看到该密钥被授权的模型;发送消息即可。
用量追踪:请求后到 LiteLLM 后台 Logs 查看模型、用量与成本。
按用户追踪(可选):在 OpenWebUI 侧设置环境变量 ENABLE_FORWARD_USER_INFO_HEADERS=True;在 LiteLLM config.yaml 加:
general_settings:
  user_header_mappings:
    - header_name: X-OpenWebUI-User-Id
      litellm_user_role: internal_user
    - header_name: X-OpenWebUI-User-Email
      litellm_user_role: customer
(可用请求头:X-OpenWebUI-User-Id / X-OpenWebUI-User-Email / X-OpenWebUI-User-Name。)
Docker Compose 直连示例(OpenWebUI 与 LiteLLM 同网络):
services:
  litellm:
    image: docker.litellm.ai/berriai/litellm:latest
    ports: ["4000:4000"]
    environment:
      - OPENAI_API_KEY=${OPENAI_API_KEY}
      - LITELLM_MASTER_KEY=${LITELLM_MASTER_KEY}
      - DATABASE_URL=${DATABASE_URL}
    volumes: ["${PWD}/config.yaml:/app/config.yaml"]
    command: ["--config", "/app/config.yaml"]

  open-webui:
    image: ghcr.io/open-webui/open-webui:latest
    ports: ["3000:8080"]
    environment:
      - OPENAI_API_BASE_URLS=http://litellm:4000/v1
      - OPENAI_API_KEYS=${LITELLM_VIRTUAL_KEY}
    depends_on: [litellm]
九、全套报错故障排查(10 条)
健康检查:
GET /health/liveliness(存活)、GET /health/readiness(就绪,数据库不可达时返回 503)、GET /health/readiness/details(含版本信息),可用于负载均衡探针。
十、升级 / 回滚 / 卸载教程
10.1 升级
Docker:改镜像标签后重新拉取并重启,例如把
:latest改为:v1.90.2-stable:bash docker compose -f docker-compose.quickstart.yml pull docker compose -f docker-compose.quickstart.yml up -dpip:
pip install -U 'litellm[proxy]'(建议先在虚拟环境/测试机验证)。数据库迁移:官方镜像会按需执行迁移;多实例生产环境建议设
DISABLE_SCHEMA_UPDATE=true,由独立的 migrations job(Helm/K8s)统一执行,避免并发迁移冲突。
10.2 回滚
Docker:把镜像标签退回上一个已知良好版本(如
:v1.90.1-stable)再up -d即可——这正是生产必须固定版本标签的原因。pip:
pip install 'litellm[proxy]==<旧版本号>'。注意:若新版已执行不可逆的数据库 schema 迁移,仅回滚代码可能不兼容;回滚前确认迁移是否可向下兼容,必要时从备份恢复数据库。
10.3 卸载
Docker:
docker compose -f docker-compose.quickstart.yml down(加-v可同时删除卷,会清除 Postgres 数据,谨慎!)。pip:
pip uninstall litellm(若用 venv 直接删 venv 目录更干净)。源码:删除克隆目录与虚拟环境;若
pip install -e过,先pip uninstall litellm。systemd/pm2:
sudo systemctl disable --now litellm/pm2 delete litellm && pm2 save。数据清理:卸载后记得清理
.env(含主密钥/盐)、config.yaml、Postgres 数据库与任何导出的日志/密钥,避免敏感信息残留。
十一、商用许可与合规风险提示
11.1 MIT 商用
仓库根 LICENSE 明确:除 enterprise/ 目录外,所有内容以 MIT 许可发布。这意味着你可以免费用于商业用途:使用、复制、修改、分发、再许可、乃至销售,只需在副本中保留版权声明与许可声明。网关、负载均衡、虚拟密钥、成本统计、限流、管理后台等核心能力全部在 MIT 部分,可自托管并商用。
11.2 企业版功能差异
enterprise/ 目录遵循其自有许可,不在 MIT 范围内。企业版通过 License Key 在同一套网关上解锁:
这些能力不开源、不在默认镜像内,需要向官方购买企业授权。是否需要企业版取决于你的合规与组织管理诉求,纯技术网关能力无需付费。
11.3 API Key 与用量安全
密钥分级:对外一律发虚拟密钥,绝不要把
LITELLM_MASTER_KEY或供应商原始 key 交给应用/前端;虚拟密钥可设预算、限流、模型白名单并随时封禁。主密钥与盐:
LITELLM_MASTER_KEY等同 root 密码,存密钥管理器、不进源码、泄漏即轮换;LITELLM_SALT_KEY一旦用于加密库内凭据就不可更改,改了会让已有凭据不可读。数据库与 Redis 凭据:
DATABASE_URL、Redis 密码等属于敏感信息,优先用云密钥管理器(如 AWS Secrets Manager / K8s Secret / Key Vault CSI),避免明文落盘。后台访问:生产环境开启
disable_env_credential_login,改用数据库用户 + 密码或 SSO 登录;并配置trusted_proxy_ranges以正确识别客户端、启用登录失败限流(默认单地址 60 秒内 10 次失败封 5 分钟)。用量与成本护栏:为 key/team 设置
max_budget与budget_duration,并在供应商侧也设置硬上限(无数据库时 LiteLLM 预算不强制,需上游兜底)。传输安全:生产在网关前放 TLS 终止(Ingress / ALB),不要明文暴露
:4000到公网;健康检查仅用/health/*,管理 API 必须走鉴权。合规:用量日志可能包含提示词与内容,导出到 S3/GCS/Langfuse 等第三方时留意数据驻留与脱敏;多租户场景用 team/user 隔离与审计日志满足内部合规。
结语:LiteLLM 是当下最被广泛采用的开源 AI 网关,MIT 许可下即可免费自托管、统一接入 100+ 模型并具备生产级的成本、限流与密钥治理能力;把官方镜像固定到稳定标签、配好 Postgres/Redis 与密钥管理,就能以很低的上手成本获得一套企业级的模型接入中台。