
GPT-SoVITS —— 少样本中文语音克隆与语音合成(5 秒零样本 / 1 分钟微调)
适用场景说明:本节面向博主「个人电脑本地部署」场景,环境基线为 Windows 10/11 + WSL2(Ubuntu 24.04)、RTX 3070 8GB / RTX 4090 24GB,另含 Linux 云服务器视角。所有事实均以官方 GitHub README、LICENSE、源码与官方 HF 仓库为准;官方未公布的数值在文中明确标注「README 未给出 / 待实测」,不做推测填充。
项目定位与基本信息
| 项目 | 内容 |
|---|---|
| 一句话定位 | 一个支持零样本 TTS(输入约 5 秒参考音频即可合成目标音色)与少样本微调(约 1 分钟训练数据提升相似度)的强少样本语音转换 / 文本转语音 WebUI,内置伴奏分离、自动切片、中文 ASR、文本标注等数据集制作工具链。 |
| 开源许可 | MIT License(Copyright © 2024 RVC-Boss)。出处:官方仓库 LICENSE 文件原文为 MIT License;README 顶部 LICENSE 徽章链接指向 https://github.com/RVC-Boss/GPT-SoVITS/blob/main/LICENSE。 |
| 官方 GitHub 仓库 | https://github.com/RVC-Boss/GPT-SoVITS |
| 官方文档 / 官网 | 简体中文官方指南(语雀):https://www.yuque.com/baicaigongchang1145haoyuangong/ib3g1e —— README 顶部「简体中文」徽章指向该站,为项目官方中文用户手册;英文指南:https://rentry.co/GPT-SoVITS-guide#/ (README「English」徽章指向,本部署环境网络受限未连通,链接以官方 README 为准)。在线体验 Demo:https://lj1995-gpt-sovits-proplus.hf.space/ (README 徽章链接的 Hugging Face Space)。更新日志:https://github.com/RVC-Boss/GPT-SoVITS/blob/main/docs/en/Changelog_EN.md |
| 支持语种 | 官方 README 功能说明:英文、日文、韩文、粤语、中文(English, Japanese, Korean, Cantonese and Chinese);WebUI 推理语种下拉另含「中英混合 / 日英混合 / 粤英混合 / 韩英混合 / 多语种混合」等混合模式(见 04.5 参数表,来源为官方推理 WebUI 源码)。 |
| 版本信息 | 截至 2026-10-25 核查:GitHub Releases 页面最新标签为 20250606v2pro(发布于 2025-06-06 03:04:27Z,来源:https://github.com/RVC-Boss/GPT-SoVITS/releases ,curl 抓取 release 页面 HTML 核实 datetime);GitHub release 页面仅托管源码,Windows 整合包托管在官方 HF 仓库(见 04.4)。README Python 徽章标注 3.10–3.12。 |
官方图片
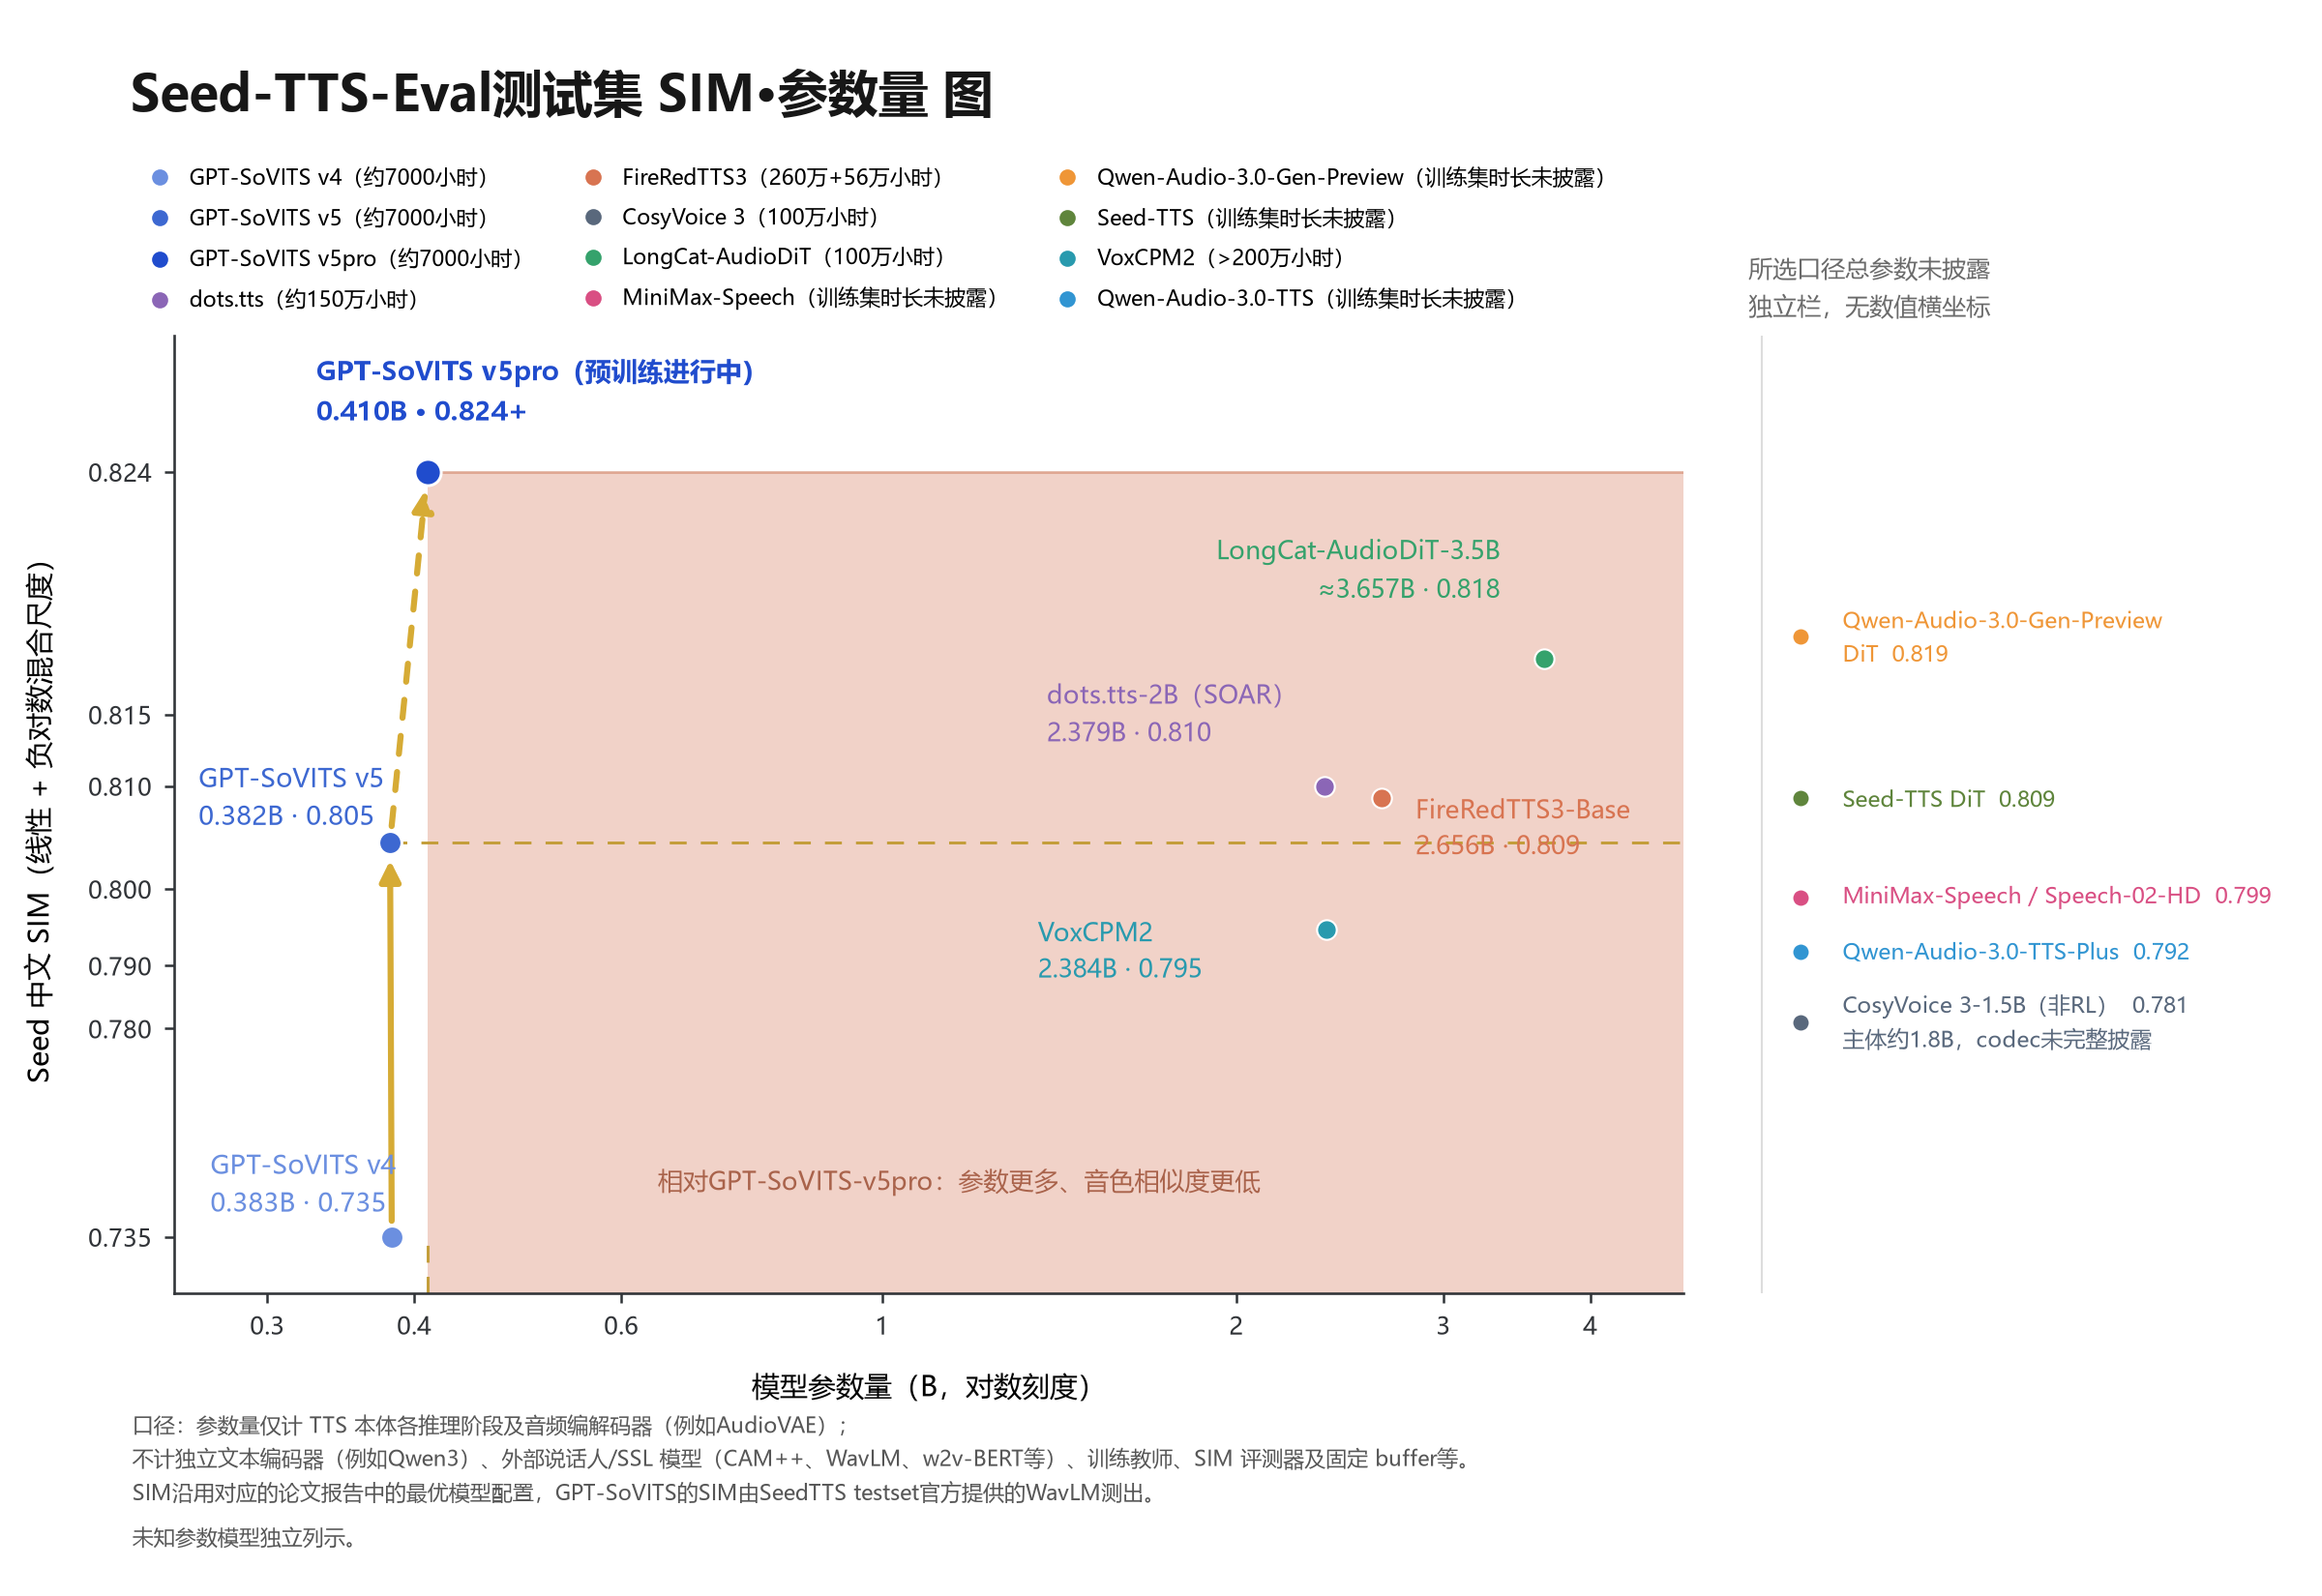
- 下图来自官方 README「Zero-Shot TTS Speaker Similarity Comparison Image on SeedTTS Eval Testset_CN2020」小节,为官方音色相似度对比图(非 AI 生成、非第三方图片):

| 项目 | 记录 |
|---|---|
| 本地文件 | https://zhouruolin.cn/upload/04_gptsovits_seedtts_compare.png |
| 图片来源 URL | https://github.com/user-attachments/assets/8c2a0e0a-7212-4b77-b5ef-2d192e09127f (官方 README 第 55 行 <img src=...> 引用) |
| 下载方式 | curl -sL -o 04_gptsovits_seedtts_compare.png "https://github.com/user-attachments/assets/8c2a0e0a-7212-4b77-b5ef-2d192e09127f" |
| 格式 / 体积校验 | file 命令确认:PNG image data, 2400 x 1650, 8-bit/color RGBA, non-interlaced;体积 418,844 字节(约 409 KB),大于 20 KB 阈值。 |
说明:官方 README 未提供独立 logo 文件,另一处官方素材为 GitHub 附件中的演示视频(https://github.com/RVC-Boss/GPT-SoVITS/assets/129054828/05bee1fa-bdd8-4d85-9350-80c060ab47fb ,视频,非图片,故未纳入本节图集)。本节仅使用上述 1 张官方静态图。
环境要求
以下表格中,官方 README 「Tested Environments」实测组合列于「依赖 / 版本实测记录」行;README 未公布的显存、内存下限均如实标注。
| 维度 | 官方说明与实测记录 |
|---|---|
| 操作系统 | README 标注 Windows 实测版本为 win>=10;源码安装支持 Linux、macOS(README Installation 分 Windows / Linux / macOS 三节)。WSL2(Ubuntu 24.04)按官方 Linux 流程部署即可;GPU 直通依赖 Windows 侧已安装 NVIDIA 驱动。 |
| GPU 与显存 | 官方 README 未公布各版本模型的显存下限数值(待实测)。README 实测环境表覆盖 NVIDIA CUDA 11.8 / 12.4 / 12.8、Apple silicon 与纯 CPU;官方给出的速度基准为 GPT-SoVITS v2 ProPlus 推理 RTF:4060Ti 上 0.028、4090 上 0.014(1400 词约 4 分钟文本,推理 3.36 秒)、M4 CPU 上 0.526(来源:README「RTF of GPT-SoVITS v2 ProPlus」段)。Docker 部署说明中提供 is_half 半精度开关:GPU 支持时设 true 以降低显存占用。 |
| 内存 | README 未公布独立内存下限(待实测)。 |
| 依赖(官方实测组合,README Tested Environments 原表) | Python 3.10 + PyTorch 2.5.1 + CUDA 12.4;Python 3.11 + PyTorch 2.5.1 + CUDA 12.4;Python 3.11 + PyTorch 2.7.0 + CUDA 12.8;Python 3.9 + PyTorch 2.8.0dev + CUDA 12.8;Python 3.12 + PyTorch 2.7.1 + CUDA 11.8;Python 3.12 + PyTorch 2.7.1 + CUDA 12.8;Python 3.9 + PyTorch 2.5.1(Apple silicon);Python 3.11 + PyTorch 2.7.0(Apple silicon);Python 3.9 + PyTorch 2.2.2(CPU)。源码 requirements.txt 关键约束:numpy<2.0、librosa==0.10.2、transformers>=4.51,<5、peft<0.18.0、ctranslate2>=4.0,<5、gradio<5、onnxruntime-gpu(x86_64)、funasr>=1.3.7、av>=11 等。 |
| 磁盘空间(含模型权重体积,本环境实测) | ① Windows 整合包:README 当前指引文件 GPT-SoVITS-v3lora-20250228.7z 为 6,754,961,256 字节(约 6.29 GiB,HEAD 请求实测 content-length);HF 仓库内更新版本 GPT-SoVITS-v5-20261005.7z 为 10,869,231,773 字节(约 10.12 GiB)、GPT-SoVITS-v5-20261005nvidia50x0.7z 为 10,644,775,528 字节(约 9.91 GiB),均为 HF 仓库文件列表 + HEAD 实测;解压后预留空间建议按压缩包 1.5–2 倍估算(非官方数值,属经验建议)。② 源码部署预训练底模:官方 HF 仓库 lj1995/GPT-SoVITS 全版本文件合计约 6.4 GB(HF tree API 实测),实际按需下载所用版本子集。③ 中文前端 G2PWModel.zip:588,856,634 字节(约 561.6 MiB,HEAD 实测)。④ 可选 UVR5 人声分离权重:约 594.4 MB(HF tree API 实测)。⑤ 可选中文 ASR(Damo paraformer / VAD / 标点)与英日 ASR(faster-whisper-large-v3)另需额外磁盘。 |
最详细部署步骤(Windows 与 WSL2 双视角)
方案 A:Windows 官方整合包(免环境、解压即用,README 首选方案)
README「Windows」节原文指引:Windows 用户(tested with win>=10)下载整合包后双击 _go-webui.bat 启动 WebUI。
1. 依赖安装
- 整合包内置 Python 运行环境,无需自行安装 Python / PyTorch。
- 安装 Visual Studio 2017 运行库(README 指引):https://aka.ms/vs/17/release/vc_redist.x86.exe
- 提示:README 手动安装节要求 Windows 用户把
ffmpeg.exe、ffprobe.exe放到项目根目录(README 未明确说明整合包是否已内置这两个程序);整合包启动后若提示缺少 FFmpeg,再按 04.4 方案 B 的 Windows 小节补放。
2. 项目下载(官方 release / HF 整合包链接,已逐一验证)
README 当前正文链接(2026-10-25 复核可访问,HTTP 302 → 200):
https://huggingface.co/lj1995/GPT-SoVITS-windows-package/resolve/main/GPT-SoVITS-v3lora-20250228.7z?download=true
- 国内网络加速:README 为中国大陆用户提供了国内下载页(语雀):https://www.yuque.com/baicaigongchang1145haoyuangong/ib3g1e/dkxgpiy9zb96hob4 (README「Users in China can download the package here」链接)。
- HF 仓库文件列表(含更新的 v5 包与 nvidia50 变体,来源 https://huggingface.co/lj1995/GPT-SoVITS-windows-package ,HF API 实测):
| 文件名 | 体积(HEAD 实测) | 说明 |
|---|---|---|
| GPT-SoVITS-v3lora-20250228.7z | 6.29 GiB | README 正文当前指引版本 |
| GPT-SoVITS-v4-20250529.7z | 6.98 GiB(7,493,794,100 字节) | v4 版本 |
| GPT-SoVITS-v2pro-20250604.7z | 7.62 GiB(8,185,086,602 字节) | v2Pro 版本 |
| GPT-SoVITS-v5-20261005.7z | 10.12 GiB | HF 仓库内最新 v5 整合包 |
| GPT-SoVITS-v5-20261005nvidia50x0.7z | 9.91 GiB | v5 的 NVIDIA 50 系变体 |
选择建议(非 README 强制规定):纯按 README 正文走即选 v3lora 包;想体验 v5 音色相似度与 CUDA Graph / flash attention 加速可选用 v5 包。nvidia50 系列变体面向 RTX 50 系显卡,3070 / 4090 选择普通包即可。
3. 模型 / 权重下载
- 整合包已内置对应底模,一般无需手动下载;手动补充模型的放置目录见下方方案 B 第 3 步(目录结构相同)。
4. 关键配置
| 配置项 | 值 / 目录 | 来源 |
|---|---|---|
| 解压根目录 | 建议纯英文短路径(如 D:\GPT-SoVITS),避免中文、空格、括号 |
实践经验;README 未单独成文,04.6 常见坑第 1 条说明 |
| 内置 WebUI 启动脚本 | _go-webui.bat(README 第 78 行);整合包目录另提供 go-webui.bat / go-webui.ps1,go-webui-v1.bat / go-webui-v1.ps1 切换 v1 版本,go-webui-v2.bat / go-webui-v2.ps1 打开独立推理 WebUI(README「Finetune and inference」节) |
官方 README |
5. 启动
# 解压后进入目录,双击即可,等价命令:
.\go-webui.bat
# 如需 v1 版本:
.\go-webui-v1.bat
# 仅打开推理 WebUI:
.\go-webui-v2.bat
浏览器自动打开本地 Gradio 页面(默认监听本机回环地址;具体端口以启动终端输出为准,README 未固化端口号)。
方案 B:WSL2(Ubuntu 24.04)源码部署(官方 install.sh 一键脚本)
README「Linux」节官方命令(环境前置:Anaconda / Miniconda 已安装;WSL2 内已可 nvidia-smi 看到 3070 / 4090):
1. 依赖安装(conda 环境 + 一键脚本自动装 torch / CUDA 依赖)
# 进入准备好的项目目录
git clone https://github.com/RVC-Boss/GPT-SoVITS.git
cd GPT-SoVITS

# 官方 README Linux 节命令
conda create -n GPTSoVits python=3.10
conda activate GPTSoVits

# --device 可选 CU126 | CU128 | ROCM | CPU;--source 可选 HF | HF-Mirror | ModelScope
# 国内网络直接选 HF-Mirror 或 ModelScope,脚本自动走对应镜像源拉取模型
bash install.sh --device CU128 --source HF-Mirror --download-uvr5
install.sh 参数表(已核对官方脚本 print_help 输出,来源:仓库 install.sh 源码):
| 参数 | 取值 | 说明 |
|---|---|---|
--device |
CU126 / CU128 / ROCM / MPS / CPU |
必选;3070/4090 按 WSL2 内 CUDA 工具链版本选 CU126 或 CU128;纯推理无 NVIDIA GPU 选 CPU |
--source |
HF / HF-Mirror / ModelScope |
必选;模型下载源;国内推荐 HF-Mirror 或 ModelScope |
--download-uvr5 |
开关 | 可选;是否额外下载 UVR5 人声分离模型 |
-h, --help |
开关 | 查看帮助 |
2. 项目下载 / 安装(手动等价步骤,README「Install Manually」节)
一键脚本失败时可按 README 手动流程安装:
conda create -n GPTSoVits python=3.10
conda activate GPTSoVits

# README 原文顺序:先装 extra-req(--no-deps),再装主依赖
pip install -r extra-req.txt --no-deps
pip install -r requirements.txt
FFmpeg 安装(README「Install FFmpeg → Ubuntu/Debian Users」节):
sudo apt update
sudo apt install ffmpeg
sudo apt install libsox-dev
# conda 用户等价方式:
conda install ffmpeg
Windows 源码部署等价命令(README「Windows」节 PowerShell):
conda create -n GPTSoVits python=3.10
conda activate GPTSoVits
pwsh -F install.ps1 --Device CU128 --Source HF-Mirror [--DownloadUVR5]
# --Device 可选 CU126 | CU128 | CPU;--Source 可选 HF | HF-Mirror | ModelScope(已核对 install.ps1 param 定义)
Windows 手动安装 FFmpeg:README 指引将 ffmpeg.exe(https://huggingface.co/lj1995/VoiceConversionWebUI/blob/main/ffmpeg.exe )与 ffprobe.exe(https://huggingface.co/lj1995/VoiceConversionWebUI/blob/main/ffprobe.exe )放入项目根目录。
3. 模型 / 权重下载(README「Pretrained Models」节;install.sh 跑成功可跳过第 1、2、3 项)
| 序号 | 模型 | 官方来源 | 放置目录(README 原文) |
|---|---|---|---|
| 1 | GPT-SoVITS 预训练底模 | https://huggingface.co/lj1995/GPT-SoVITS | GPT_SoVITS/pretrained_models |
| 2 | G2PW 中文前端模型(仅中文 TTS 需要) | HF:https://huggingface.co/XXXXRT/GPT-SoVITS-Pretrained/resolve/main/G2PWModel.zip ;ModelScope:https://www.modelscope.cn/models/XXXXRT/GPT-SoVITS-Pretrained/resolve/master/G2PWModel.zip | 解压后重命名为 G2PWModel,放入 GPT_SoVITS/text |
| 3 | UVR5 人声 / 伴奏分离、去混响权重(可选) | https://huggingface.co/lj1995/VoiceConversionWebUI/tree/main/uvr5_weights | tools/uvr5/uvr5_weights |
| 4 | 中文 ASR 三件套(可选,数据集制作) | Damo ASR:https://modelscope.cn/models/damo/speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch/files ;Damo VAD:https://modelscope.cn/models/damo/speech_fsmn_vad_zh-cn-16k-common-pytorch/files ;Damo 标点:https://modelscope.cn/models/damo/punc_ct-transformer_zh-cn-common-vocab272727-pytorch/files | tools/asr/models |
| 5 | 英文 / 日文 ASR(可选) | https://huggingface.co/Systran/faster-whisper-large-v3 ;README 注明亦可选用 Systran 仓库下其他体积更小的模型 | tools/asr/models |
国内加速方案:
- 官方脚本内置
--source HF-Mirror/ModelScope两个国内友好源(README 官方支持,优先使用)。 - 手动
pip/ 模型下载场景,可使用 Hugging Face Hub 标准环境变量HF_ENDPOINT切换镜像(机制来自底层 huggingface_hub 库,环境变量说明见 https://huggingface.co/docs/huggingface_hub/guides/environment-variables ):
export HF_ENDPOINT=https://hf-mirror.com
- 各版本专用目录(README 各版本发布说明,供升级时对照):v2 底模放
GPT_SoVITS/pretrained_models/gsv-v2final-pretrained;v3 底模(s1v3.ckpt、s2Gv3.pth、models--nvidia--bigvgan_v2_24khz_100band_256x文件夹)放GPT_SoVITS/pretrained_models;v4 底模(gsv-v4-pretrained/s2v4.pth、gsv-v4-pretrained/vocoder.pth)放GPT_SoVITS/pretrained_models;v2Pro 底模(v2Pro/四个权重 +sv/pretrained_eres2netv2w24s4ep4.ckpt)放GPT_SoVITS/pretrained_models;v5 底模保持gsv-v5-pretrained子目录,即最终路径GPT_SoVITS/pretrained_models/gsv-v5-pretrained(README V5 Release Notes)。
RTX 3070 8GB 降级选择(README 官方支持项与可选项分列):
| 手段 | 官方依据 |
|---|---|
| 推理优先、先不做微调训练 | README 未区分推理 / 训练显存数值(待实测);官方训练流程独立于推理页,显存压力通常高于推理,建议 8GB 卡先跑通零样本推理。 |
启用半精度 is_half=true |
README Docker 节:is_half 控制是否开启 fp16,GPU 支持时设 true 减少显存占用。 |
| 切换 CPU 设备 | install.sh --device CPU / install.ps1 --Device CPU;README 实测环境表含 Python 3.9 + PyTorch 2.2.2 + CPU 组合(速度慢,README 标注 M4 CPU RTF 0.526 仅作参考)。 |
| 模型版本取舍 | README V2Pro Notes:v2Pro 显存占用略高于 v2;v3/v4/v5 为后续架构。8GB 卡若新版本 OOM,可回退 v1/v2/v2Pro 底模(具体显存门槛 README 未公布,以本机实测为准)。 |
4. 关键配置(目录与开关速查)
| 配置项 | 默认值 / 路径 | 说明 |
|---|---|---|
| 预训练模型目录 | GPT_SoVITS/pretrained_models |
README Pretrained Models 第 1 项 |
| G2PW 目录 | GPT_SoVITS/text/G2PWModel |
仅中文 TTS 需要,解压改名后放入 |
| UVR5 权重目录 | tools/uvr5/uvr5_weights |
可选;roformer 类模型须模型名与配置同名、文件名含 roformer(README 第 212 行规则) |
| ASR 模型目录 | tools/asr/models |
可选 |
数据集标注 .list 格式 |
vocal_path\|speaker_name\|language\|text |
README Dataset Format;语种字典 zh / ja / en / ko / yue;示例见表下注释 |
is_half |
GPU 支持时建议 true |
Docker 环境变量,控制 fp16 半精度 |
.list标注行示例(README Dataset Format 原文示例,字段以竖线分隔):
D:\GPT-SoVITS\xxx/xxx.wav|xxx|en|I like playing Genshin.
5. 启动(README「Open WebUI」节命令)
# 主 WebUI(训练 + 推理入口),language 为可选参数
python webui.py
# 指定语言:
python webui.py zh
# 切换 v1:
python webui.py v1
python webui.py v1 zh
独立推理 WebUI:
python GPT_SoVITS/inference_webui.py
# 或执行 python webui.py 后在界面内进入推理页
使用方法
启动方式
| 方式 | 命令 / 操作 | 适用 |
|---|---|---|
| 整合包(Windows) | 双击 go-webui.bat(独立推理:go-webui-v2.bat) |
方案 A |
| 主 WebUI(源码) | python webui.py [language(optional)] |
训练 + 推理一体化 |
| 独立推理 WebUI(源码) | python GPT_SoVITS/inference_webui.py [language(optional)];或主 WebUI 内进入 1-GPT-SoVITS-TTS / 1C-inference 标签页 |
仅合成语音 |
| UVR5 人声分离 WebUI(命令行) | python tools/uvr5/webui.py "<infer_device>" <is_half> <webui_port_uvr5> |
数据集预处理 |
| 数据集切片(命令行,README 原文) | python audio_slicer.py --input_path "<原音频路径或目录>" --output_root "<切片输出目录>" --threshold <音量阈值> --min_length <最小时长> --min_interval <相邻切片最短间隔> --hop_size <音量曲线步长> |
注意:当前 main 分支根目录未检索到该脚本(详见 04.6 第 7 条),切片优先在 WebUI 工具页完成 |
| 中文 ASR(命令行,README 原文) | python tools/asr/funasr_asr.py -i <输入> -o <输出> |
仅中文 |
| 非中文 ASR(命令行,README 原文) | python ./tools/asr/fasterwhisper_asr.py -i <输入> -o <输出> -l <language> -p <precision> |
英 / 日等 |
推理界面操作步骤(1-GPT-SoVITS-TTS / 1C-inference 页,README「Open Inference WebUI」节 + 官方 inference_webui.py 源码控件核对)
- 顶部「模型切换」下拉选择 GPT 模型与 SoVITS 模型,点「刷新模型路径」重载目录;首次使用选择整合包 / 底模默认模型即可。
- 「请上传并填写参考信息」区:上传 3–10 秒参考音频;在「参考音频的文本」框填写该音频的转写文本;「参考音频的语种」选对应语种。
- 「请填写需要合成的目标文本和语种模式」区:粘贴待合成文本;「需要合成的语种」选目标语种;「怎么切」选择长文本切分策略。
- 调整语速、句间停顿与 GPT 采样参数(参数表见下),点击「合成语音」,「输出的语音」播放器出现结果后可在线试听、下载。
参数说明表(来源:官方仓库 GPT_SoVITS/inference_webui.py Gradio 控件定义,行号对应源码)
| 界面控件 | 控件类型 / 取值范围 / 默认值 | 说明 |
|---|---|---|
| GPT 模型列表 | 下拉,自动枚举 GPT_SoVITS/pretrained_models 下可用 GPT 权重 |
切换 GPT 模型;支持刷新 |
| SoVITS 模型列表 | 下拉,自动枚举 SoVITS 权重 | 切换 SoVITS 模型;支持刷新 |
| 参考音频 | 音频上传,3–10 秒内(源码标签原文:「请上传3~10秒内参考音频,超过会报错!」) | 零样本音色来源;v3/v4 版本多参考音频融合入口被隐藏(源码 file_count=multiple 控件 visible=False) |
| 无参考文本模式 | 开关,默认关;v3 暂不支持,开启会报错(源码标签原文;v3/v4 版本控件禁用) | 开启后无视参考文本;建议搭配微调后的 GPT 使用 |
| 参考音频的文本 | 多行文本框,5 行上限 | 填写参考音频原话转写文本 |
| 参考音频的语种 | 下拉,默认「中文」;可选:中文(all_zh)、英文(en)、日文(all_ja)、粤语(all_yue)、韩文(all_ko)、中英混合(zh)、日英混合(ja)、粤英混合(yue)、韩英混合(ko)、多语种混合(auto)、多语种混合(粤语)(auto_yue)(v2 字典;v1 字典不含粤语 / 韩文相关项) |
参考音频语种识别模式 |
| CFG | 滑块 0–2,步长 0.05;v5dev 默认 1.30,其余默认 0.0;仅 v5 版本可见(源码 visible=model_version in V5_VERSIONS) |
CFG 引导强度 |
| 采样步数 | 单选 [4, 8, 16, 32];v5turbo 默认 4,v3 / v5dev 默认 32,其余默认 8;v3/v4 版本可见 |
源码标签:「采样步数,如果觉得电,提高试试,如果觉得慢,降低试试」 |
| v3 超分开关 | 复选框,默认关;仅 v3 版本可见 | 源码标签:「v3 输出如果觉得闷可以试试开超分」 |
| 需要合成的文本 | 多行文本框,26 行上限 | 待合成文本 |
| 需要合成的语种 | 下拉,默认「中文」;语种选项同上表;源码标签补充:「限制范围越小判别效果越好」 | 目标合成语种 |
| 怎么切 | 下拉,默认「凑四句一切」;可选:不切 / 凑四句一切 / 凑 50 字一切 / 按中文句号。切 / 按英文句号.切 / 按标点符号切 | 长文本分段策略 |
| 冻结上次结果 | 复选框,默认关 | 源码标签:「是否直接对上次合成结果调整语速和音色。防止随机性。」 |
| 语速 | 滑块 0.6–1.65,步长 0.05,默认 1 | 源码标签:「语速调整,高为更快」 |
| 句间停顿秒数 | 滑块 0.1–0.5,步长 0.01,默认 0.3 | 句与句之间停顿时长 |
| top_k | 滑块 1–100,步长 1,默认 15 | GPT 采样参数;源码提示「无参考文本时不要太低,不懂就用默认」 |
| top_p | 滑块 0–1,步长 0.05,默认 1 | GPT 核采样阈值 |
| temperature | 滑块 0–1,步长 0.05,默认 1 | 采样温度 |
| CUDA Graph 加速 | 复选框,默认 graph_available 判定结果,仅可用时显示 |
README V5 Notes:支持 cuda_graph 推理加速(感谢 @XXXXRT666 贡献) |
| flash_attn 加速 | 复选框,默认 flash_attn_supported 判定结果,仅支持时显示 |
README V5 Notes:支持 flash_attention 加速 |
| 输出的语音 | 音频播放器 | 合成结果试听 / 下载 |
微调训练流程(README「Finetune → Finetune」节,官方 WebUI 流程简述)
README 明确支持路径自动填充,顺序为:
- 填写音频路径;
- 将音频切片为小片段;
- 降噪(可选);
- ASR 自动转写;
- 人工校对 ASR 转写文本;
- 进入下一标签页,微调模型。
数据集标注格式见 04.4 配置表;训练所需 .list 三字段:音频路径|说话人名|语种|文本。
端到端示例:5 秒零样本合成一段中文博客口播
准备素材:一段 3–10 秒、单人、无背景音乐、口齿清晰的目标音色录音(ref.wav),用记事本写出其原话文字(例如「大家好,欢迎来到我的技术博客。」)。
操作步骤:
- 双击
go-webui.bat(整合包)或执行python GPT_SoVITS/inference_webui.py(源码),打开1-GPT-SoVITS-TTS / 1C-inference页。 - 上传
ref.wav;「参考音频的文本」粘贴原话;「参考音频的语种」选「中文」。 - 「需要合成的文本」粘贴口播稿,例如:
「今天这期视频,我们来聊一聊几个适合本地部署的开源语音项目,从语音克隆到实时对话,全部跑在自己的电脑上。」
- 「需要合成的语种」选「中文」;「怎么切」选「凑四句一切」;语速保持 1;top_k 15、top_p 1、temperature 1 保持默认。
- 点击「合成语音」,在输出播放器试听;相似度不满意时:核对参考文本是否准确、换更干净的 3–10 秒参考音频;情绪 / 音色仍不满足可走 04.5 微调流程,用约 1 分钟目标音色数据微调(README Few-shot TTS 说明)。
命令行备用入口(README 原文):UVR5 分离伴奏、音频切片、中文 FunASR 标注、非中文 faster-whisper 标注命令见 04.5「启动方式」表。
常见坑
| # | 现象 | 原因 | 解决(官方依据 / 实践处理) |
|---|---|---|---|
| 1 | 解压路径或素材路径含中文、空格、括号时,模型加载 / 音频读取报错或乱码 | 部分 Python 依赖与 Gradio 对非 ASCII 路径兼容性差(README 未单独成文,属实践高发问题) | 将整合包与项目克隆到纯英文短路径(如 D:\GPT-SoVITS、~/GPT-SoVITS);参考音频、训练素材同样使用英文路径;audio_slicer.py 等命令行参数中的路径加引号并避免中文。 |
| 2 | 首次启动长时间卡在模型下载,或 HF 连接超时 / 断流 | 官方默认源为 Hugging Face Hub,国内直连不稳定 | 一键脚本部署时 --Source HF-Mirror 或 --Source ModelScope(README 官方参数);手动部署先 export HF_ENDPOINT=https://hf-mirror.com 再启动;G2PW / ASR 模型使用 README 给出的 ModelScope 镜像链接;语雀国内下载页用于手动获取整合包。 |
| 3 | 推理或训练时显存不足(CUDA out of memory) | README 未公布各版本显存门槛;大模型 + 微调训练显存压力大 | 先跑通零样本推理;GPU 支持时开启半精度 is_half=true;换用更轻的 v1/v2/v2Pro 底模;极端情况 --device CPU 纯 CPU 运行(README 支持选项,速度慢)。8GB 3070 具体可跑版本需以本机实测为准,README 未给数值承诺。 |
| 4 | 参考音频上传后界面提示报错、合成异常 | 参考音频时长超过 10 秒(源码控件标签明确:「请上传3~10秒内参考音频,超过会报错!」) | 截取 3–10 秒单人清晰片段再上传;多参考音频融合功能在 v3/v4 版本源码中已隐藏,勿在这些版本上依赖多参考文件。 |
| 5 | v3 版本勾选「无参考文本模式」后报错 | 源码注明「v3 暂不支持该模式,使用了会报错」,且 v3/v4 版本该控件被禁用 | v3/v4 下填写准确参考文本;需要无参考文本模式时使用支持该模式的版本与微调 GPT(源码标签提示建议搭配微调 GPT)。 |
| 6 | Windows 启动提示缺少 ffmpeg.exe / ffprobe.exe,或音频处理环节报错 |
README Windows 手动安装节要求把两个 exe 放入项目根目录;README 未注明整合包是否内置,手动源码部署更可能需要自行补齐 | 按 README 链接下载 ffmpeg.exe、ffprobe.exe 放入项目根目录;同时安装 README 给出的 VS 2017 运行库;WSL2 内 sudo apt install ffmpeg libsox-dev。 |
| 7 | 执行 README 命令行切片命令 python audio_slicer.py 提示找不到文件 |
当前 main 分支根目录未检索到 audio_slicer.py(2026-10-25 对 404 候选路径逐一探测均为 404),README 命令路径可能滞后于代码重构 |
优先使用 WebUI 内的切片工具页完成数据集预处理;命令行切片可在仓库内 tools/ 目录下检索同名 / 近名脚本后再执行;脚本路径问题建议到官方 Issues 核对最新分支状态。 |
本节来源清单
| # | URL | 用途 | 验证方式(2026-10-25) |
|---|---|---|---|
| 1 | https://github.com/RVC-Boss/GPT-SoVITS | 官方仓库主页 | curl HTML 200(GitHub 主页对 web_fetch 启用 robots.txt 限制,改用 raw README + curl 核验) |
| 2 | https://raw.githubusercontent.com/RVC-Boss/GPT-SoVITS/main/README.md | 项目主 README(部署、模型目录、WebUI 命令、语种、环境表、各版本 Notes 的唯一事实来源) | curl 200 下载后全文精读(501 行) |
| 3 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/LICENSE | MIT 许可证原文 | curl raw LICENSE 200,开头 MIT License / Copyright (c) 2024 RVC-Boss 已核对 |
| 4 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/docs/cn/README.md | 中文 README(交叉核对) | curl raw 200(490 行) |
| 5 | https://www.yuque.com/baicaigongchang1145haoyuangong/ib3g1e | 官方简体中文用户指南 | curl 200 |
| 6 | https://rentry.co/GPT-SoVITS-guide#/ | 官方英文指南(README 徽章) | 链接来自 README 英文徽章;本环境 curl 000 网络受限未连通,待用户侧浏览器复核 |
| 7 | https://github.com/RVC-Boss/GPT-SoVITS/releases | GitHub Releases 页(最新标签 20250606v2pro,2025-06-06 03:04:27Z) | curl HTML 200,解析 datetime 标签核实发布时间 |
| 8 | https://huggingface.co/lj1995/GPT-SoVITS-windows-package | Windows 整合包官方 HF 仓库 | curl 200;HF API siblings 文件清单已核对;各 .7z 文件体积经 HEAD content-length 实测 |
| 9 | https://huggingface.co/lj1995/GPT-SoVITS-windows-package/resolve/main/GPT-SoVITS-v3lora-20250228.7z?download=true | README 正文当前整合包下载链接 | HEAD 200(302 → 200),content-length: 6754961256 字节 |
| 10 | https://huggingface.co/lj1995/GPT-SoVITS | 预训练底模官方 HF 仓库 | curl 200;tree API 递归统计全版本约 6.4 GB |
| 11 | https://huggingface.co/XXXXRT/GPT-SoVITS-Pretrained/resolve/main/G2PWModel.zip | G2PW 中文前端模型(HF) | HEAD 200,content-length: 588856634 字节 |
| 12 | https://www.modelscope.cn/models/XXXXRT/GPT-SoVITS-Pretrained/resolve/master/G2PWModel.zip | G2PW 模型(ModelScope 国内镜像) | curl 200 |
| 13 | https://huggingface.co/lj1995/VoiceConversionWebUI/tree/main/uvr5_weights | UVR5 人声分离权重目录 | curl 200;tree API 实测约 594.4 MB |
| 14 | https://huggingface.co/lj1995/VoiceConversionWebUI/blob/main/ffmpeg.exe | Windows 手动部署 FFmpeg 程序(README 链接) | 链接来自 README Install FFmpeg 节,未在本环境下载二进制核验 |
| 15 | https://modelscope.cn/models/damo/speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch/files | 中文 ASR 模型(FunASR / ModelScope) | curl 200 |
| 16 | https://modelscope.cn/models/damo/speech_fsmn_vad_zh-cn-16k-common-pytorch/files | 中文 VAD 模型 | curl 200 |
| 17 | https://modelscope.cn/models/damo/punc_ct-transformer_zh-cn-common-vocab272727-pytorch/files | 中文标点模型 | curl 200 |
| 18 | https://huggingface.co/Systran/faster-whisper-large-v3 | 英 / 日 ASR 备用模型 | curl 200 |
| 19 | https://lj1995-gpt-sovits-proplus.hf.space/ | 官方在线体验 Space(README 徽章) | curl 200 |
| 20 | https://colab.research.google.com/github/RVC-Boss/GPT-SoVITS/blob/main/Colab-WebUI.ipynb | 官方 Colab 训练 Notebook(README 徽章) | 链接来自 README Colab 徽章;本环境 curl 000 网络受限未连通,待用户侧复核 |
| 21 | https://www.codewithgpu.com/i/RVC-Boss/GPT-SoVITS/GPT-SoVITS-Official | 官方 AutoDL 云镜像入口(README「For users in China」) | curl 200 |
| 22 | https://hub.docker.com/r/xxxxrt666/gpt-sovits | 官方 Docker 镜像仓库(README Docker 节) | curl 200 |
| 23 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/install.sh | Linux 一键安装脚本参数(--device / --source / --download-uvr5) |
curl raw 200,print_help 选项与取值已逐行核对 |
| 24 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/install.ps1 | Windows PowerShell 安装脚本参数(--Device / --Source / --DownloadUVR5) |
curl raw 200,param(...) 校验集已核对 |
| 25 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/requirements.txt | 依赖版本约束(numpy<2.0、librosa==0.10.2、transformers>=4.51,<5 等) | curl raw 200,全文核对 |
| 26 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/GPT_SoVITS/inference_webui.py | 推理 WebUI 控件与参数默认值来源 | curl raw 200,1514 行,控件行号 1278–1444 已核对 |
| 27 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/tools/asr/funasr_asr.py | 中文 ASR 命令行入口 | curl raw 200 |
| 28 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/tools/asr/fasterwhisper_asr.py | 非中文 ASR 命令行入口 | curl raw 200 |
| 29 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/tools/uvr5/webui.py | UVR5 WebUI 命令行入口 | curl raw 200 |
| 30 | https://huggingface.co/docs/huggingface_hub/guides/environment-variables | HF_ENDPOINT 镜像环境变量机制说明(huggingface_hub 官方文档) |
curl 200 |
| 31 | https://github.com/RVC-Boss/GPT-SoVITS/blob/main/docs/en/Changelog_EN.md | 更新日志 | curl 200 |
| 32 | https://github.com/RVC-Boss/GPT-SoVITS.git | 源码部署 git clone 地址(04.4 方案 B) |
与 #1 同一仓库;curl HTML 200 |
| 33 | https://github.com/user-attachments/assets/8c2a0e0a-7212-4b77-b5ef-2d192e09127f | 04.2 节官方对比图原始地址(README 第 55 行 <img> 引用) |
curl 200 下载,file 校验 PNG 2400×1650、418,844 字节 |
| 34 | https://github.com/RVC-Boss/GPT-SoVITS/assets/129054828/05bee1fa-bdd8-4d85-9350-80c060ab47fb | 官方少样本微调演示视频(README「Unseen speakers few-shot fine-tuning demo」段,非图片素材) | 链接逐字摘自 README;视频资源,未纳入本节图集 |
| 35 | https://aka.ms/vs/17/release/vc_redist.x86.exe | Windows 2017 运行库(README Install FFmpeg → Windows Users 节链接) | 链接来自 README;微软官方下载地址,未在本环境下载安装包核验 |
| 36 | https://huggingface.co/lj1995/VoiceConversionWebUI/blob/main/ffprobe.exe | Windows 手动部署 FFprobe 程序(README Install FFmpeg 节链接) | 链接来自 README;未在本环境下载二进制核验 |
| 37 | https://www.yuque.com/baicaigongchang1145haoyuangong/ib3g1e/dkxgpiy9zb96hob4 | README 指引的国内整合包 / 模型下载语雀页面 | curl 200 |
| 38 | https://hf-mirror.com | HF 国内镜像站首页;HF_ENDPOINT=https://hf-mirror.com 镜像目标 |
首页 curl 200;模型文件解析在本环境超时(curl exit 28),镜像可用性以读者本地网络为准 |
待复核项:英文指南 rentry.co 链接、Colab Notebook 链接在本部署环境网络受限(curl 000),地址均逐字摘自官方 README 徽章,建议读者在国内浏览器 / Colab 环境内二次打开确认。