
Druid:超详细部署与使用教程
Druid 是阿里巴巴开源的高性能数据库连接池与 SQL 解析器,将 JDBC 连接池、SQL 解析分析、安全防护(SQL 防火墙)和监控统计深度整合为一体,是 Java 生态中功能最全面的数据库中间件之一,也是国内项目中最常用的连接池。
| 所属公司 | GitHub 仓库 | 官方文档/官网 | 开源协议 | Star 数 | 最新版本(截至 2026-10-27) | 主要语言 |
|---|---|---|---|---|---|---|
| 阿里巴巴(开源) | github.com/alibaba/druid | 仓库内 doc/ 文档 + Wiki:github.com/alibaba/druid/wiki |
Apache-2.0 | 约 28k | 1.2.28 | Java |
目录
一、项目概述
1.1 项目定位
Druid 不只是一个连接池。官方 README 对它的定位是「高性能数据库连接池和 SQL 解析器」,把四件事整合在一起:
- JDBC 连接池
DruidDataSource:高性能、可监控,支持物理连接预热、PSCache、KeepAlive 等高级特性; - SQL 解析器:支持 30 种 SQL 方言的完整解析,生成 AST 抽象语法树,支持 SQL 格式化、改写和分析;
- SQL 防火墙
WallFilter:基于 AST 拦截 SQL 注入、危险操作; - 监控统计
StatFilter:实时采集 SQL 执行统计、连接池状态,并提供内置 Web 监控页面。
因为自带监控和安全能力,Druid 在国内几乎成为 Java Web 项目「默认连接池」级别的存在。
1.2 核心功能
| 功能领域 | 说明 |
|---|---|
| JDBC 连接池 | DruidDataSource:高性能、可监控;支持物理连接预热、PSCache、KeepAlive |
| SQL 解析器 | 支持 30 种 SQL 方言,生成 AST,支持格式化、改写、分析 |
| SQL 防火墙 | 基于 AST 的 WallFilter,拦截 SQL 注入与危险操作 |
| 监控统计 | 内置 StatFilter 实时采集 SQL 统计、连接池状态,提供 Web 监控页面 |
| Filter 扩展 | 可插拔 Filter-Chain 架构,支持日志、加密、统计等扩展 |
| Spring Boot 集成 | 提供 Spring Boot 2.x / 3.x / 4.x 三个 Starter,开箱即用 |
| 高可用 | HighAvailableDataSource 支持多数据源负载均衡、健康检查与故障切换 |
SQL 方言覆盖(官方 README):MySQL、PostgreSQL、Oracle、SQL Server、DB2、H2、达梦(DM)、GaussDB、ClickHouse、Doris、StarRocks、Hive、Spark、Presto、Snowflake 等 30 种。
1.3 技术架构
Druid 官方文档(仓库 doc/architecture.md)给出的整体架构是四层:
Application Layer(Spring Boot / 直接 JDBC)
        │
DruidDataSource(JDBC 连接池核心):连接管理 / 锁与公平性 / KeepAlive 与回收线程
        │
Filter Chain(Stat → Wall → Log → Custom)
        │
SQL Parser Engine(Lexer → Parser → AST → Visitors,含 30 方言注册表)
- 连接池子系统:负责物理连接生命周期管理——获取(getConnection)、归还(recycle)、异步创建(CreateConnectionThread)、销毁(DestroyConnectionThread)、KeepAlive 心跳。
- Filter 链:每个 SQL 请求依次经过 StatFilter(统计)、WallFilter(安全)、LogFilter(日志)及自定义 Filter。
- SQL 解析引擎:Lexer 词法分析 → Parser 语法分析 → AST 抽象语法树 → Visitors(统计、抽取表/列、格式化)。

二、环境要求
| 项目 | 要求 |
|---|---|
| JDK | JDK 8 及以上(官方 README「从源码构建」要求 Java 8+) |
| 构建工具 | 源码构建需 Maven 3.6+ |
| Spring Boot | Starter 按版本选择:2.x → druid-spring-boot-starter;3.x → druid-spring-boot-3-starter;4.x → druid-spring-boot-4-starter |
| 数据库 | MySQL 5.x/8.x、PostgreSQL、Oracle 等任意 JDBC 数据源 |
| 监控页 | Web 容器即可(监控页是内嵌 Servlet,默认 /druid/*);JVM 内存建议按应用规模 |
| 端口 | 监控页复用 Web 应用端口(默认 http://应用IP:应用端口/druid/index.html) |
Druid 是「库」而非「独立服务」:它被打包进你的 Java 应用,没有独立部署的 Server 进程(
druid-admin是可选的集群监控汇总端,见 3.4)。
三、部署方式
Druid 的「部署」= 在 Java 项目中引入依赖并配置数据源。下面给出:Spring Boot 项目引入 Starter(推荐)→ 普通 Maven 项目直接使用 DruidDataSource → 源码构建 → Druid Admin 集群监控端。
3.1 方式一:Spring Boot 引入 Starter(推荐)
步骤 1:引入依赖(官方 README)
按 Spring Boot 版本选择 Starter(以 Spring Boot 3.x 为例):
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>druid-spring-boot-3-starter</artifactId>
    <version>1.2.28</version>
</dependency>
| Spring Boot 版本 | Starter 坐标 |
|---|---|
| 2.x | druid-spring-boot-starter |
| 3.x | druid-spring-boot-3-starter |
| 4.x | druid-spring-boot-4-starter |
步骤 2:配置 application.yml(官方 README 给出的示例)
spring:
  datasource:
    url: jdbc:mysql://localhost:3306/mydb
    username: root
    password: password
    druid:
      initial-size: 5
      max-active: 20
      min-idle: 5
      max-wait: 60000
      filter:
        stat:
          enabled: true
          log-slow-sql: true
          slow-sql-millis: 2000
        wall:
          enabled: true
常用连接池参数说明:
| 参数 | 说明 | 示例 |
|---|---|---|
initial-size |
启动时初始化的物理连接数 | 5 |
min-idle |
最小空闲连接数 | 5 |
max-active |
最大活跃连接数 | 20 |
max-wait |
获取连接最大等待时间(ms) | 60000 |
步骤 3:启用 Web 监控页面(官方 doc/monitoring-guide.md)
spring:
  datasource:
    druid:
      stat-view-servlet:
        enabled: true                  # 启用监控页面
        url-pattern: /druid/*          # 访问路径
        login-username: admin          # 登录用户名
        login-password: your_password  # 登录密码
        allow: 127.0.0.1               # IP 白名单(逗号分隔)
        reset-enable: false            # 是否允许重置统计数据
      web-stat-filter:
        enabled: true
        url-pattern: /*
        exclusions: "*.js,*.gif,*.jpg,*.png,*.css,*.ico,/druid/*"
        session-stat-enable: true
        session-stat-max-count: 1000
        profile-enable: true
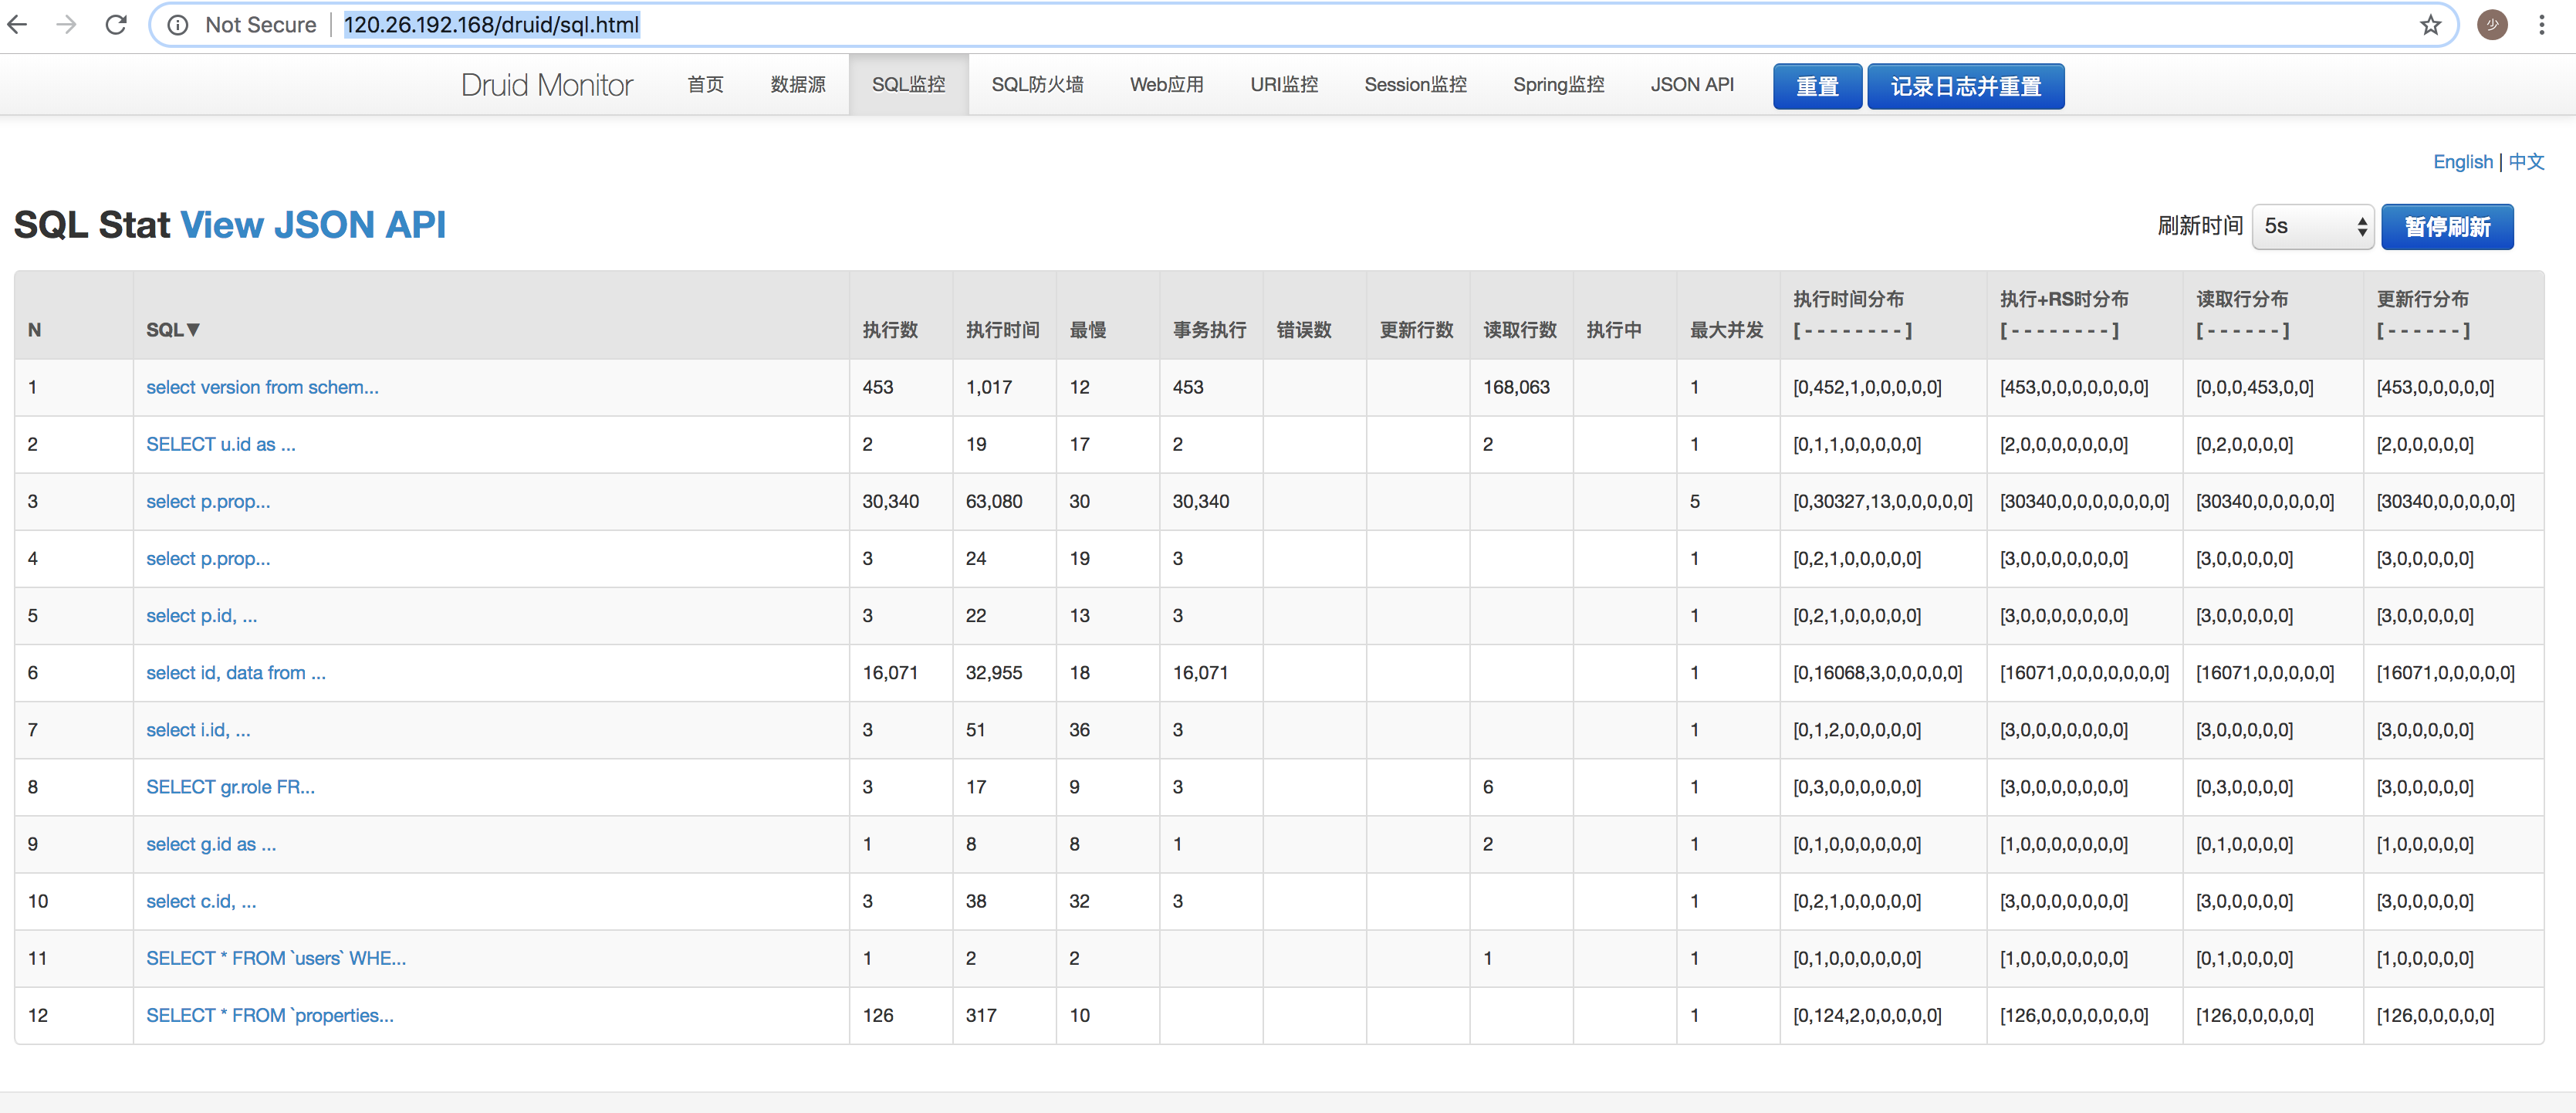
启动应用后访问 http://<应用IP>:<应用端口>/druid/index.html,用配置的账号密码登录,即可看到「数据源 / SQL 监控 / SQL 防火墙 / Web 应用 / URI 监控 / Session 监控」等页面。
3.2 方式二:普通 Maven 项目直接使用 DruidDataSource
步骤 1:引入核心依赖
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>druid</artifactId>
    <version>1.2.28</version>
</dependency>
步骤 2:代码方式创建数据源(官方 README 示例)
import com.alibaba.druid.pool.DruidDataSource;
import java.sql.Connection;

DruidDataSource dataSource = new DruidDataSource();
dataSource.setUrl("jdbc:mysql://localhost:3306/mydb");
dataSource.setUsername("root");
dataSource.setPassword("password");
dataSource.setInitialSize(5);
dataSource.setMaxActive(20);
dataSource.setMinIdle(5);
dataSource.init();

// 使用连接
try (Connection conn = dataSource.getConnection()) {
    // 执行 SQL
}
步骤 3:Servlet 容器中注册监控页(非 Spring Boot 场景)
在 web.xml 中注册 StatViewServlet:
<servlet>
    <servlet-name>DruidStatView</servlet-name>
    <servlet-class>com.alibaba.druid.support.http.StatViewServlet</servlet-class>
    <init-param>
        <param-name>loginUsername</param-name>
        <param-value>admin</param-value>
    </init-param>
    <init-param>
        <param-name>loginPassword</param-name>
        <param-value>your_password</param-value>
    </init-param>
</servlet>
<servlet-mapping>
    <servlet-name>DruidStatView</servlet-name>
    <url-pattern>/druid/*</url-pattern>
</servlet-mapping>
3.3 方式三:源码构建
git clone https://github.com/alibaba/druid.git
cd druid
mvn clean install
要求:Java 8+ JDK,Apache Maven 3.6+(官方 README)。
3.4 方式四:Druid Admin 集群监控汇总端(可选)
单节点时各应用的监控数据分散在各自 /druid/* 页面;druid-admin 模块从集群中各应用节点采集并汇总展示,通过注册中心(Nacos / Consul / Eureka 三选一)发现节点:
server:
  port: 19999

spring:
  cloud:
    nacos:
      discovery:
        enabled: true
        server-addr: localhost:8848

monitor:
  applications: app1,app2        # 需要监控的服务名
  login-username: admin
  login-password: your_password
启动:
mvn spring-boot:run -pl druid-admin
访问 http://localhost:19999/druid/sql.html 查看汇总监控。被监控应用需同时启用 StatFilter 与 StatViewServlet,并在同一注册中心注册。
3.5 验证部署成功(通用)
- 应用启动无报错,
DruidDataSource init日志出现初始化连接信息; - 访问
http://<应用IP>:<端口>/druid/index.html能用配置的账号登录; - 执行几次 SQL 后,「SQL 监控」页面能看到对应 SQL 执行次数、耗时、执行分布。
3.6 关键配置说明
| 配置项 | 说明 |
|---|---|
spring.datasource.druid.filter.stat.enabled |
开启 StatFilter 统计采集(监控前提) |
log-slow-sql / slow-sql-millis |
慢 SQL 记录与阈值(ms) |
spring.datasource.druid.stat-view-servlet.* |
监控页开关、路径、登录账号、IP 白名单 |
spring.datasource.druid.web-stat-filter.* |
Web 请求维度统计 |
四、使用方法
4.1 基础用法
引入 Starter 并配置好后,业务代码无感知——照常 @Autowired DataSource 或使用 JdbcTemplate / MyBatis,Druid 自动接管连接池、统计与安全。
4.2 常用 API
SQL 解析器(官方 README 示例)
import com.alibaba.druid.sql.SQLUtils;
import com.alibaba.druid.sql.ast.SQLStatement;
import com.alibaba.druid.stat.SchemaStatVisitor;
import com.alibaba.druid.util.JdbcConstants;

import java.util.List;

String sql = "SELECT id, name FROM users WHERE age > 18 ORDER BY name";
List<SQLStatement> stmts = SQLUtils.parseStatements(sql, JdbcConstants.MYSQL);

// 格式化 SQL
String formatted = SQLUtils.format(sql, JdbcConstants.MYSQL);

// 获取表/列信息
SchemaStatVisitor visitor = SQLUtils.createSchemaStatVisitor(JdbcConstants.MYSQL);
stmts.get(0).accept(visitor);
System.out.println("Tables: " + visitor.getTables());
System.out.println("Columns: " + visitor.getColumns());
监控页 JSON API
监控页除 HTML 外,还提供 JSON API(页面右上角有「JSON API」入口),便于把监控数据接入 Prometheus/Grafana 或自研告警。
4.3 进阶功能
- SQL 防火墙 WallFilter:
wall.enabled=true后可拦截 SQL 注入、多语句、危险 DDL;可按数据库类型配置白名单(官方doc/wall-security-guide.md)。 - 密码加密:
ConfigFilter/EncodingConvertFilter支持数据库密码加密存储,避免明文写在 yml。 - 多数据源/分库分表:
HighAvailableDataSource做读写分离与故障切换;Wiki 有「分库分表」专题。 - 连接泄漏检测:
removeAbandoned相关参数可回收未关闭的连接(配合removeAbandonedTimeout)。 - StatFilter 合并统计:
merge-sql=true将相同结构的 SQL 合并统计,监控页更清爽。
4.4 适用场景
- 任何 Java Web 项目替换默认连接池(DBCP / C3P0 / HikariCP 可换为 Druid);
- 需要 SQL 级监控(执行次数、慢 SQL、执行时间分布)的线上系统;
- 需要 SQL 注入防护的对外业务;
- 需要解析/改写 SQL 的中间件场景(分库分表、SQL 审计);
- 多数据源高可用切换。
五、常见问题排查(FAQ)
Q1:访问 /druid/index.html 404
- 原因:未启用 stat-view-servlet,或 url-pattern 被拦截器/Security 框架拦截。
- 解决:确认 spring.datasource.druid.stat-view-servlet.enabled=true;Spring Security 项目需放行 /druid/**。
Q2:监控页登录后看不到 SQL 数据
- 原因:未开启 StatFilter。
- 解决:spring.datasource.druid.filter.stat.enabled=true;确认数据源是由 Druid 接管(不是其他连接池)。
Q3:应用启动报 url 或 driverClassName 未识别(Spring Boot 3.x)
- 原因:用错 Starter——Spring Boot 3.x 需用 druid-spring-boot-3-starter,用 2.x starter 不会自动装配。
- 解决:按 Spring Boot 版本切换对应 starter。
Q4:org.apache.tomcat.jdbc.pool.PoolProperties 相关报错,或连接被莫名回收
- 原因:max-active / min-idle 与数据库 wait_timeout 不匹配,空闲连接被数据库侧断开。
- 解决:配置 test-while-idle=true、validation-query=SELECT 1、keep-alive=true,并让空闲检测间隔小于数据库 wait_timeout。
Q5:WallFilter 误杀正常 SQL
- 原因:防火墙规则过严,或某些框架拼接 SQL 触发拦截。
- 解决:查看 WallFilter 报错日志,在 wall 配置中按需放宽(官方 doc/wall-security-guide.md);不要直接关闭防火墙了事。
Q6:DruidAdmin 1.2.x 与历史 Wiki 中的 druid-spring-boot-starter 版本混乱
- 解决:以 Maven 中央仓库最新 1.2.28 为准;老项目从 1.1.x 升级时先看 Release 说明。
Q7:监控页暴露公网被扫描到
- 原因:生产环境 /druid/* 未加 IP 白名单或未改默认密码。
- 解决:配置 allow: 内网IP段;修改 login-username/password;直接在网关层屏蔽 /druid/** 对外访问。
六、部署注意事项与最佳实践
- 生产监控页必须加防护:设置强密码 + IP 白名单(
allow),不要把/druid/*暴露公网。 - starter 版本与 Spring Boot 对齐:3.x/4.x 用对应 starter,否则自动配置不生效。
- 连接池参数按容量压测定:
max-active不是越大越好,需与数据库最大连接数(max_connections)匹配,建议留有余量。 - 开启空闲连接保活:
test-while-idle+validation-query+keep-alive,避免拿到被数据库断开的死连接。 - 慢 SQL 阈值合理:
slow-sql-millis按业务 RT 定(如 2000ms),定期清理慢 SQL。 - 密码不要明文:用
ConfigFilter加密数据库密码,配置密文。 - StatFilter 生产保留:它是监控与慢 SQL 采集的来源,开销很小,不要为了性能关掉。
- 版本升级看 Release 说明:Druid 修复过多次连接池与 SQL 解析安全问题,及时升到 1.2.28+。
七、参考资料
- GitHub 仓库:https://github.com/alibaba/druid
- 架构概览(仓库 doc):https://github.com/alibaba/druid/blob/master/doc/architecture.md
- 连接池指南:https://github.com/alibaba/druid/blob/master/doc/connection-pool-guide.md
- SQL 解析器指南:https://github.com/alibaba/druid/blob/master/doc/sql-parser-guide.md
- SQL 防火墙指南:https://github.com/alibaba/druid/blob/master/doc/wall-security-guide.md
- 监控统计指南:https://github.com/alibaba/druid/blob/master/doc/monitoring-guide.md
- 高可用数据源:https://github.com/alibaba/druid/blob/master/doc/ha-datasource.md
- Spring Boot Starter 说明:https://github.com/alibaba/druid/tree/master/druid-spring-boot-starter
- Wiki(中文):https://github.com/alibaba/druid/wiki/常见问题
- Release 下载:https://github.com/alibaba/druid/releases
- Maven 中央仓库:https://search.maven.org/artifact/com.alibaba/druid