

CogVideo · 智谱开源视频生成模型家族(CogVideoX 系列 + 原版 CogVideo)· 中文部署与使用全指南
项目仓库: https://github.com/THUDM/CogVideo
开源协议:仓库代码 Apache 2.0;CogVideoX-2B 模型(Transformer 与
VAE)Apache 2.0;CogVideoX-5B 系列(Transformer,含 T2V 与 I2V)按 CogVideoX
License 分发 · 开发语言:Python(PyTorch / Diffusers / SAT
SwissArmyTransformer / Gradio) · 论文:CogVideoX arXiv:2408.06072;原版
CogVideo ICLR'23 arXiv:2205.15868 ·
环境:Python 3.10–3.12(含 3.10 与 3.12,SAT 与 Diffusers 路径口径一致)
· WebUI:Gradio(默认 7860 端口) · 模型权重:Hugging Face
/ ModelScope / WiseModel 三站同步 · 输入:英文文本提示词(CogVideoX
系列);原版 CogVideo 分支仅支持简体中文输入
1 项目简介
CogVideo 仓库由清华大学知识工程实验室(THUDM)与智谱 AI 维护,仓库内同时包含两代、多版本视频生成模型,部署前必须先区分清楚,避免混用权重、依赖与命令:
- 主分支(
main):CogVideoX 系列 —— 起源于商用模型"清影(QingYing)"的开源版本,覆盖 CogVideoX-2B、CogVideoX-5B、CogVideoX-5B-I2V、CogVideoX1.5-5B、CogVideoX1.5-5B-I2V,支持文生视频(T2V)、图生视频(I2V)与视频续写(V2V)三类任务;提供 Diffusers 与 SAT 两套权重格式,配套 CLI、Gradio 演示、量化推理与 LoRA 微调示例。提示词仅支持英文。 CogVideo分支:原版 CogVideo —— ICLR'23 论文 CogVideo: Large-scale Pretraining for Text-to-Video Generation via Transformers 的官方实现,是较早的大规模 Transformer 文生视频模型,仅支持简体中文输入,基于老旧 SAT 流水线与 A100 级硬件;本文在第 7.6 节单独说明,不作为 CogVideoX 的部署路径。
CogVideoX 的核心结构包含:专家 Transformer(3D 注意力)、3D 因果 VAE(近无损视频重建)、T5 文本编码器、DDIM / DPM 噪声调度器与动态 CFG 引导;CogVideoX1.5 把帧数提升到 16N+1、时长扩展到 5 秒或 10 秒,并把分辨率提升到 1360×768。
非官方声明:本文依据主分支 README、
requirements.txt、inference/cli_demo.py、inference/cli_demo_quantization.py、inference/convert_demo.py、inference/gradio_composite_demo/app.py、sat/README.md、finetune/README.md、tools/说明文件以及CogVideo分支 README 整理;模型为学术研究向开源成果,官方未承诺打包好的在线服务 SLA,效果、稳定性与硬件表现以仓库最新版本为准。README 在线演示标注"仅供学术研究与体验使用(This demo is for academic research and experiential use only)"。
1.1 核心信息一览
| 项目项 | 内容 |
|---|---|
| 项目名称 | CogVideo(仓库内分 CogVideoX 主系列与原版 CogVideo 分支) |
| 仓库地址 | github.com/THUDM/CogVideo |
| 项目定位 | 开源视频生成模型家族:文生视频、图生视频、视频续写 |
| 代码协议 | Apache 2.0(根目录 LICENSE) |
| 模型协议分档 | CogVideoX-2B(含 Transformer、VAE)Apache 2.0;CogVideoX-5B 系列(Transformer,T2V / I2V)CogVideoX License(学术免费、商用需登记授权,详见第 11 章) |
| 论文 / 出处 | CogVideoX:arXiv:2408.06072;原版 CogVideo:arXiv:2205.15868,ICLR'23 |
| 开发语言 / 框架 | Python 3.10–3.12、PyTorch、Diffusers、Transformers、SwissArmyTransformer(SAT)、Gradio、accelerate、moviepy、imageio |
| 任务类型 | T2V 文生视频;I2V 图生视频;V2V 视频续写(CogVideoX-5B / 2B / 1.5-5B 支持三类;I2V 专用模型为 5B-I2V 与 1.5-5B-I2V) |
| 输入 | 英文提示词(CogVideoX);原版分支仅简体中文;I2V 另需参考图,V2V 另需参考视频 |
| 输出 | MP4 视频(CLI 默认 ./output.mp4;Gradio 演示另提供 GIF
下载) |
| 部署方式 | Diffusers CLI 推理;官方 Gradio 应用;SAT 权重推理;INT8 / FP8 量化推理;LoRA 微调(Diffusers 与 SAT 两套方案) |
| WebUI 端口 | Gradio 默认
7860(inference/gradio_composite_demo 元信息
app_port: 7860,demo.launch() 默认端口) |
| 模型权重渠道 | Hugging Face、ModelScope、WiseModel 三站同步;SAT 权重另设独立仓库与清华云盘渠道(见第 4 章) |
| 系统入口 | WebUI:python app.py(inference/gradio_composite_demo);CLI:python inference/cli_demo.py ...;SAT:bash inference.sh |
1.2 适用场景
- 在本地或自有服务器复现开源文生视频流水线,按提示词生成 6 秒(2B / 5B / 5B-I2V)或 5–10 秒(1.5-5B / 1.5-5B-I2V)短视频片段。
- 以一张参考图为背景输入生成图生视频,或对现有视频做续写、重绘(V2V),用于分镜预览、概念短片与教学演示素材研究。
- 在显存有限的机器上通过 Diffusers 内存优化、INT8 权重量化跑通 2B / 5B 模型;H100 及以上设备可按官方说明启用 FP8 推理。
- 基于 Diffusers 版权重做 LoRA
微调,把模型适配到特定画风、场景或角色(微调硬件门槛见第 7.7 节与
finetune/README.md)。 - 研究 3D 因果 VAE、专家 Transformer、动态 CFG、位置编码(3D RoPE / 3D 正弦余弦)等视频扩散模型结构,或把 pipeline 接入 ComfyUI、视频生成基础设施等第三方生态(官方 Friendly Links 列出社区适配)。
- 复现 ICLR'23 原版 CogVideo 的中文文生视频实验(仅限
CogVideo分支,需独立环境与较大显存)。
1.3 能力边界(官方口径)
- 提示词语言:README Data Explanation 明确 CogVideoX
模型仅支持英文输入;其他语言需先用大模型翻译并润色为英文再输入(
inference/convert_demo.py即为此设计)。原版 CogVideo 分支相反,仅支持简体中文。 - 分辨率与帧数硬约束:帧数必须满足格式要求 —— 1.5 系列为 16N+1(N ≤ 10,默认 81 帧);2B / 5B / 5B-I2V 为 8N+1(N ≤ 6,默认 49 帧)。除 1.5-5B-I2V 支持自定义宽高外,其他模型不支持自定义分辨率,脚本会回落到推荐分辨率。
- 训练精度建议:CogVideoX-2B 以 FP16 训练,5B 系列以 BF16 训练;README 建议推理使用与训练一致的精度。
- 量化边界:仅 Diffusers 版权重支持量化;INT8
会降低推理速度以换取显存下降,视频质量损失很小;INT4
不支持;FP8 必须在 NVIDIA H100 及以上设备使用,需要源码安装
torch、torchao,推荐 CUDA 12.4。 - 硬件测试范围:Diffusers 内存优化方案仅在 NVIDIA
A100 / H100 架构上完成实测;README 称通常可适配所有 NVIDIA Ampere
架构及以上设备。关闭优化后显存峰值约为表内数值的 3 倍,但速度可提升约
3–4 倍;多 GPU 推理必须关闭
enable_sequential_cpu_offload()。 - 商用边界:5B 系列模型受 CogVideoX License 约束,学术研究免费,商用须登记基础授权并有访问量上限;2B 模型为 Apache 2.0(详见第 11 章)。
- 官方未在 README 公布最低 CPU 核数、磁盘 IO 与内存硬性下限;除显存表内数值外,本文未补充臆造硬件参数。
2 功能特性
2.1 三类视频任务
- 文生视频(T2V):
CogVideoXPipeline,输入英文提示词与负面引导参数,直接生成视频片段。 - 图生视频(I2V):
CogVideoXImageToVideoPipeline,以一张图片作为背景 / 首帧输入,结合提示词生成视频;专用模型为 CogVideoX-5B-I2V 与 CogVideoX1.5-5B-I2V。 - 视频续写(V2V):
CogVideoXVideoToVideoPipeline,输入一段参考视频与提示词,在其上做续写或风格重绘;2B、5B、1.5-5B 主模型支持。
2.2 多代模型与精度体系
- CogVideoX-2B:2024-08-06 发布,FP16 训练,720×480、49 帧、6 秒、8fps,显存门槛最低(Diffusers FP16 最低 4GB 起),README 称可在 GTX 1080Ti 等较老显卡上运行。
- CogVideoX-5B:2024-08-27 发布,BF16 训练,720×480、49 帧、6 秒、8fps,README 称可在 RTX 3060 级桌面显卡上运行。
- CogVideoX-5B-I2V:2024-09-19 发布,图生视频专用,BF16,同 5B 分辨率与帧数体系。
- CogVideoX1.5-5B / 1.5-5B-I2V:2024-11-08 发布,BF16
推荐,1360×768、81 帧(可扩至 161 帧)、5 秒或 10 秒、16fps;I2V
支持任意合规分辨率(
min(W,H)=768,768 ≤ max(W,H) ≤ 1360,长边被 16 整除)。 - CogVideoX1.5 双格式:SAT 代码已更新,Diffusers 版本 2024-11-15 随代码开放,沿用前序代码仅需少量参数调整。
2.3 3D 因果 VAE 与位置编码
- 2024-08-06 同步开源用于 CogVideoX-2B 的 3D Causal VAE,官方称可近无损重建视频。
- 位置编码方案按代际区分:2B 使用
3d_sincos_pos_embed;5B 与 5B-I2V 使用3d_rope_pos_embed(5B-I2V 另加learnable_pos_embed);1.5 系列使用3d_rope_pos_embed。
2.4 调度器与动态引导
- 内置
CogVideoXDPMScheduler与CogVideoXDDIMScheduler;cli_demo.py注释建议:2B 使用 DDIM 调度器,5B / 5B-I2V 使用 DPM 调度器。 - DPM 调度器配合
use_dynamic_cfg=True;DDIM 调度器应设use_dynamic_cfg=False。 - 2025-02-28 更新:
inference/ddim_inversion.py在 CogVideoX-5B 与 CogVideoX1.5-5B 上支持 DDIM Inverse,可基于参考视频做重建式生成;脚本注释说明该路径基于 5B 模型,2B 变体效果不佳。
2.5 量化与显存优化
- 内存优化开关:
enable_sequential_cpu_offload()、vae.enable_slicing()、vae.enable_tiling(),CLI 演示默认全部开启;显存充足或多 GPU 时可改为enable_model_cpu_offload()或直接.to("cuda")提速。 - INT8 权重量化:基于 PyTorchAO(TorchAO)与 Optimum-quanto,可对文本编码器、Transformer、VAE 量化;README 给出 2B INT8 最低 3.6GB、5B INT8 最低 4.4GB、1.5 系列 INT8 最低 7GB 的口径。
- FP8 量化:仅 H100
及以上,
cli_demo_quantization.py提供int8/fp8方案;TorchAO 量化与torch.compile完全兼容,编译后可进一步提速。
2.6 提示词工程与微调
- LLM 提示词润色:
convert_demo.py调用 GLM-4-Plus(T2V)或 GPT-4o(I2V 视觉)把短句扩写为符合模型训练分布的长描述;模型在长文本上训练,优质提示词直接影响成片质量。 - LoRA 微调:
finetune/README.md提供 Diffusers 版 CogVideoX LoRA 与全参数微调方案;2025-01-08 更新的 Diffusers 版 LoRA 代码显存占用更低。SAT 版微调在sat/README.md中说明,支持 LoRA 与全参数两种方式,仅微调 Transformer,不修改 VAE、T5 仅作编码器。 - 官方新框架:2025-03-24 发布 CogKit,面向 CogView4 与 CogVideoX 系列的微调与推理框架;README 建议后续微调工作迁移到 CogKit 维护。
2.7 演示后处理能力
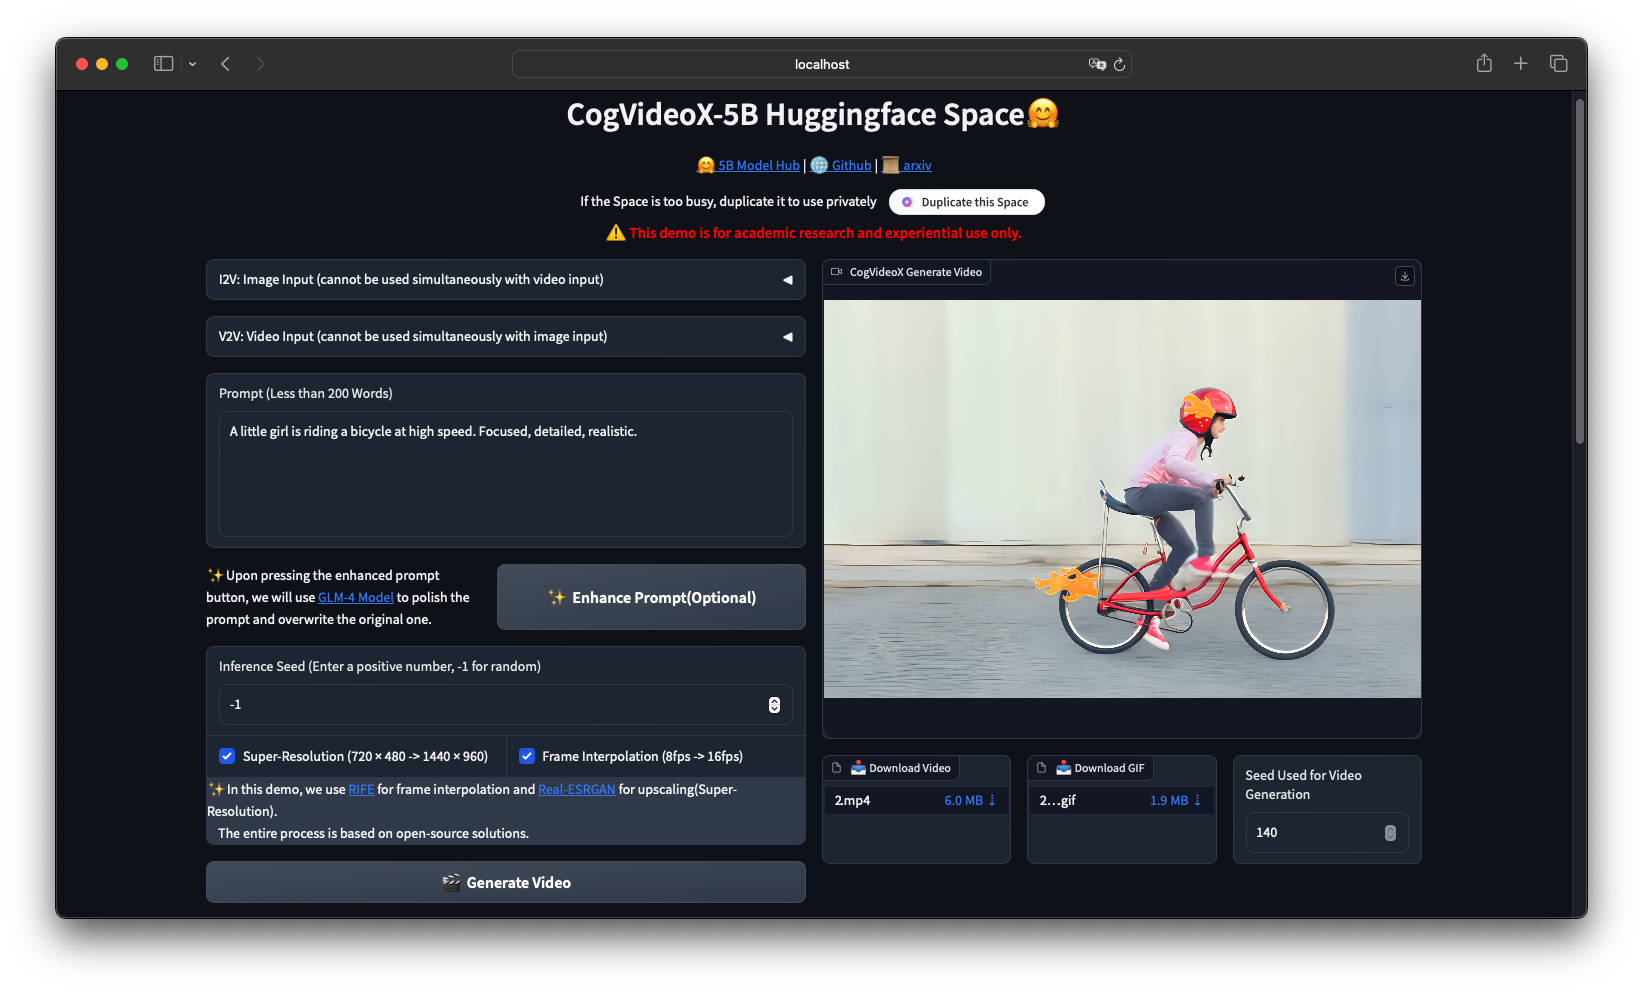
官方 Gradio 演示集成 RIFE 帧插值(8fps → 16fps)与 Real-ESRGAN 超分辨率(720×480 → 2880×1920),均为开源方案;演示同时提供视频与 GIF 下载。
3 官方界面预览
图 2 为仓库 resources/logo.svg
官方标识,按发布规程由 SVG 转换为静态 PNG 上传。
图 4 为 README"CogVideoX-5B Gallery"官方演示视频的代表性静态帧;原视频为 6 秒、49 帧、8fps 生成片段,本地 CLI 与 WebUI 生成结果以实际运行为准。
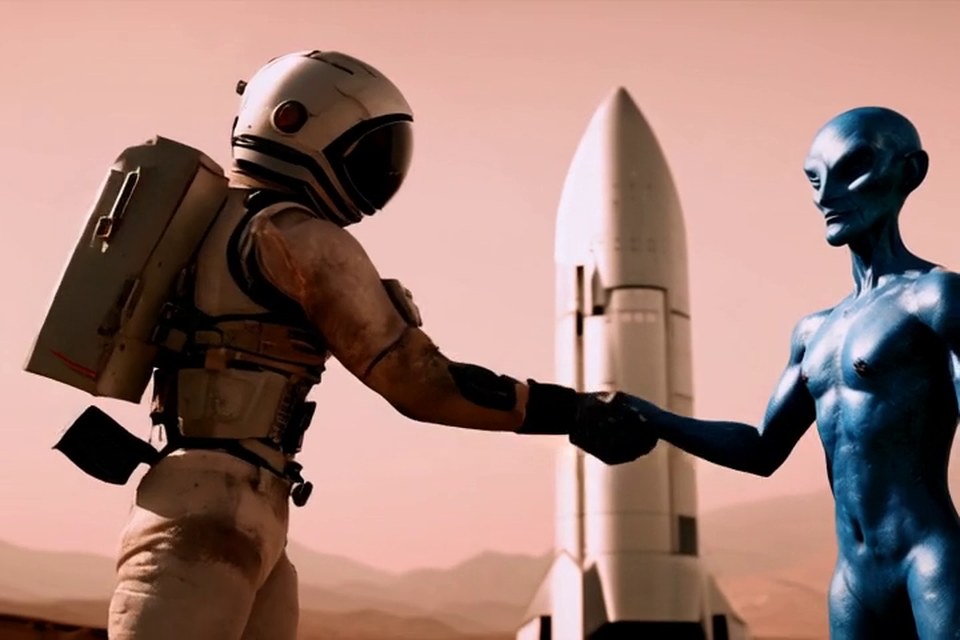
图 5 为另一组 CogVideoX-5B 官方演示帧:花园喷泉、花丛蝴蝶与木椅场景,对应画廊中长提示词引导的环境镜头。
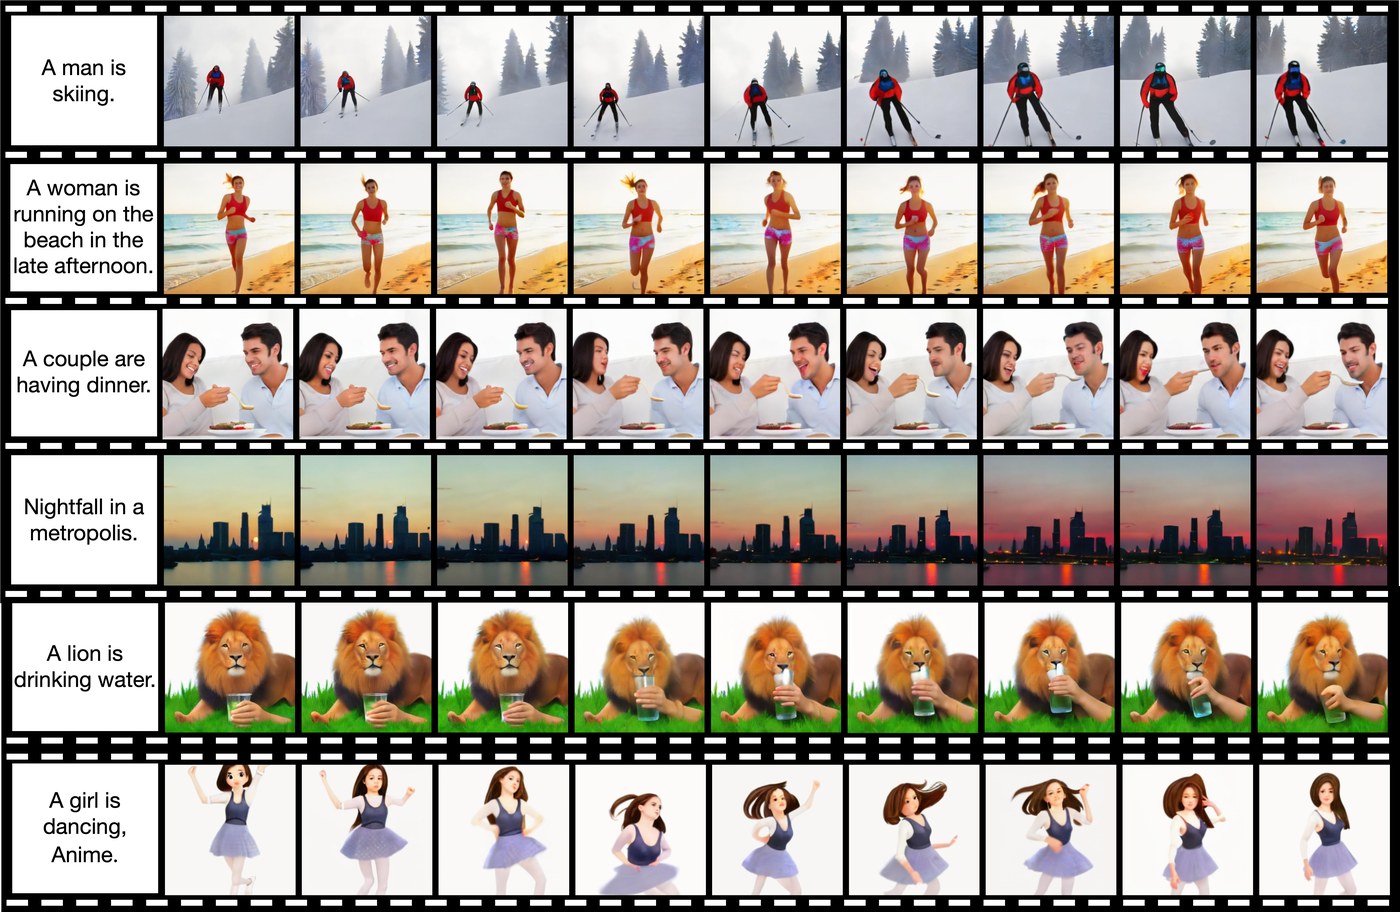
图 3 为 CogVideo 分支 README 中的原版 CogVideo
样片胶片条,展示滑雪、海边跑步、双人晚餐、城市暮色、狮子饮水、动漫女孩等提示词对应的帧序列;该分支为
ICLR'23 老旧流水线,与主分支 CogVideoX
模型不通用,仅供版本对照参考。
说明:README 主画廊素材均为 MP4 演示视频,按发布规程抽取代表性静态帧转为 JPEG 后上传;视频中的连贯运动、镜头节奏与过渡效果需在本地运行
cli_demo.py或 Gradio 演示查看。
4 官方跳转链接汇总
下表列出项目官方入口与社区集成入口;仓库、论文、模型卡、官方 Space 与文档为官方来源,第三方适配框架与教程属于社区维护资源。
| 类别 | 链接 | 说明 |
|---|---|---|
| 仓库主页 | github.com/THUDM/CogVideo | 主分支 CogVideoX 代码、CLI、Gradio 演示、微调与工具脚本 |
| 中文 README | README_zh.md | 仓库中文说明 |
| CogVideoX 论文 | arxiv.org/abs/2408.06072 | CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer |
| 原版 CogVideo 论文 | arxiv.org/abs/2205.15868 | ICLR'23 原版 CogVideo 论文 |
| 用户指南(飞书) | zhipu-ai.feishu.cn/wiki/DHCjw1TrJiTyeukfc9RceoSRnCh | 官方使用指南文档站 |
| 在线 Demo(HF Space · 5B T2V) | huggingface.co/spaces/THUDM/CogVideoX-5B | 官方 5B 在线体验 |
| 在线 Demo(HF Space · 5B Space) | huggingface.co/spaces/THUDM/CogVideoX-5B-Space | 含 I2V 的官方演示 Space |
| 在线 Demo(ModelScope) | modelscope.cn/studios/ZhipuAI/CogVideoX-5b-demo | 国内模型空间在线体验 |
| 模型卡 · CogVideoX1.5-5B | HF / ModelScope / WiseModel | 1.5 文生视频 Diffusers 权重 |
| 模型卡 · CogVideoX1.5-5B-I2V | HF / ModelScope / WiseModel | 1.5 图生视频 Diffusers 权重 |
| 模型卡 · CogVideoX-2B | HF / ModelScope / WiseModel | 2B 文生视频 Diffusers 权重(Apache 2.0) |
| 模型卡 · CogVideoX-5B | HF / ModelScope / WiseModel | 5B 文生视频 Diffusers 权重(CogVideoX License) |
| 模型卡 · CogVideoX-5B-I2V | HF / ModelScope / WiseModel | 5B 图生视频 Diffusers 权重(CogVideoX License) |
| SAT 权重 · 1.5-5B | HF THUDM/CogVideoX1.5-5b-SAT / ModelScope / WiseModel | SAT 格式 Transformer、VAE、T5 编码器 |
| 原版 CogVideo 分支 | github.com/THUDM/CogVideo/tree/CogVideo | ICLR'23 原版代码与中文流水线 |
| Issues 反馈 | github.com/THUDM/CogVideo/issues | Bug 反馈与问题讨论 |
| 社区群 | Discord /
resources/WECHAT.md |
官方 Discord 与微信群入口 |
| 商用大模型入口 | 清影 QingYing / 开放平台 API | 更大规模商用视频模型与 API(非开源权重) |
| 微调新框架 CogKit | github.com/THUDM/CogKit | CogView4 / CogVideoX 微调与推理框架(官方 2025-03 推荐迁移) |
| ComfyUI 集成(社区) | github.com/kijai/ComfyUI-CogVideoXWrapper | ComfyUI 工作流节点 |
| CogVideoX-Fun(社区) | github.com/aigc-apps/CogVideoX-Fun | 支持灵活分辨率与多种启动方式的改造流水线 |
| CogStudio(社区) | github.com/pinokiofactory/cogstudio | 独立维护的 CogVideo Gradio WebUI |
| 低成本微调(社区) | github.com/a-r-r-o-w/cogvideox-factory | 单张 4090 可微调 5B 的框架 |
| Colab 示例(社区维护) | 5B T2V / 5B T2V INT8 / 5B I2V / 5B V2V | 免费 T4 实例演示 Notebook |
| 仓库代码许可证 | LICENSE | Apache 2.0 |
| 5B 模型许可证 | THUDM/CogVideoX-5b/LICENSE | CogVideoX License |
5 前置要求与服务器配置
5.1 软件前提
主分支 CogVideoX(Diffusers 路径):
- Python:官方明确要求版本在 3.10 到 3.12 之间(含两端)。
- GPU 驱动与 CUDA:推荐 NVIDIA Ampere 架构及以上;FP8
路径需要 H100 及以上与 CUDA 12.4、源码安装
torch与torchao。 - 根目录
requirements.txt主要锁定口径(版本下限以仓库最新文件为准):
diffusers>=0.35.2
accelerate>=1.11.0
transformers>=4.57.1
numpy==1.26.0
torch>=2.8.0
torchvision>=0.23.0
sentencepiece>=0.2.1
SwissArmyTransformer>=0.4.12
gradio>=5.49.1
imageio>=2.37.0
imageio-ffmpeg>=0.6.0
openai>=2.2.0
moviepy>=2.2.1
scikit-video>=1.1.11
pydantic>=2.12.0- 视频写出依赖:
imageio、imageio-ffmpeg、moviepy、scikit-video;系统ffmpeg可执行文件建议加入PATH。 - 可选 LLM 润色:
openai客户端;配置OPENAI_API_KEY与OPENAI_BASE_URL后,Gradio"Enhance Prompt"按钮与convert_demo.py才会真正调用外部大模型,不配置时直接返回原始提示词。 - 量化可选依赖:
torchao(INT8 / FP8),按cli_demo_quantization.py注释需从源码安装;FP8 仅限 H100+。
Gradio
演示独立依赖(inference/gradio_composite_demo/requirements.txt):
该目录另有一份面向 Space
的依赖清单(diffusers>=0.31.0、transformers>=4.44.0、accelerate>=0.34.2、torch>=2.5.0、gradio>=5.4.0、opencv-python>=4.10.0.84、spandrel、pillow==9.5.0
等),本地部署时可直接在该目录按其清单安装,避免与根目录口径互相覆盖。
SAT 路径(sat/requirements.txt):
SwissArmyTransformer>=0.4.12、omegaconf>=2.3.0、pytorch_lightning>=2.4.0、kornia>=0.7.3、beartype>=0.19.0、fsspec>=2024.2.0、safetensors>=0.4.5、scipy>=1.14.1、decord>=0.6.0、wandb>=0.18.5、deepspeed>=0.15.3;建议与
Diffusers 路径使用独立虚拟环境。
5.2 硬件建议(README 官方显存表)
下表为 README Model Introduction 公布的官方口径;Diffusers 列已计入库内内存优化,SAT 列为全量加载口径。
| 模型 | SAT 精度 / 显存 | Diffusers 精度 / 最低显存 | Diffusers INT8(TorchAO) | 多 GPU 显存(Diffusers) | 官方推理速度(50 步,FP/BF16) |
|---|---|---|---|---|---|
| CogVideoX1.5-5B | BF16:76 GB | BF16:10 GB 起 | INT8:7 GB 起 | BF16:24 GB | 单 A100 约 1000 秒(5 秒视频);单 H100 约 550 秒 |
| CogVideoX1.5-5B-I2V | BF16:76 GB | BF16:10 GB 起 | INT8:7 GB 起 | BF16:24 GB | 同上 |
| CogVideoX-2B | FP16:18 GB | FP16:4 GB 起 | INT8:3.6 GB 起 | FP16:10 GB | 单 A100 约 90 秒;单 H100 约 45 秒 |
| CogVideoX-5B | BF16:26 GB | BF16:5 GB 起 | INT8:4.4 GB 起 | BF16:15 GB | 单 A100 约 180 秒;单 H100 约 90 秒 |
| CogVideoX-5B-I2V | BF16:26 GB | BF16:5 GB 起 | INT8:4.4 GB 起 | BF16:15 GB | 同上 |
补充口径(README Data Explanation):
- 关闭内存优化后显存峰值约为表内数值的 3 倍,速度提升约 3–4
倍,可按显存余量取舍;多 GPU 推理必须关闭
enable_sequential_cpu_offload()。 - INT8 会显著拖慢推理,用于小显存设备换取可运行性,视频质量损失很小;INT4 不被支持。
- 2B 以 FP16 训练、5B 系列以 BF16 训练,建议推理沿用训练精度。
- 原版 CogVideo 分支官方建议 A100 显卡;显存不足时可减小
--max-inference-batch-size与--batch-size,详见第 7.6 节。
5.3 端口分配
| 端口 | 服务 | 默认绑定 | 用途 |
|---|---|---|---|
| 7860 | Gradio WebUI | Gradio 默认本机 / 局域网 | 浏览器访问 inference/gradio_composite_demo
演示界面 |
远程服务器运行 WebUI 时,建议通过 SSH 隧道或带鉴权的反向代理访问 7860 端口,不要把界面不加鉴权地直接暴露到不可信公网;Gradio 演示会清理 10 分钟前的临时文件(
delete_old_files后台任务),临时目录由GRADIO_TEMP_DIR指定。
5.4 模型与磁盘规划
| 目录 / 位置 | 用途 |
|---|---|
Hugging Face 默认缓存(~/.cache/huggingface) |
from_pretrained 自动下载的 Diffusers 权重、文本编码器与
VAE |
| 手动模型目录 | 多模型并存时可通过 --model_path 指向本地文件夹 |
| SAT 权重目录 | Transformer 检查点、3D VAE 权重、T5 编码器(结构见第 8.5 节) |
output.mp4 / 自定义 --output_path |
CLI 生成视频输出位置 |
samples/、Gradio 临时目录 |
WebUI 生成视频、GIF 与中间帧缓存 |
各模型权重体积较大,建议预留数十 GB 可用磁盘;首次运行会按所选模型自动拉取权重,网络受限时改用 ModelScope 镜像或手动下载(见第 7.2 节)。
6 方式一:官方 Gradio 演示应用启动(本地推荐路径)
容器化现状(如实说明):主分支 CogVideoX 仓库未随附官方 Dockerfile 与
docker-compose.yml,本章不编造 Compose 文件。官方本地最简路径是inference/gradio_composite_demo内的 Gradio 应用;仅CogVideo原版分支保留历史 Docker 脚本,属于 ICLR'23 遗留流水线,不适用于 CogVideoX(见第 7.6 节)。
6.1 环境准备
git clone https://github.com/THUDM/CogVideo.git
cd CogVideo/inference/gradio_composite_demo

# 建议创建独立虚拟环境(Python 3.10–3.12)
pip install -r requirements.txt
6.2 配置可选环境变量
Gradio 演示用到的环境变量(README 与 app.py 口径):
| 变量 | 是否必填 | 说明 |
|---|---|---|
OPENAI_API_KEY |
否 | 配置后"Enhance Prompt"按钮才会调用大模型润色提示词;未设置时
convert_prompt 直接返回原提示词 |
OPENAI_BASE_URL |
否 | 兼容 OpenAI 协议的接口地址;OpenAI()
客户端按标准环境变量读取 |
GRADIO_TEMP_DIR |
否 | Gradio 临时文件目录,建议显式指定到有足够磁盘空间的位置 |
不要把 API Key 写进提示词、截图或文章;服务端只在运行进程环境中读取。
6.3 启动应用
python app.pyapp.py 启动时默认加载
MODEL = "THUDM/CogVideoX-5b",依次构建 T2V、V2V、I2V 三条
pipeline;首次运行自动从 Hugging Face
下载权重,耗时与网速相关。浏览器打开 Gradio 默认地址(通常
http://127.0.0.1:7860),远程访问按第 5.3
节做端口映射或隧道。
6.4 界面常用操作(app.py
口径)
- I2V 图生视频:上传图片,自动裁剪为 720×480;与 V2V 输入互斥,不可同时使用。
- V2V 视频续写:上传视频,脚本截取前 49 帧(6
秒、8fps);Strength 滑块范围
0.1–1.0,默认0.8。 - Prompt:少于 200 词;点击"✨ Enhance Prompt(Optional)"按已配置的 LLM 接口润色并覆盖原提示词。
- Inference Seed:正整数复现种子,
-1为随机种子。 - Super-Resolution:720×480 → 2880×1920,基于 Real-ESRGAN;默认关闭。
- Frame Interpolation:8fps → 16fps,基于 RIFE;默认关闭。
- 点击"🎬 Generate Video"生成;右侧输出 720×480 视频,并提供 MP4 与 GIF 下载。
- 演示内采样步数固定为
50、CFG 固定为7.0(app.py中num_inference_steps=50、guidance_scale=7.0,注释标注 NOT Changed);需要调整步数与引导系数请走第 7.3 节 CLI。
6.5 远程访问与临时文件说明
- 7860 为 Gradio 默认端口;被占用时可在源码
demo.launch()处指定server_port,或通过反向代理映射。 - 应用后台任务每 10 分钟清理过期临时文件;
GRADIO_TEMP_DIR指向的目录需保证读写权限与剩余磁盘空间。 - 演示模型固定为
THUDM/CogVideoX-5b;切换 2B、1.5-5B 或 I2V 模型需修改app.py中MODEL常量并核对对应 pipeline 类型,参数兼容性以源码为准。
7 方式二:Diffusers 源码环境手动安装与 CLI 推理
7.1 安装主分支依赖
git clone https://github.com/THUDM/CogVideo.git
cd CogVideo

# 创建 Python 3.10–3.12 独立虚拟环境后
pip install -r requirements.txt
如安装阶段 diffusers 接口不匹配,以根目录
requirements.txt 公布的
diffusers>=0.35.2、transformers>=4.57.1、accelerate>=1.11.0
为准,不要混用微调目录要求的源码 diffusers 版本(见第 7.7 节)。
7.2 模型权重下载
CLI 的 --model_path 直接接收 Hugging Face 模型仓库
ID,from_pretrained 会自动下载到本地缓存;网络无法访问
Hugging Face 时,可从 ModelScope 或 WiseModel
对应模型卡手动下载后指向本地文件夹:
| 任务 | 模型仓库 ID(Diffusers) |
|---|---|
| T2V(1.5) | THUDM/CogVideoX1.5-5B |
| I2V(1.5) | THUDM/CogVideoX1.5-5B-I2V |
| T2V(2B) | THUDM/CogVideoX-2b |
| T2V(5B) | THUDM/CogVideoX-5b |
| I2V(5B) | THUDM/CogVideoX-5b-I2V |
| V2V | 2B / 5B / 1.5-5B 主模型均可 |
手动放置时保持 Diffusers
标准目录结构(transformer/、vae/、text_encoder/、tokenizer/、scheduler/
等子目录);SAT 格式权重不能直接传给 Diffusers pipeline,需先经
tools/convert_weight_sat2hf.py 转换。
7.3 CLI
推理(inference/cli_demo.py)
7.3.1 文生视频(T2V,默认 1.5-5B)
python inference/cli_demo.py \
  --prompt "A girl riding a bike." \
  --model_path THUDM/CogVideoX1.5-5B \
  --generate_type "t2v" \
  --output_path ./output.mp4
7.3.2 文生视频(5B 与 2B)
# CogVideoX-5B
python inference/cli_demo.py \
  --prompt "A suited astronaut shakes hands with a blue alien on Mars, a silver rocket stands behind." \
  --model_path THUDM/CogVideoX-5b \
  --generate_type "t2v" \
  --num_inference_steps 50 \
  --guidance_scale 6.0 \
  --output_path ./output_5b.mp4

# CogVideoX-2B(建议搭配 DDIM 调度器,源码中可切换)
python inference/cli_demo.py \
  --prompt "A garden comes to life as butterflies flutter amidst blossoms, a grand fountain cascades in the background." \
  --model_path THUDM/CogVideoX-2b \
  --generate_type "t2v" \
  --dtype float16 \
  --output_path ./output_2b.mp4
7.3.3 图生视频(I2V)
python inference/cli_demo.py \
  --prompt "The camera slowly pans across the garden, butterflies flying between flowers." \
  --model_path THUDM/CogVideoX-5b-I2V \
  --generate_type "i2v" \
  --image_or_video_path /path/to/image.jpg \
  --output_path ./output_i2v.mp4
7.3.4 视频续写(V2V)
python inference/cli_demo.py \
  --prompt "The scene continues into the next moment with smooth motion." \
  --model_path THUDM/CogVideoX-5b \
  --generate_type "v2v" \
  --image_or_video_path /path/to/reference.mp4 \
  --output_path ./output_v2v.mp4
7.3.5 挂载 LoRA 权重
python inference/cli_demo.py \
  --prompt "..." \
  --model_path THUDM/CogVideoX-5b \
  --lora_path /path/to/lora \
  --lora_rank 128 \
  --generate_type "t2v" \
  --output_path ./output_lora.mp4
cli_demo.py 内 LoRA 加载固定读取
pytorch_lora_weights.safetensors,并在 Transformer 上
fuse_lora(..., lora_scale=1.0);LoRA 文件名与结构以
tools/load_cogvideox_lora.py 与微调产出为准。
7.3.6 内存优化开关(源码
generate_video)
默认开启:
pipe.enable_sequential_cpu_offload()
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
显存充足或多 GPU 时,可按源码注释改为
pipe.enable_model_cpu_offload() 提速,或直接
pipe.to("cuda");多 GPU 场景需在
from_pretrained 中加入 device_map="balanced"
并移除 CPU offload 调用(源码注释口径)。
7.4
量化推理(inference/cli_demo_quantization.py)
# INT8(小显存设备,NVIDIA 显卡)
python inference/cli_demo_quantization.py \
  --prompt "A girl riding a bike." \
  --model_path THUDM/CogVideoX-2b \
  --quantization_scheme int8 \
  --dtype float16 \
  --output_path ./output_int8.mp4

# FP8(仅 H100 及以上,需源码安装 torch 与 torchao,CUDA 12.4)
python inference/cli_demo_quantization.py \
  --prompt "A girl riding a bike." \
  --model_path THUDM/CogVideoX-5b \
  --quantization_scheme fp8 \
  --dtype bfloat16 \
  --output_path ./output_fp8.mp4
量化脚本对文本编码器、Transformer、VAE 分别调用
quantize_ 或 quantize_to_float8;量化方案只在
Diffusers 版权重上可用。
7.5 SAT
权重推理(sat/README.md)
SAT 路径面向使用官方 SAT 检查点做堆叠式二次开发的研究人员,与 Diffusers 路径相互独立。
7.5.1 环境与权重
cd sat
pip install -r requirements.txt

# CogVideoX1.5-5B SAT 权重(含 Transformer、VAE、T5 编码器)
git lfs install
git clone https://huggingface.co/THUDM/CogVideoX1.5-5B-SAT
CogVideoX-2B 与 5B 的 SAT 权重按 sat/README.md
提供的清华云盘渠道下载,并整理为如下结构:
.
├── transformer
│   ├── 1000 (or 1)
│   │   └── mp_rank_00_model_states.pt
│   └── latest
└── vae
    └── 3d-vae.pt
T5 编码器从 THUDM/CogVideoX-2b(或 ModelScope
同名仓库)复制 text_encoder/ 与 tokenizer/
内容到 t5-v1_1-xxl/ 目录,供 Deepspeed 微调时无错误加载
safetensor 格式 T5 文件。
7.5.2 配置与启动
- 修改
configs/cogvideox_*.yaml:核对 T5 目录model_dir、VAE 路径ckpt_path与网络结构参数; - 修改
configs/inference.yaml:设置load绝对路径、input_type(txt文本文件或cli命令行输入)、input_file、sampling_num_frames、sampling_fps、fp16/bf16、output_dir; - 运行:
bash inference.sh帧数口径(configs/inference.yaml 注释):CogVideoX1.5-5B
必须为 42 或 22;CogVideoX-5B / 2B 为
13、11 或 9。2B 使用
fp16: True,5B 使用 bf16: True。
7.5.3 SAT 微调与权重导出
- 数据集按
labels/<同名>.txt与videos/<同名>.mp4一一对应组织;风格微调建议至少准备 50 个同风格视频与标注。 - 支持 LoRA 与全参数两种方式,仅微调 Transformer;单卡 / 多卡脚本为
finetune_single_gpu.sh、finetune_multi_gpus.sh,配置位于configs/sft.yaml与configs/cogvideox_*_lora.yaml。 - SAT 权重与 Hugging Face 格式不同,用
tools/convert_weight_sat2hf.py转换;SAT LoRA 导出到 Diffusers 格式用tools/export_sat_lora_weight.py,推理加载用tools/load_cogvideox_lora.py。
7.6 原版 CogVideo 分支(ICLR'23 遗留流水线,独立环境)
以下内容仅对应
CogVideo分支,不要在主分支 CogVideoX 环境中执行;该分支仅支持简体中文输入,官方建议 A100 显卡。
git clone -b CogVideo https://github.com/THUDM/CogVideo.git
cd CogVideo

pip install -r requirements.txt
# 编译 LocalAttention 内核
pip install git+https://github.com/Sleepychord/Image-Local-Attention
模型权重通过环境变量 SAT_HOME
指定目录存放,可自动下载或手动放置:cogvideo-stage1、cogvideo-stage2、cogview2-dsr(Stage1
/ Stage2 / CogView2 DSR)。
# 官方推理脚本(交互式命令行输入)
SAT_HOME=/path/to/weights bash scripts/inference_cogvideo_pipeline.sh
脚本主要参数(分支 README 与 cogvideo_pipeline.py
口径):
| 参数 | 说明 |
|---|---|
--input-source |
提示词文件路径,或 interactive 启动命令行交互 |
--output-path |
结果输出目录 |
--batch-size |
每条提示词生成样本数 |
--max-inference-batch-size |
单次前向最大批大小,OOM 时调小 |
--stage1-max-inference-batch-size |
Stage 1 单次前向最大批大小,OOM 时调小 |
--both-stages |
顺序执行 Stage1 与 Stage2 |
--use-guidance-stage1 |
Stage1 启用分类器引导,官方强烈建议开启以改善结果 |
分支遗留 Docker
脚本(build_image.sh、run_image.sh):
./build_image.sh        # docker build -t cog .(基础镜像 nvidia/cuda:11.3.1-cudnn8-devel-ubuntu20.04)
./run_image.sh          # docker run --rm --name cog -it --gpus all -v "${PWD}":/workspace cog
该 Dockerfile 基于 CUDA 11.3、SAT 0.2.9 与
icetk、gifmaker等老旧依赖,仅服务原版 CogVideo 复现;不要把它当作 CogVideoX 的官方容器方案。
7.7 Diffusers
版微调入口(finetune/README.md)
- 硬件门槛(官方表格摘要):2B LoRA(rank128)fp16、49×480×720 约 16GB
显存(NVIDIA 4080);5B LoRA bf16 约 24GB(4090);1.5 系列 LoRA
bf16、81×768×1360 约 35GB(A100);全参数 SFT 显存需求见
finetune/README.md表格。 - 依赖:微调代码尚未合入官方 diffusers 发布版,需先
git clone https://github.com/huggingface/diffusers.git并pip install -e .安装主分支。 - 数据集目录:
prompts.txt、videos/、videos.txt;I2V 可选images/、images.txt,缺省时取视频首帧作参考。 - 2025-03-24 起官方推荐迁移到 CogKit 开展后续微调与推理工作。
7.8
提示词润色(inference/convert_demo.py)
# 文生视频:短句扩写为英文长描述
python inference/convert_demo.py --prompt "A girl riding a bike." --type "t2v"

# 图生视频:结合参考图生成英文描述
python inference/convert_demo.py \
  --prompt "the cat is running" \
  --type "i2v" \
  --image_path /path/to/image.jpg
脚本默认使用 OpenAI() 客户端读取
OPENAI_API_KEY / OPENAI_BASE_URL;T2V 模型为
glm-4-plus,I2V 视觉模型为
gpt-4o;--retry_times 默认 3
次重试。润色后的英文提示词再交给视频模型推理;未配置密钥时脚本直接返回原始提示词。
8 配置项说明
8.1
cli_demo.py 命令行参数(来自源码
argparse)
| 参数 | 默认值 | 说明 |
|---|---|---|
--prompt |
必填 | 视频英文提示词 |
--image_or_video_path |
None |
I2V 参考图或 V2V 参考视频路径 |
--model_path |
THUDM/CogVideoX1.5-5B |
预训练模型仓库 ID 或本地文件夹 |
--lora_path |
None |
LoRA 权重目录路径 |
--lora_rank |
128 |
LoRA 秩 |
--output_path |
./output.mp4 |
生成视频保存路径 |
--guidance_scale |
6.0 |
分类器自由引导系数,越高越贴合提示词 |
--num_inference_steps |
50 |
推理步数,步数更多通常画质更好、耗时更长 |
--num_frames |
81 |
生成帧数;1.5 系列 16N+1(N≤10),2B/5B/5B-I2V 为 8N+1(N≤6) |
--width |
None |
输出宽度;仅 1.5-5B-I2V 支持自定义,其他模型回落到推荐分辨率 |
--height |
None |
输出高度;同上 |
--fps |
16 |
输出帧率;1.5 系列 16fps,2B/5B/5B-I2V 为 8fps |
--num_videos_per_prompt |
1 |
每条提示词生成视频数 |
--generate_type |
t2v |
t2v / i2v / v2v |
--dtype |
bfloat16 |
bfloat16 或 float16;2B 用 float16,5B 与
1.5 系列用 bfloat16 |
--seed |
42 |
随机种子,用于复现 |
8.2 Pipeline 与调度器参数
| 配置项 | 取值 / 说明 |
|---|---|
| 调度器 | CogVideoXDPMScheduler(5B / 5B-I2V
推荐);CogVideoXDDIMScheduler(2B
推荐);timestep_spacing="trailing" |
use_dynamic_cfg |
DPM 调度器为 True;DDIM 调度器应为
False |
推荐分辨率映射 RESOLUTION_MAP |
cogvideox1.5-5b-i2v、cogvideox1.5-5b:768×1360
口径;cogvideox-5b-i2v、cogvideox-5b、cogvideox-2b:480×720
口径(代码内按 (height, width) 解析) |
| 内存优化 | enable_sequential_cpu_offload()、vae.enable_slicing()、vae.enable_tiling();多
GPU 关闭序列式 CPU offload |
| 动态引导 | use_dynamic_cfg=True 配合
DPM;num_videos_per_prompt 控制批量样本数 |
| 输出编码 | export_to_video(video_generate, output_path, fps=fps) |
8.3 Gradio
演示控件(app.py 口径)
| 控件 | 默认 / 范围 | 说明 |
|---|---|---|
| 模型常量 | THUDM/CogVideoX-5b |
源码 MODEL 常量,启动时加载 T2V / V2V / I2V 三条
pipeline |
| 图片输入 | 上传即裁剪 720×480 | I2V 参考图,与视频输入互斥 |
| 视频输入 | 截取前 49 帧(6 秒、8fps) | V2V 参考视频,与图片输入互斥 |
| Strength | 0.1–1.0,默认 0.8 |
V2V 重绘强度 |
| Prompt | 少于 200 词 | 提示词文本框,5 行 |
| Enhance Prompt | 按钮 | 配置 OPENAI_API_KEY 后调用 GLM-4
润色并覆盖原提示词 |
| Inference Seed | 默认 -1(随机) |
正整数复现种子 |
| Super-Resolution | 默认关闭 | Real-ESRGAN,720×480 → 2880×1920 |
| Frame Interpolation | 默认关闭 | RIFE,8fps → 16fps |
| 采样步数 / CFG | 固定 50 / 7.0 | 演示内硬编码,CLI 可调整 |
| 输出 | 720×480 视频 + GIF | 下载按钮在生成后可见 |
8.4 CogVideoX 模型家族对照(README Model Introduction)
| 项目 | 1.5-5B | 1.5-5B-I2V | CogVideoX-2B | CogVideoX-5B | CogVideoX-5B-I2V |
|---|---|---|---|---|---|
| 发布日期 | 2024-11-08 | 2024-11-08 | 2024-08-06 | 2024-08-27 | 2024-09-19 |
| 视频分辨率 | 1360×768 | min(W,H)=768,768≤max(W,H)≤1360,长边被 16
整除 |
720×480 | 720×480 | 720×480 |
| 帧数 | 16N+1,N≤10,默认 81 | 16N+1,N≤10,默认 81 | 8N+1,N≤6,默认 49 | 8N+1,N≤6,默认 49 | 8N+1,N≤6,默认 49 |
| 推理精度 | BF16 推荐;FP16 / FP32 / FP8* / INT8;不支持 INT4 | 同左 | FP16 推荐;BF16 / FP32 / FP8* / INT8;不支持 INT4 | BF16 推荐;FP16 / FP32 / FP8* / INT8;不支持 INT4 | 同左 |
| 显存(SAT / Diffusers / INT8) | 76GB BF16 / 10GB 起 BF16 / 7GB 起 INT8 | 同左 | 18GB FP16 / 4GB 起 FP16 / 3.6GB 起 INT8 | 26GB BF16 / 5GB 起 BF16 / 4.4GB 起 INT8 | 同 5B |
| 多 GPU 显存 | BF16 24GB(Diffusers) | BF16 24GB | FP16 10GB | BF16 15GB | BF16 15GB |
| 速度(50 步) | A100 约 1000 秒 / H100 约 550 秒(5 秒视频) | 同左 | A100 约 90 秒 / H100 约 45 秒 | A100 约 180 秒 / H100 约 90 秒 | 同 5B |
| 提示词语言 | 英文 | 英文 | 英文 | 英文 | 英文 |
| 提示词 Token 上限 | 224 | 224 | 226 | 226 | 226 |
| 视频时长 | 5 秒或 10 秒 | 5 秒或 10 秒 | 6 秒 | 6 秒 | 6 秒 |
| 帧率 | 16 fps | 16 fps | 8 fps | 8 fps | 8 fps |
| 位置编码 | 3d_rope_pos_embed | 3d_rope_pos_embed | 3d_sincos_pos_embed | 3d_rope_pos_embed | 3d_rope_pos_embed + learnable_pos_embed |
8.5 SAT
推理配置关键字段(sat/configs/inference.yaml)
| 字段 | 说明 |
|---|---|
args.latent_channels |
潜通道数,官方示例 16 |
args.mode |
inference 推理模式 |
args.load |
Transformer 权重文件夹绝对路径;LoRA 场景指向对应目录 |
args.batch_size |
推理批大小,1 |
args.input_type |
txt 文本文件;cli 命令行输入 |
args.input_file |
提示词文本文件路径,每行一条提示词 |
args.sampling_num_frames |
1.5-5B 取 42 或 22;5B / 2B 取
13、11 或 9 |
args.sampling_fps |
官方示例 8 |
args.fp16 / args.bf16 |
2B 开 fp16;5B 开 bf16 |
args.output_dir |
结果输出目录,默认 outputs/ |
args.force_inference |
强制进入推理流程 |
configs/cogvideox_*.yaml
内网络结构字段包括:scale_factor、disable_first_stage_autocast、denoiser_config、network_config(num_frames、time_compressed_rate、latent_width/height、num_layers、patch_size、hidden_size、num_attention_heads
等)、conditioner_config(FrozenT5Embedder,model_dir
指向 T5
目录,max_length: 226)、first_stage_config(3D
VAE
ckpt_path: CogVideoX-2b-sat/vae/3d-vae.pt)、sampler_config(VPSDEDPMPP2MSampler,num_steps: 50,DynamicCFG,scale: 6,exp: 5)。
8.6 环境变量汇总
| 变量 | 路径 | 用途 |
|---|---|---|
OPENAI_API_KEY |
Gradio 演示 / convert_demo.py |
外部 LLM 客户端密钥;缺失时提示词润色自动跳过 |
OPENAI_BASE_URL |
同上 | 兼容 OpenAI 协议的接口基址 |
GRADIO_TEMP_DIR |
Gradio 演示 | 临时文件目录,建议显式设置 |
SAT_HOME |
原版 CogVideo 分支 | 原版模型权重根目录(CogVideoX SAT 路径不使用该变量) |
9 常用运维命令
# 进入仓库目录
cd CogVideo

# 激活虚拟环境(按实际环境管理器替换)
conda activate cogvideox
# 或
source venv/bin/activate

# 退出环境
conda deactivate

# 重新安装主分支依赖(修改 requirements.txt 后)
pip install -r requirements.txt

# Gradio 演示
cd inference/gradio_composite_demo
python app.py
cd ../../

# CLI 文生视频示例
python inference/cli_demo.py \
  --prompt "A garden fountain with butterflies." \
  --model_path THUDM/CogVideoX-2b \
  --generate_type t2v \
  --output_path ./output.mp4

# 查看 CLI 参数帮助
python inference/cli_demo.py -h
python inference/cli_demo_quantization.py -h

# 查看生成结果
ls -lh ./output.mp4

# 查看占用 7860 端口的进程(Linux)
ss -lntp | grep 7860
# 或
lsof -i :7860

# 查看 Python / Gradio / CLI 进程
ps -ef | grep -E "app.py|cli_demo" | grep -v grep更新代码:git pull 后按根目录
requirements.txt 重新安装依赖;CogVideoX 系列模型权重随仓库
README 模型表同步更新,升级后核对模型卡版本与微调 LoRA 兼容性。
备份:保存自定义提示词文本、微调 LoRA
目录、outputs/ 与 Gradio
生成结果;下载的第三方模型权重不要提交到公开仓库;备份时同时保留环境清单(pip freeze > freeze.txt)。
停止与重启:终端 Ctrl + C 终止 Gradio
或 CLI 进程;需要后台常驻时可用 tmux、nohup
或系统服务托管,并把日志重定向到文件便于排查。SAT 路径通过
bash inference.sh
启动,bash finetune_single_gpu.sh /
bash finetune_multi_gpus.sh 启动微调。
10 常见故障排查
10.1 CUDA out of memory(显存不足)
现象:加载 pipeline 或采样阶段报
CUDA out of memory。
处理:
- 确认已开启默认三项优化:
enable_sequential_cpu_offload()、vae.enable_slicing()、vae.enable_tiling();未开启时显存峰值约为表内 3 倍。 - 改用 INT8
量化脚本(
cli_demo_quantization.py --quantization_scheme int8),对照第 5.2 节显存口径选择 2B / 5B 模型。 - 降低
--num_frames、--num_inference_steps与--num_videos_per_prompt;1.5 系列分辨率高,先在 2B / 5B 上跑通流程。 - 清理其他显存占用进程:
nvidia-smi- 显存余量充足时,可把
enable_sequential_cpu_offload()改为enable_model_cpu_offload()或.to("cuda")提速;多 GPU 时必须关闭序列式 CPU offload。 - 仍不足时设置显存分配切分参数后重试:
export PYTORCH_CUDA_ALLOC_CONF=max_split_size_mb:128
python inference/cli_demo.py ...
10.2 模型下载失败 / 缓存损坏
现象:from_pretrained
卡在下载、报校验错误,或权重文件大小为 0。
处理:
- 改用 ModelScope / WiseModel
对应模型卡手动下载,
--model_path指向本地文件夹。 - 删除 Hugging Face
缓存中对应仓库的半成品目录后重新下载,避免断点残留导致加载阶段报
unexpected EOF。 - 检查本地目录是否保持 Diffusers 标准子目录结构;SAT 权重不能直接传给 Diffusers pipeline。
10.3 依赖版本冲突(diffusers / transformers / torch)
现象:ImportError、pipeline
类或调度器参数不存在、注意力处理器报错。
处理:
- 主分支推理严格按根目录
requirements.txt口径:diffusers>=0.35.2、transformers>=4.57.1、accelerate>=1.11.0、numpy==1.26.0、torch>=2.8.0。 - 微调环境需单独按
finetune/README.md安装源码版 diffusers,不要与推理环境混用。 - SAT 路径使用独立虚拟环境,依赖
sat/requirements.txt(含 deepspeed、pytorch_lightning、kornia 等)。 - 出现 numpy 版本报错时核对
numpy==1.26.0与其他已安装库的兼容性。
10.4 FP8 不可用
现象:FP8 量化报算子不支持、硬件不匹配或
torchao / torch 安装报错。
处理:FP8 仅限 NVIDIA H100 及以上设备;需从源码安装
torch、torchao,推荐 CUDA 12.4;其他设备改用
INT8 或 BF16 / FP16 常规精度。
10.5 提示词非英文导致效果差
现象:中文提示词生成画面与描述脱节、语义错乱。
处理:CogVideoX 仅支持英文输入;先用
convert_demo.py 或其他翻译 /
润色工具把中文短句转换为英文长描述,再作为 --prompt
输入。注意 Token 上限:1.5 系列 224 Tokens,2B / 5B 系列 226
Tokens;Gradio 演示提示词不超过 200 词。
10.6 帧数 / 分辨率不合法
现象:脚本回落到默认分辨率、输出警告,或 VAE / 注意力维度报错。
处理:
- 1.5 系列帧数必须满足
16N+1(N ≤ 10);2B / 5B / 5B-I2V 必须满足8N+1(N ≤ 6)。 - 自定义宽高仅 1.5-5B-I2V 支持,且需满足
min(W,H)=768、768 ≤ max(W,H) ≤ 1360、长边被 16 整除;其他模型传--width/--height会被脚本忽略并回落到推荐分辨率。 - SAT 路径
sampling_num_frames按第 8.5 节口径填写。
10.7 调度器与动态 CFG 不匹配
现象:画面引导偏弱、过曝或提示词对齐差。
处理:2B 使用 CogVideoXDDIMScheduler 且
use_dynamic_cfg=False;5B / 5B-I2V 使用
CogVideoXDPMScheduler 且
use_dynamic_cfg=True;不要把 DPM 调度器配置给 2B
旧模型。
10.8 视频写出失败(imageio / ffmpeg / moviepy)
现象:采样完成但 MP4 / GIF 保存报错,输出目录为空。
处理:
- 确认
imageio、imageio-ffmpeg、moviepy、scikit-video已按requirements.txt安装;系统ffmpeg在PATH中。 - 检查输出目录与
GRADIO_TEMP_DIR的写权限与剩余磁盘空间;临时目录被占用时先清理旧文件。 - 路径中避免特殊字符与权限受限目录;中文路径在部分组件上可能解码异常。
10.9 Enhance Prompt 按钮无反应
现象:点击后提示词未被改写,也无报错。
处理:app.py 检测到未设置
OPENAI_API_KEY 时直接返回原提示词;按第 6.2
节配置环境变量后重启应用。注意接口模型名(glm-4-plus、gpt-4o)与
OPENAI_BASE_URL 指向的服务能力需匹配。
10.10 SAT 配置路径与 T5 编码器缺失
现象:SAT 启动报 T5 目录缺失、VAE 权重找不到或检查点键不匹配。
处理:
- 按第 7.5.1 节整理 Transformer、VAE、
t5-v1_1-xxl目录结构;configs/cogvideox_*.yaml中model_dir与ckpt_path使用绝对路径。 - 2B 开
fp16、5B 开bf16;微调产出的 SAT LoRA 需先经export_sat_lora_weight.py导出为 Diffusers 格式再在 HF pipeline 中加载。
10.11 端口被占用
现象:Gradio 启动报
Address already in use。
处理:
ss -lntp | grep 7860
# 终止占用进程,或在 app.py 的 demo.launch() 中指定 server_port
10.12 原版分支与主分支混用报错
现象:在主分支环境运行 CogVideo
分支脚本,或把原版权重接入 CogVideoX pipeline 后报形状 / 键名错误。
处理:两代模型权重、依赖、提示词语言与流水线结构互不兼容;原版
CogVideo 必须克隆 CogVideo
分支、独立环境、SAT_HOME
权重目录与中文提示词,不要与主分支共用 Python 环境与模型缓存。
11 风险与合规说明
11.1 许可证分档(官方 README Model-License 口径)
- 仓库代码:Apache 2.0(根目录
LICENSE)。 - CogVideoX-2B 模型(含对应 Transformer 模块与 VAE 模块):Apache 2.0。
- CogVideoX-5B 模型(Transformer 模块,含 I2V 与
T2V):按 CogVideoX
License 分发,主要条款如下:
- 授予非排他、全球、不可转让、不可再许可、可撤销、免版税版权许可;生成内容的知识产权在适用当地法律允许范围内归用户所有。
- 可免费用于学术研究;商用须在
https://open.bigmodel.cn/mla/form登记并取得基础商用授权;取得授权后可免费开展商业活动,但商业活动服务用户数(访问量)不得超过每月 100 万次;超出须联系官方商务团队获取更多商用授权。 - 不得出于军事或非法目的使用、复制、修改、合并、发布、分发或创建衍生作品;不得从事危害国家安全与国家统一、危害社会公共利益、侵犯人身权益的行为。
- 软件按"原样"提供,不提供明示或默示保证;争议适用中华人民共和国法律,提交北京市海淀区人民法院管辖;许可证可能更新,许可与版权问题联系
license@zhipuai.cn。
- 1.5 系列、5B-I2V 等其他 5B 量级模型的模型卡许可证以对应 Hugging Face / ModelScope 页面为准;集成 T5 编码器、3D VAE、RIFE、Real-ESRGAN 等第三方组件时需同时核对各自许可证。
11.2 模型版权与第三方素材
- 模型权重来自官方模型卡分发;微调 LoRA、第三方改造流水线(CogVideoX-Fun、ComfyUI-Wrapper、cogvideox-factory 等)的许可与兼容性由对应仓库与作者负责。
- 提示词中出现的真人姓名、品牌、角色、艺术风格受各自权利约束;不要在未授权前提下生成可识别真人、受版权保护角色或品牌标识的视频。
- 演示中使用的 RIFE 帧插值、Real-ESRGAN 超分、OpenAI 兼容 LLM 接口等属于独立第三方组件,商用前核对各自条款。
11.3 生成内容合规
- 不得利用模型生成军事用途、违法犯罪、色情、暴力、恐怖、仇恨歧视、深度伪造欺骗、虚假新闻或侵害他人肖像权、名誉权、著作权的内容。
- 对外发布 AI 生成视频时,应按当地法规标注 AI 合成属性;用于广告、影视、新闻等公开场景前,应完成内容审核与权利审查。
- 官方在线演示标注"仅供学术研究与体验使用";商业产品化前须完成模型授权登记、内容审核机制建设与风险评估,相关责任由部署方承担。
11.4 数据隐私与服务边界
- 本地 Diffusers / SAT 推理默认在本机运行,提示词、参考图、参考视频与生成结果保存在本地;接入在线 Space、Colab 或第三方托管演示时,需遵守对应平台数据政策,不要上传敏感个人信息与未授权素材。
- 启用提示词润色会把文本(I2V 场景含参考图 Base64)发送到外部 LLM
接口;关闭
OPENAI_API_KEY可跳过该外发环节。 - 清影(QingYing)与开放平台 API 属于更大规模商用模型服务,与开源权重为不同产品,其服务条款、配额与隐私政策以平台页面为准;README 链接仅作官方入口对照。
- 仓库主分支未提供官方 Docker 与托管 SLA;第三方镜像、一键部署 Space 与社区框架不属于官方产物,安全性与版本兼容性由维护者负责。
11.5 免责声明
本指南依据官方公开文档整理,命令、参数、端口、依赖版本、显存数值与模型渠道均来自仓库
README、requirements.txt、inference/cli_demo.py、inference/cli_demo_quantization.py、inference/convert_demo.py、inference/gradio_composite_demo/app.py、sat/README.md、finetune/README.md、工具脚本与
CogVideo 分支
README;官方后续版本可能调整依赖版本、模型渠道、界面参数、量化方案与许可证条款,部署时以仓库最新说明为准。作者与本文不对因使用、修改或运行本项目产生的直接或间接损失承担责任,法律不得排除或限制的责任除外。